ESP32 雙核心架構與 FreeRTOS 工作分配
很多人第一次聽到 ESP32 是雙核心,反應都是「那是不是寫起來會變兩倍快?」這篇就是要回答這個問題 —— 答案是有機會,但前提是你得先搞懂哪些事可以並行、哪些事註定要排隊。
ESP32 搭載 兩個 Xtensa LX6 核心(PRO_CPU 與 APP_CPU),各以 240 MHz 獨立運作,共享同一記憶體空間和周邊匯流排。把工作正確地分配到兩個核心(Task Pinning),確實能明顯改善 IoT 設備的整體效能與回應速度;但分配錯了,就只是多花了一堆堆疊空間而已。
本文依序會走過:
- ESP32 雙核心硬體架構
- xTaskCreatePinnedToCore API
- 核心間通訊(IPC):Queue、Semaphore、Mutex
- Task Notification(最快 IPC)
- IRAM 與 Cache 衝突
- 實戰案例:感測器 + Wi-Fi + 控制迴圈
硬體架構
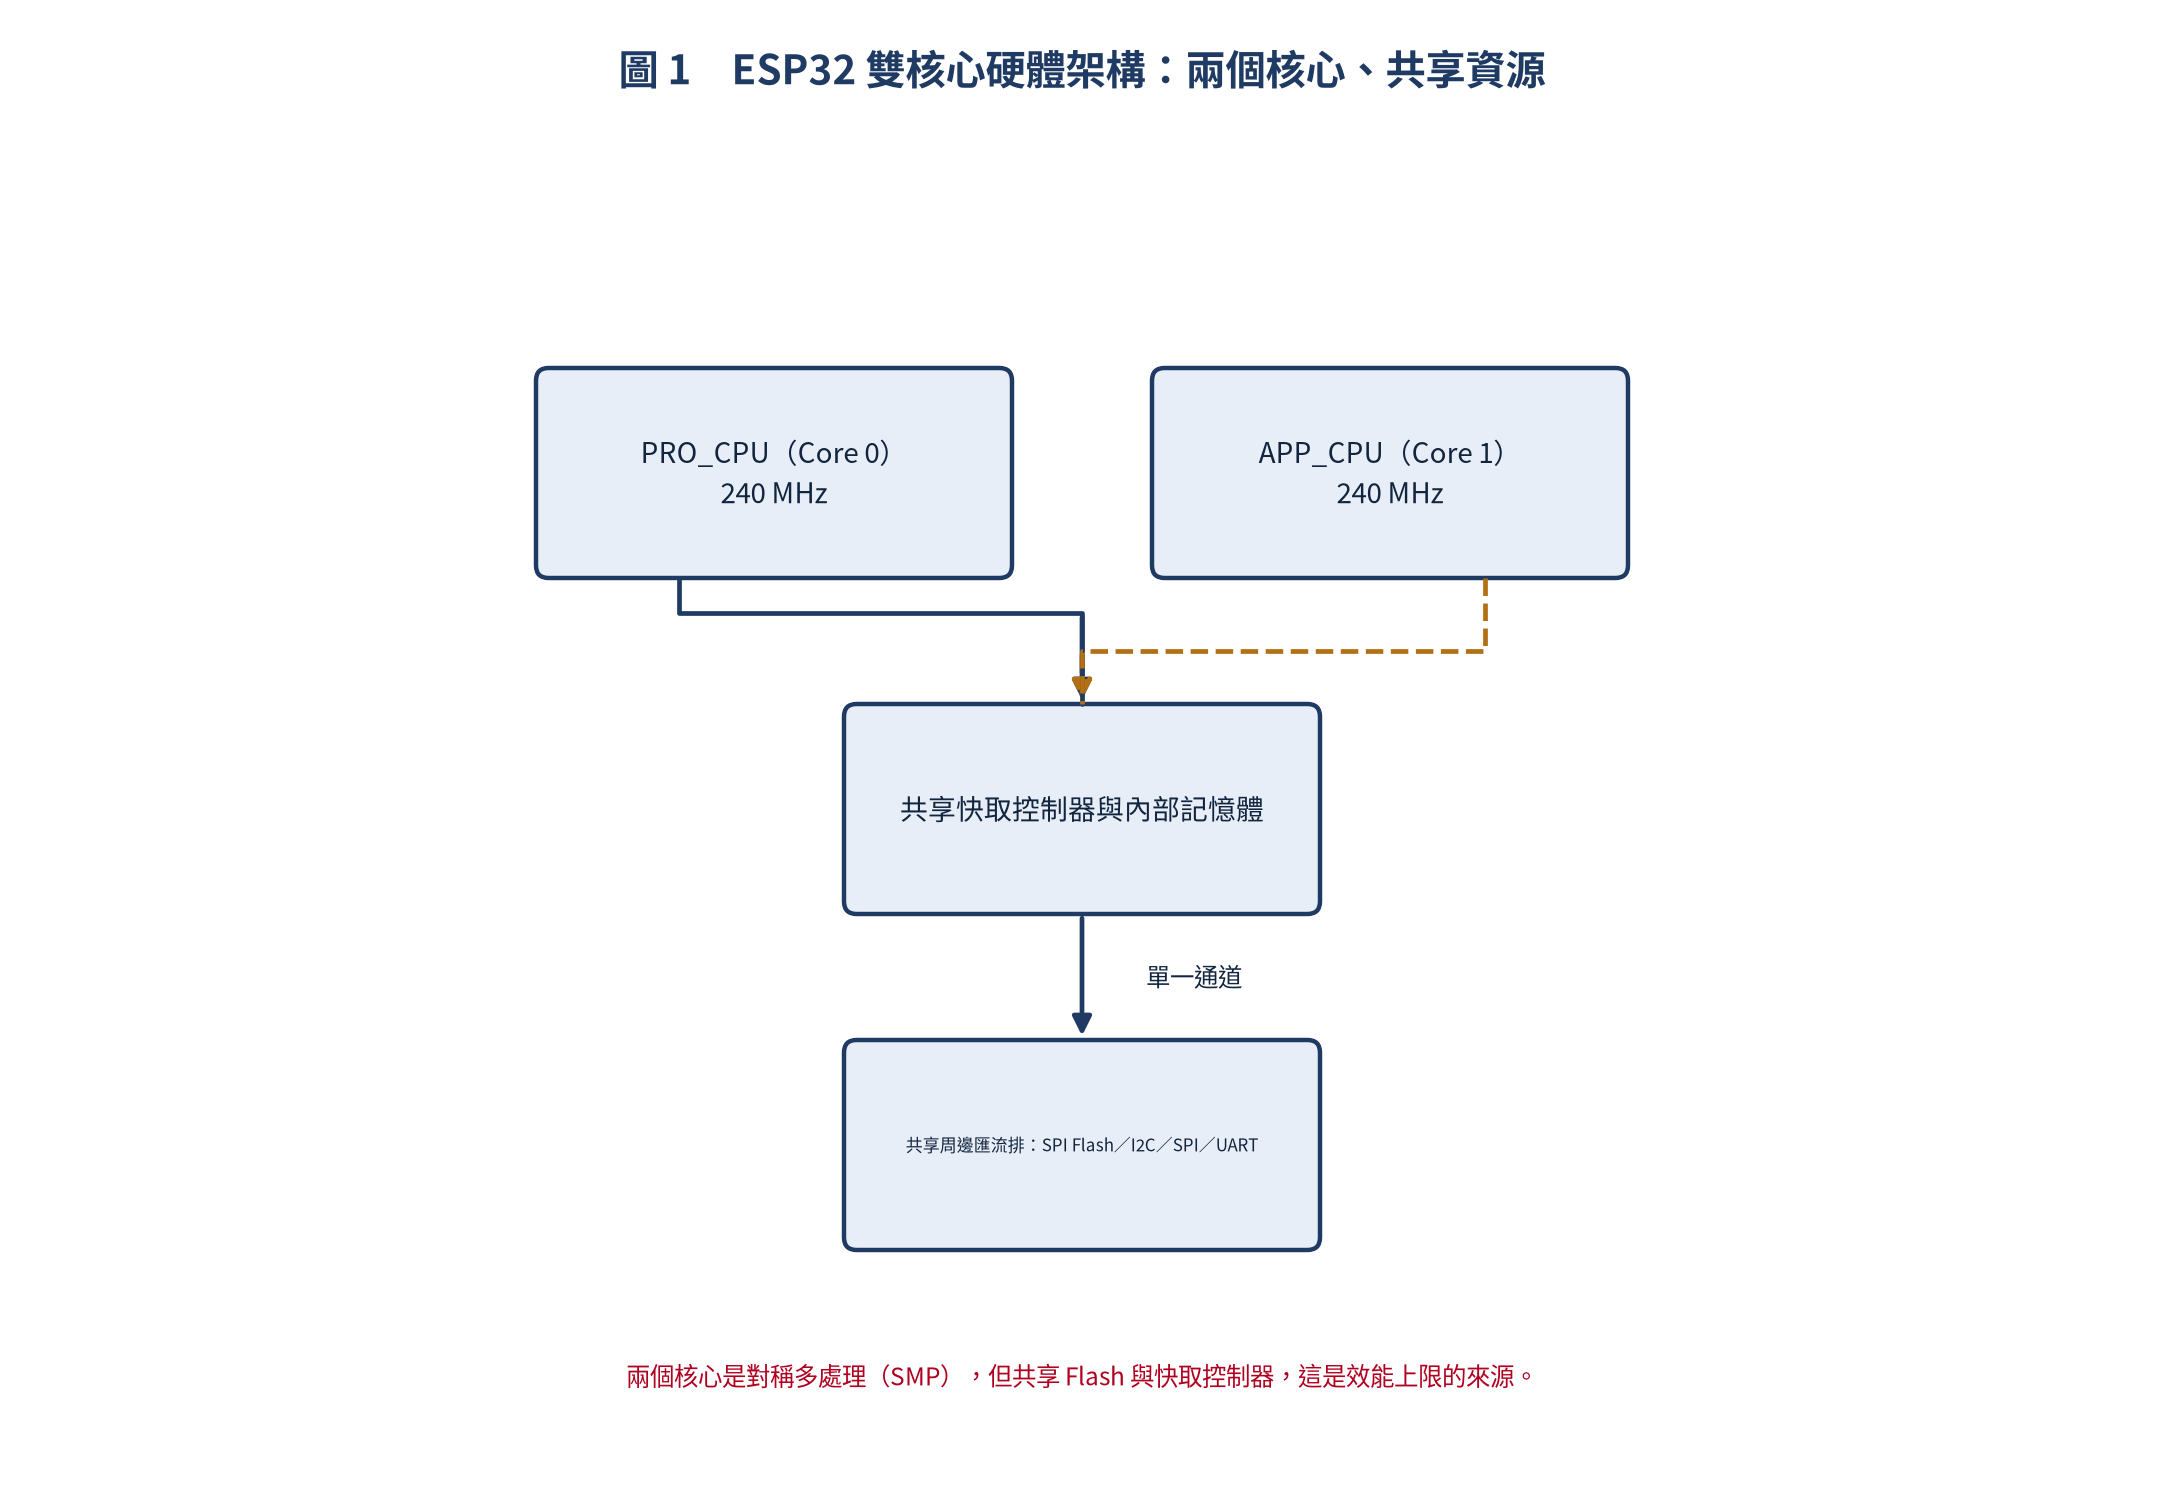
先看硬體。兩個核心是對稱的,各自有獨立的快取,但底下接的是同一份資源:
核心分工
雖然兩個核心規格對稱,但 ESP32 生態系的慣例是把它們分工使用:
| 特性 | PRO_CPU (Core 0) | APP_CPU (Core 1) |
|---|---|---|
| 預設用途 | WiFi/BT 協定棧、Arduino loop() | 使用者任務(xTaskCreate) |
| 快取 | 16 KB I-Cache + 16 KB D-Cache | 16 KB I-Cache + 16 KB D-Cache |
| IRAM 區段 | 0x40080000 - 0x400A0000 | 0x400A0000 - 0x400C0000 |
| 中斷 | 所有中斷預設路由至此 | 可設定中斷路由 |
| 典型任務 | TCP/IP、MQTT、HTTP Server | 感測器輪詢、PID 控制、LCD 顯示 |
重要限制:兩個核心共享同一條 SPI Flash 匯流排和快取控制器。如果兩個核心同時觸發快取未命中(Cache Miss),Flash 讀取會序列化,造成效能下降。這就是為什麼 CPU 使用率不會單純翻倍。
雙核心排程範例
實際跑起來長什麼樣子?下圖把兩個核心的工作攤在同一條時間軸上:
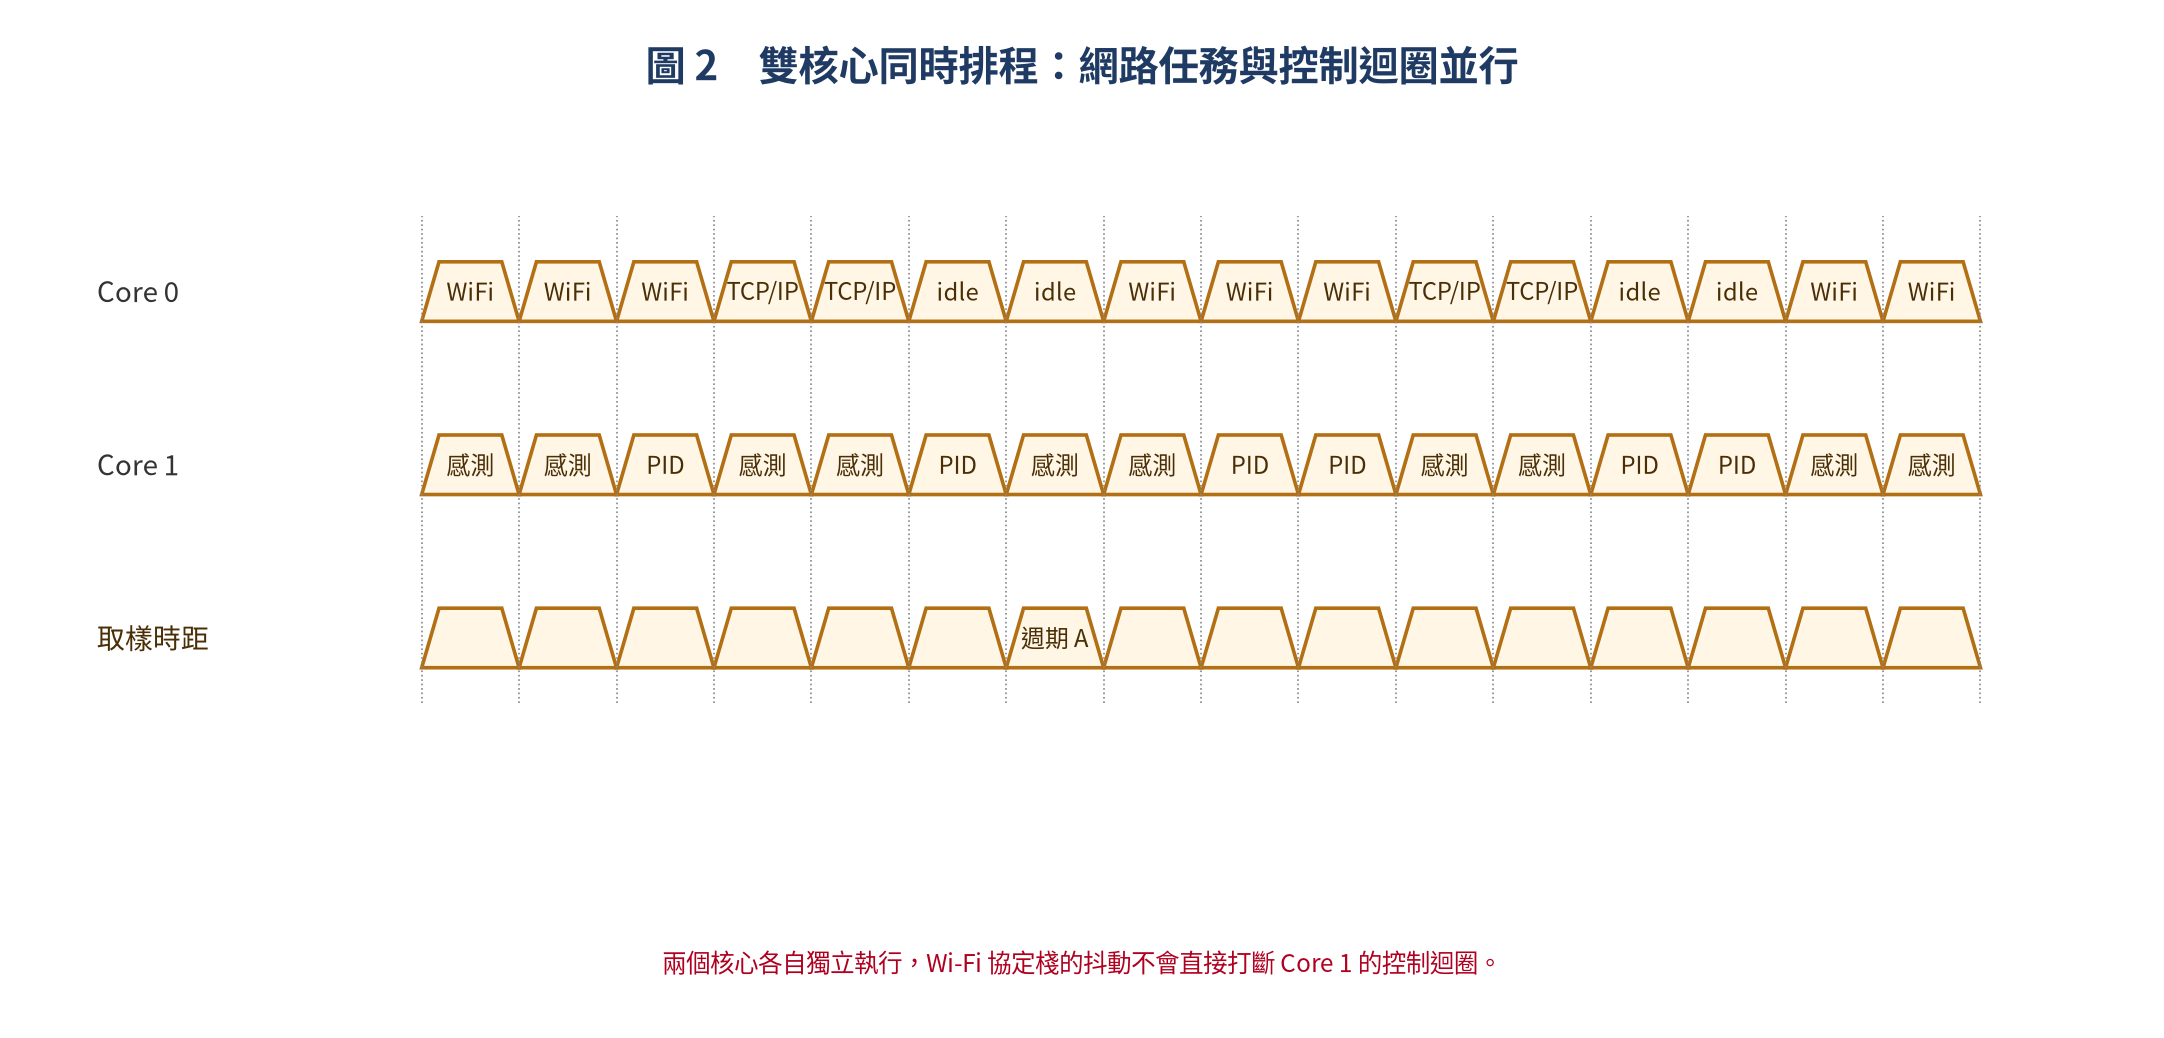
可以看出來,Core 0 忙著處理 Wi-Fi 與 TCP/IP,Core 1 則穩穩地跑它的感測與 PID。重點不是「兩邊都很忙」,而是兩邊互不干擾 —— Wi-Fi 協定棧的突發延遲不會直接打斷控制迴圈,這才是雙核心對即時性最大的貢獻。
Task Pinning:xTaskCreatePinnedToCore
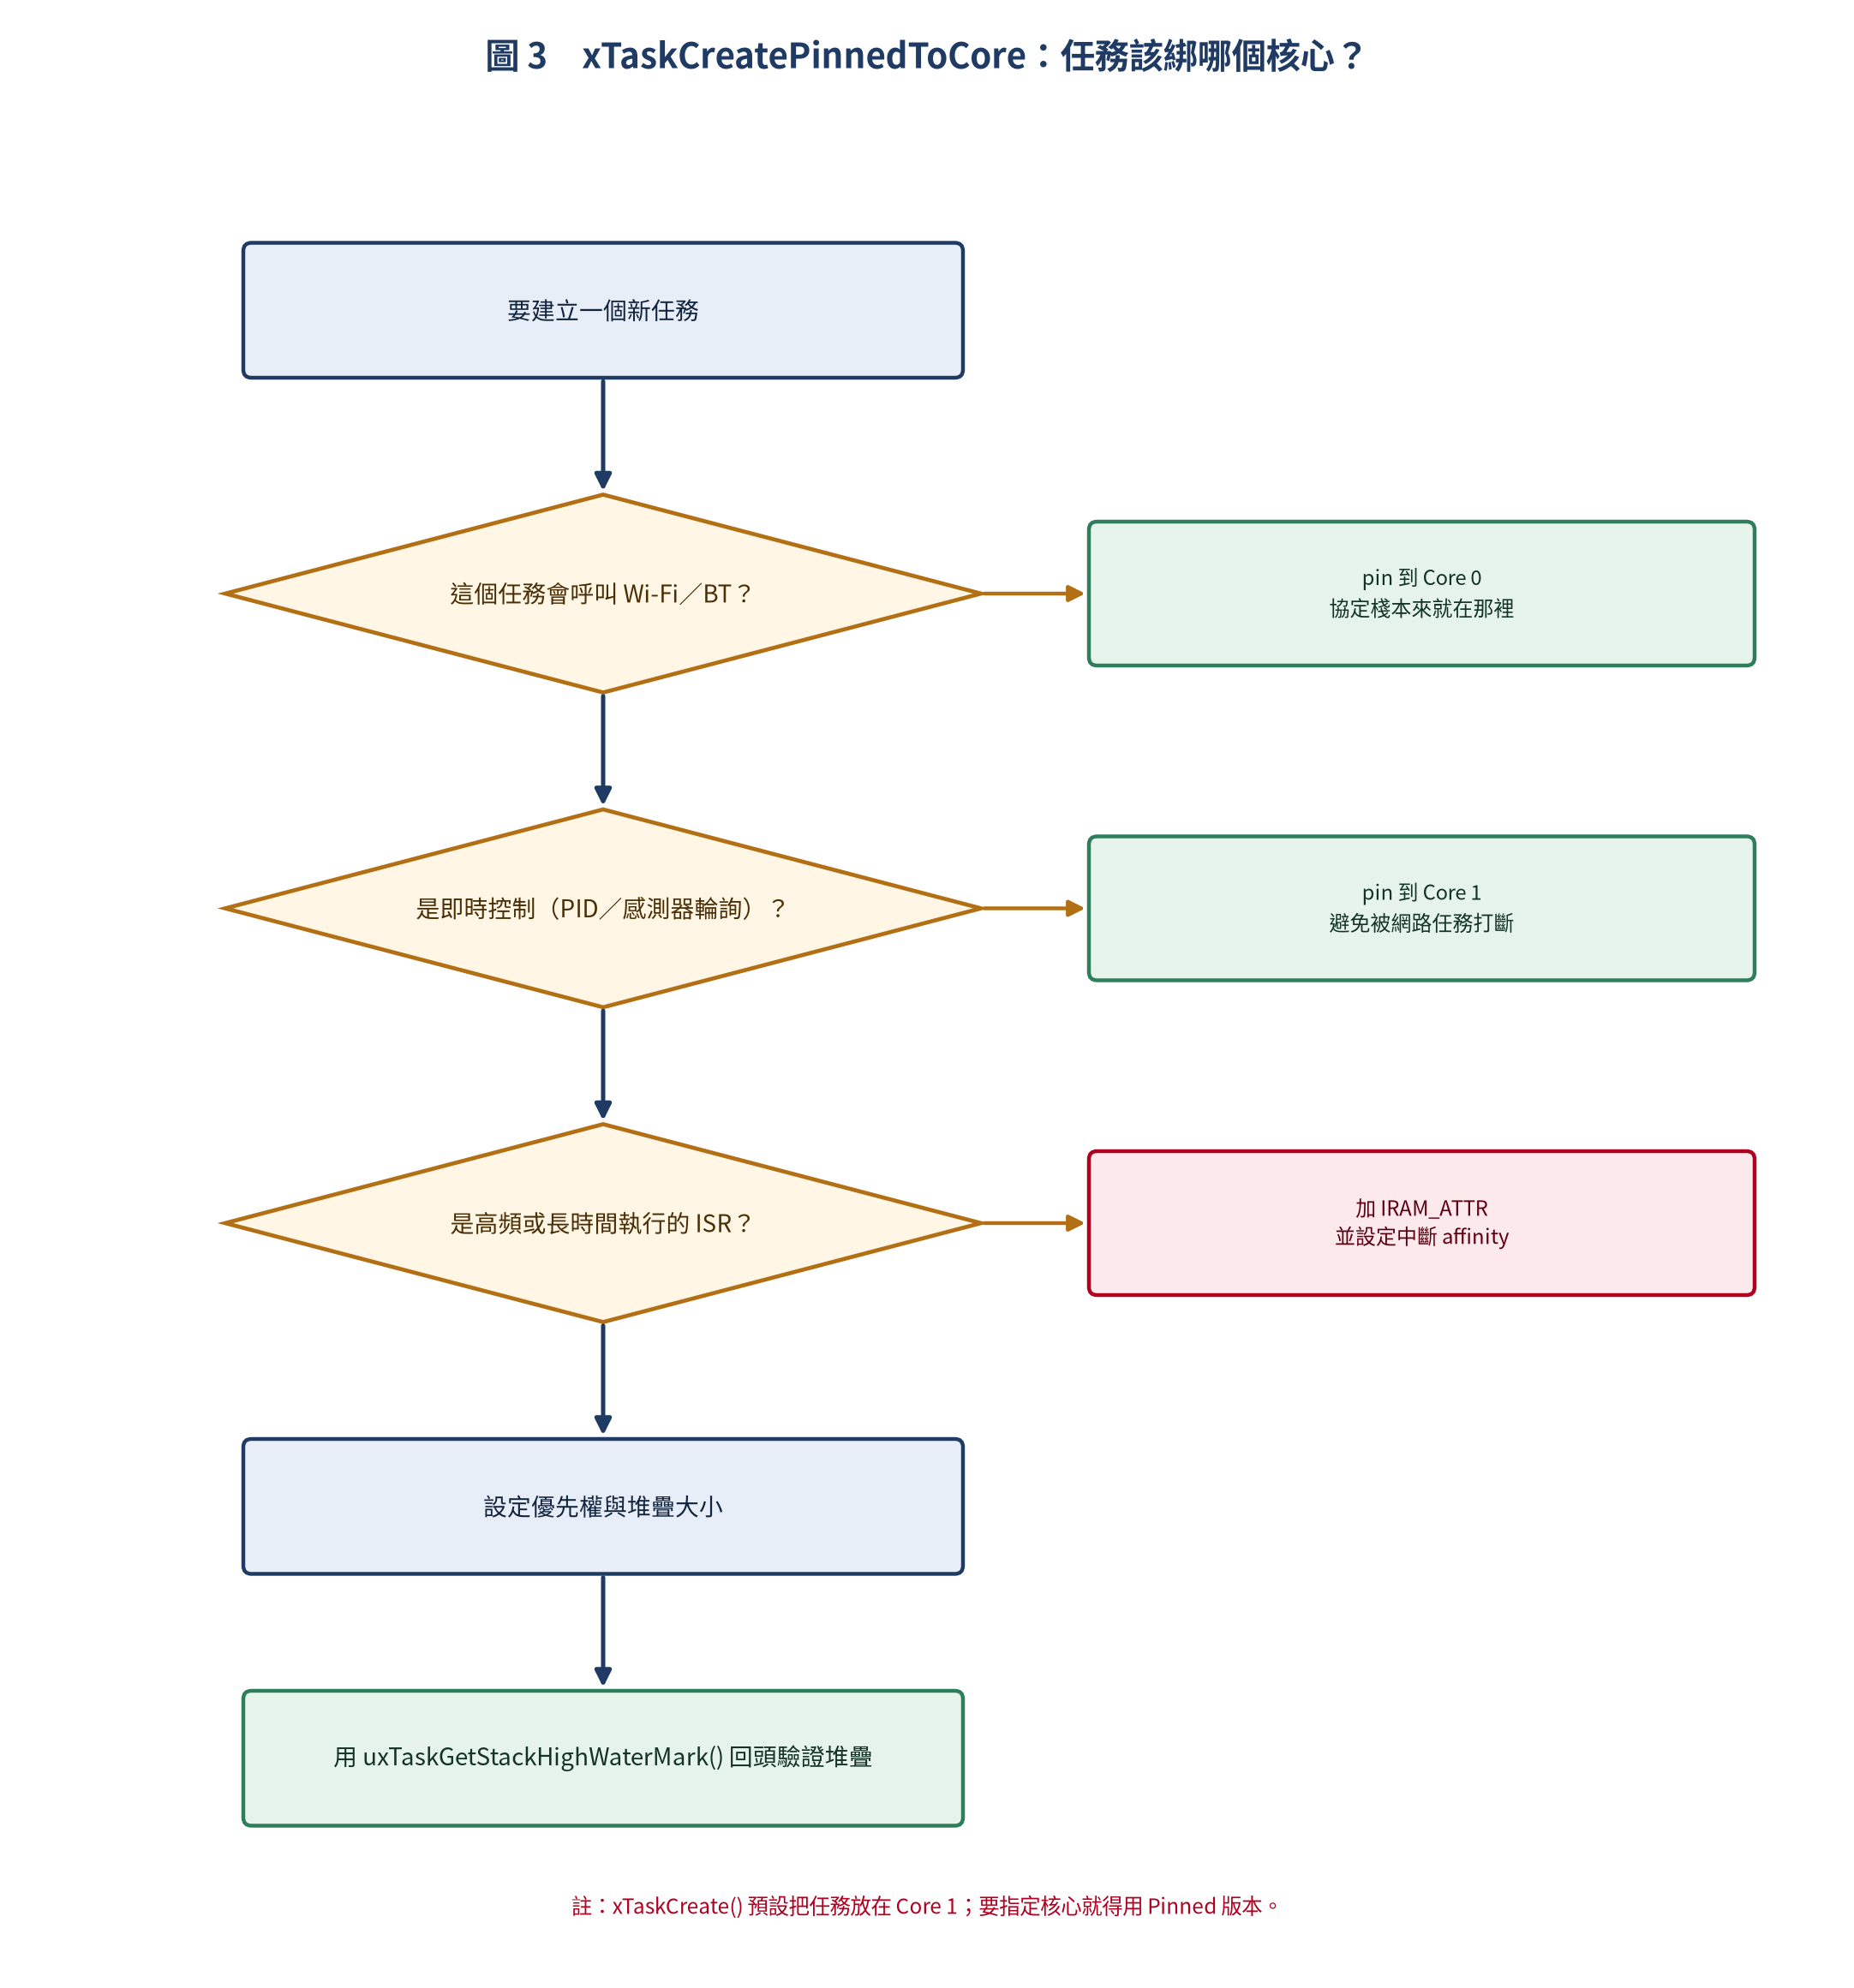
FreeRTOS 的 xTaskCreate() 在 ESP32 上預設將任務分配給 APP_CPU(Core 1)。如果需要指定特定核心,使用 xTaskCreatePinnedToCore():
基礎 API
// xTaskCreatePinnedToCore 原型
BaseType_t xTaskCreatePinnedToCore(
    TaskFunction_t   pvTaskCode,      // 任務函數
    const char*      pcName,          // 任務名稱(除錯用)
    uint32_t         usStackDepth,    // 堆疊深度(words)
    void*            pvParameters,    // 參數指標
    UBaseType_t      uxPriority,      // 優先權 (0~24)
    TaskHandle_t*    pvCreatedTask,   // 任務 Handle
    BaseType_t       xCoreID          // 核心 ID (0=PRO, 1=APP, tskNO_AFFINITY)
);
範例:WiFi 在 Core 0,感測器在 Core 1
// ESP32 雙核心工作分配範例
#include <WiFi.h>
#include <freertos/task.h>

// 任務宣告
void sensorTask(void *pvParameters);
void wifiTask(void *pvParameters);
void controlTask(void *pvParameters);

// 共享資料(全域變數,需用 volatile 避免編譯器最佳化)
volatile float sensorData = 0;
volatile bool  dataReady = false;

void setup() {
    Serial.begin(115200);

    // 建立感測器任務 → 綁定到 Core 1 (APP_CPU)
    xTaskCreatePinnedToCore(
        sensorTask,     // 任務函數
        "SensorPoll",   // 名稱
        4096,           // 堆疊大小
        NULL,           // 參數
        3,              // 優先權
        NULL,           // Task Handle
        1               // Core 1
    );

    // 建立控制任務 → 綁定到 Core 1
    xTaskCreatePinnedToCore(
        controlTask,
        "ControlLoop",
        2048,
        NULL,
        2,
        NULL,
        1
    );

    // 建立 WiFi 任務 → 綁定到 Core 0
    xTaskCreatePinnedToCore(
        wifiTask,
        "WiFiMgr",
        8192,
        NULL,
        2,
        NULL,
        0
    );

    Serial.println("所有任務已建立,排程器執行中...");
}

void loop() {
    // Arduino loop() 預設在 Core 1 執行
    // 這裡可以放一些低優先權的工作
    vTaskDelay(pdMS_TO_TICKS(1000));
}

// === 感測器任務 (Core 1) ===
void sensorTask(void *pvParameters) {
    TickType_t xLastWakeTime = xTaskGetTickCount();

    while (1) {
        // 模擬讀取感測器
        sensorData = analogRead(34) * 3.3 / 4095.0;
        dataReady = true;

        Serial.printf("[Sensor Task] Core=%d, Data=%.2f
",
            xPortGetCoreID(), sensorData);

        // 精確定時 100 ms (10 Hz)
        vTaskDelayUntil(&xLastWakeTime, pdMS_TO_TICKS(100));
    }
}

// === 控制任務 (Core 1) ===
void controlTask(void *pvParameters) {
    while (1) {
        if (dataReady) {
            dataReady = false;
            // 根據感測器資料執行控制邏輯
            float output = sensorData * 2.5 + 1.0;
            Serial.printf("[Control Task] Core=%d, Output=%.2f
",
                xPortGetCoreID(), output);
        }
        vTaskDelay(pdMS_TO_TICKS(10));
    }
}

// === WiFi 任務 (Core 0) ===
void wifiTask(void *pvParameters) {
    WiFi.begin("SSID", "PASSWORD");
    while (WiFi.status() != WL_CONNECTED) {
        vTaskDelay(pdMS_TO_TICKS(500));
    }
    Serial.printf("[WiFi] 已連線, Core=%d
", xPortGetCoreID());

    while (1) {
        // 定時上傳資料
        vTaskDelay(pdMS_TO_TICKS(30000));
        Serial.printf("[WiFi] Uploading... Core=%d
", xPortGetCoreID());
    }
}
核心間通訊(IPC)
雙核心程式設計真正的挑戰不是「怎麼開兩個任務」,而是資料同步與資源互斥。兩個核心跑在同一塊記憶體上,一旦同時碰同一個東西就會出事。FreeRTOS 提供多種 IPC 機制,用途各不相同:
1. Queue — 資料傳遞
要傳「一整包資料」就用 Queue。它會複製資料,所以生產者送完就可以去做別的事:
// Queue:Core 0 → Core 1 傳遞感測器資料
QueueHandle_t sensorQueue;

void senderTask(void *pv) {  // Core 0
    float data = 25.5;
    while (1) {
        xQueueSend(sensorQueue, &data, portMAX_DELAY);
        vTaskDelay(pdMS_TO_TICKS(100));
    }
}

void receiverTask(void *pv) {  // Core 1
    float received;
    while (1) {
        if (xQueueReceive(sensorQueue, &received, portMAX_DELAY)) {
            Serial.printf("[Core %d] Received: %.1f
",
                xPortGetCoreID(), received);
        }
    }
}

void setup() {
    sensorQueue = xQueueCreate(10, sizeof(float));

    xTaskCreatePinnedToCore(senderTask,   "Sender",   2048, NULL, 1, NULL, 0);
    xTaskCreatePinnedToCore(receiverTask, "Receiver", 2048, NULL, 1, NULL, 1);
}
2. Semaphore — 事件通知
如果你不需要傳資料,只是要告訴對方「事情發生了」,Semaphore 比 Queue 輕很多:
// Binary Semaphore:Core 1 通知 Core 0 資料就緒
SemaphoreHandle_t dataSemaphore;

void producerTask(void *pv) {  // Core 1 (感測器)
    while (1) {
        vTaskDelay(pdMS_TO_TICKS(50));  // 讀取感測器
        xSemaphoreGive(dataSemaphore);  // 通知消費者
    }
}

void consumerTask(void *pv) {  // Core 0 (WiFi)
    while (1) {
        xSemaphoreTake(dataSemaphore, portMAX_DELAY);  // 等待通知
        Serial.printf("[Core %d] Data ready, sending...
",
            xPortGetCoreID());
        // 上傳資料到雲端
    }
}
3. Mutex — 保護共享資源(如 SPI 匯流排)
當兩個核心都得碰同一條 I2C 或 SPI 匯流排時,Mutex 是唯一的正解 —— 它還具備優先權繼承,能避免高優先權任務被低優先權任務卡住的經典問題:
// Mutex:保護 SPI Flash / 周邊匯流排
SemaphoreHandle_t spiMutex;

void setup() {
    spiMutex = xSemaphoreCreateMutex();
}

void readSensorSPI() {
    if (xSemaphoreTake(spiMutex, pdMS_TO_TICKS(100)) == pdTRUE) {
        // 安全操作 SPI 匯流排
        // SPI.beginTransaction(SPISettings(...));
        // digitalWrite(CS, LOW);
        // SPI.transfer(...);
        // digitalWrite(CS, HIGH);
        // SPI.endTransaction();
        xSemaphoreGive(spiMutex);
    } else {
        Serial.println("SPI Busy!");
    }
}
Task Notification(最快 IPC)
如果連 Semaphore 的開銷都嫌重,還有更輕的選擇。Task Notification 是 FreeRTOS 專有的機制,比 Semaphore 快約 3~5 倍,因為它不需要獨立的 queue 或 semaphore 物件 —— 每個 Task 內建一個 32-bit 通知值。
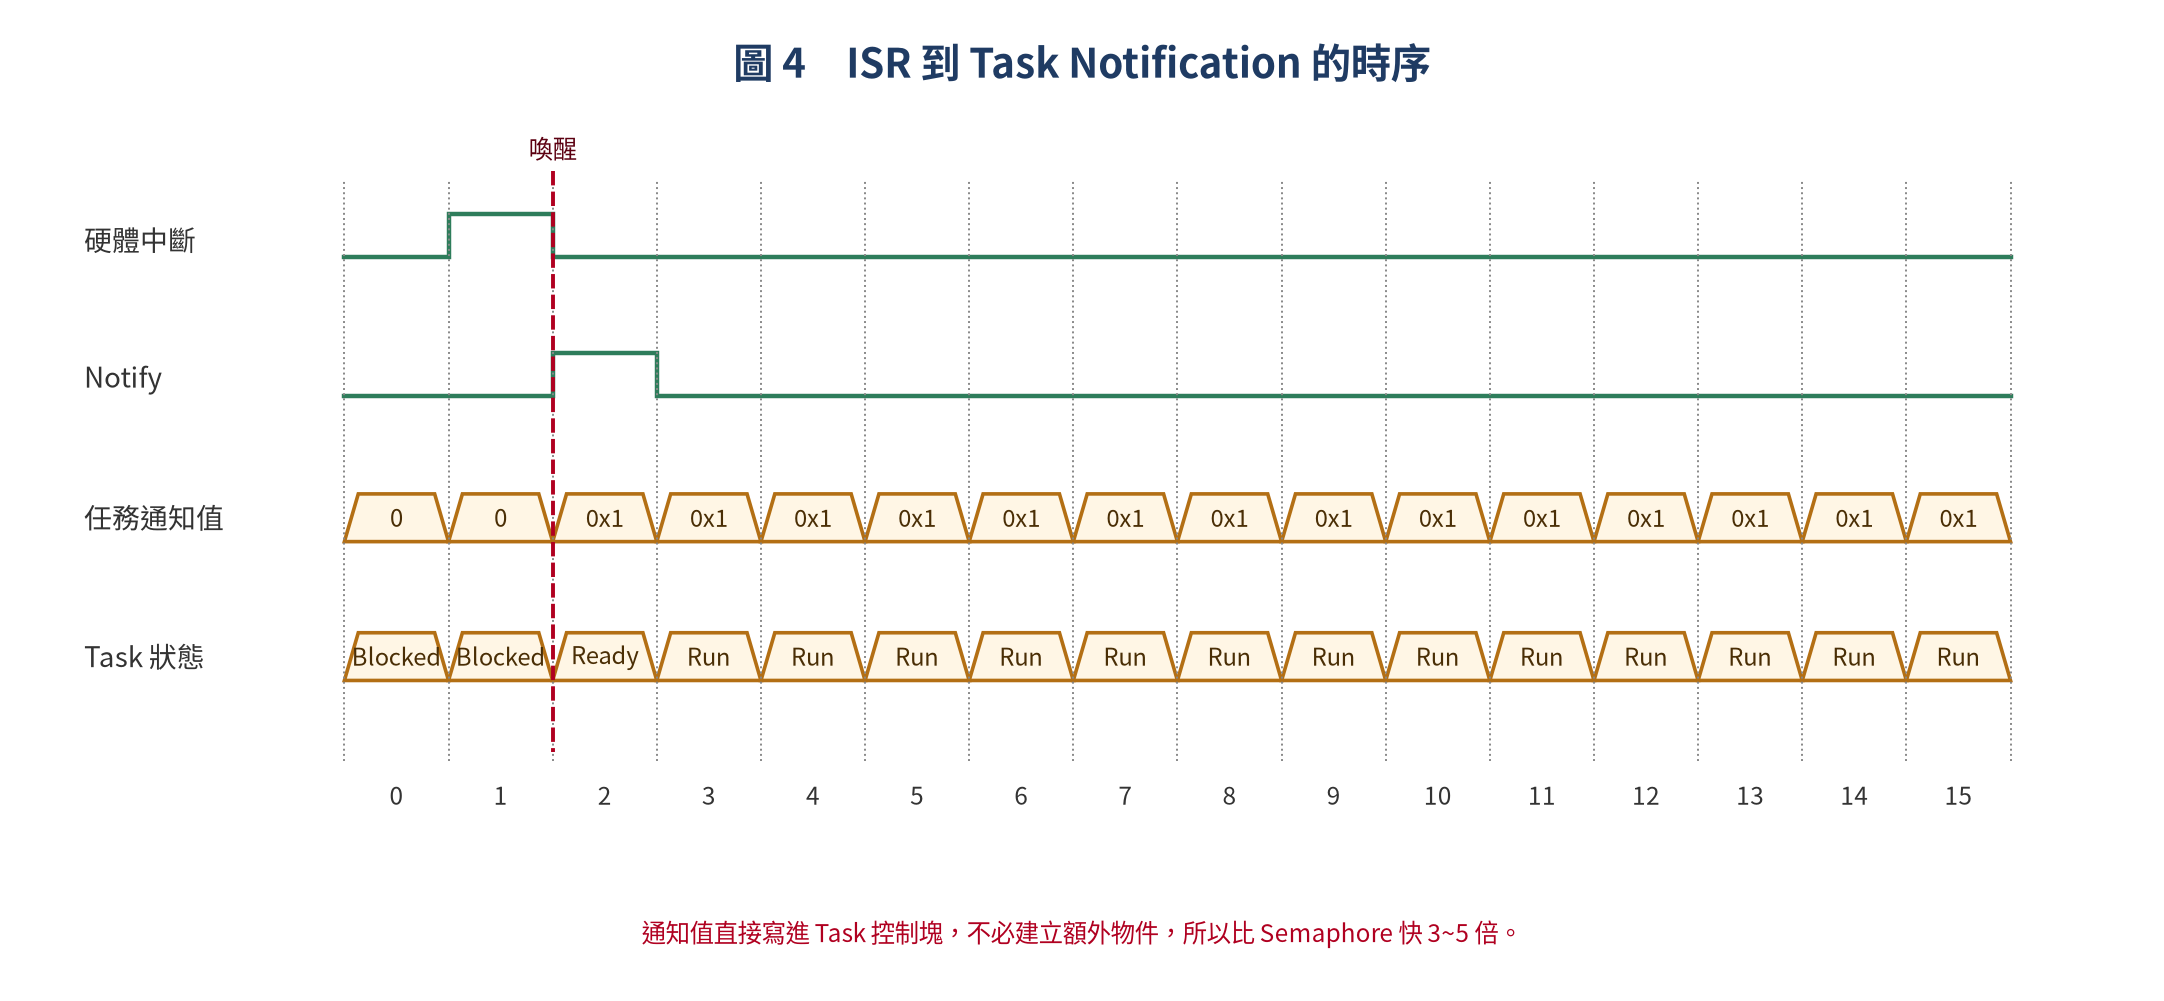
// Task Notification:ISR 通知另一核心的任務
static TaskHandle_t workerTaskHandle = NULL;

void IRAM_ATTR gpio_isr_handler(void* arg) {
    // 從 ISR 通知另一個核心上的任務
    BaseType_t xHigherPriorityTaskWoken = pdFALSE;
    vTaskNotifyGiveFromISR(workerTaskHandle, &xHigherPriorityTaskWoken);
    portYIELD_FROM_ISR(xHigherPriorityTaskWoken);
}

void workerTask(void *pvParameters) {  // Core 1
    uint32_t notificationCount;

    while (1) {
        // 等待通知(阻塞,不佔 CPU)
        notificationCount = ulTaskNotifyTake(pdTRUE, portMAX_DELAY);

        // 被喚醒後執行工作
        Serial.printf("[Core %d] Notified! Count=%u
",
            xPortGetCoreID(), notificationCount);
    }
}

void setup() {
    // 建立工作者任務(Core 1)
    xTaskCreatePinnedToCore(
        workerTask, "Worker", 2048, NULL, 3,
        &workerTaskHandle, 1
    );

    // 設定 GPIO 中斷
    pinMode(4, INPUT_PULLUP);
    attachInterrupt(digitalPinToInterrupt(4),
        gpio_isr_handler, FALLING);
}
IPC 效能比較
把這些機制的成本並排看,你就知道該在哪裡省:
| IPC 機制 | 速度(CPU 週期) | 資料承載 | 適用場景 |
|---|---|---|---|
| Task Notification | ~120 週期(最快) | 32-bit 值 | ISR → Task 通知 |
| Semaphore (Binary) | ~300 週期 | 無 | 事件同步 |
| Queue | ~400 週期 | 任意大小(複製) | 資料傳遞 |
| Mutex | ~250 週期 | 無 | 資源互斥 |
| Event Group | ~350 週期 | 24-bit 事件旗標 | 多重條件同步 |
| Spinlock | ~50 週期(但忙等) | 無 | 極短臨界區段 |
IRAM 與快取衝突
接下來是最容易被忽略、卻直接吃掉你一半效能的地方。前面提過兩個核心共用 Flash 與快取控制器,實際的後果是這樣:
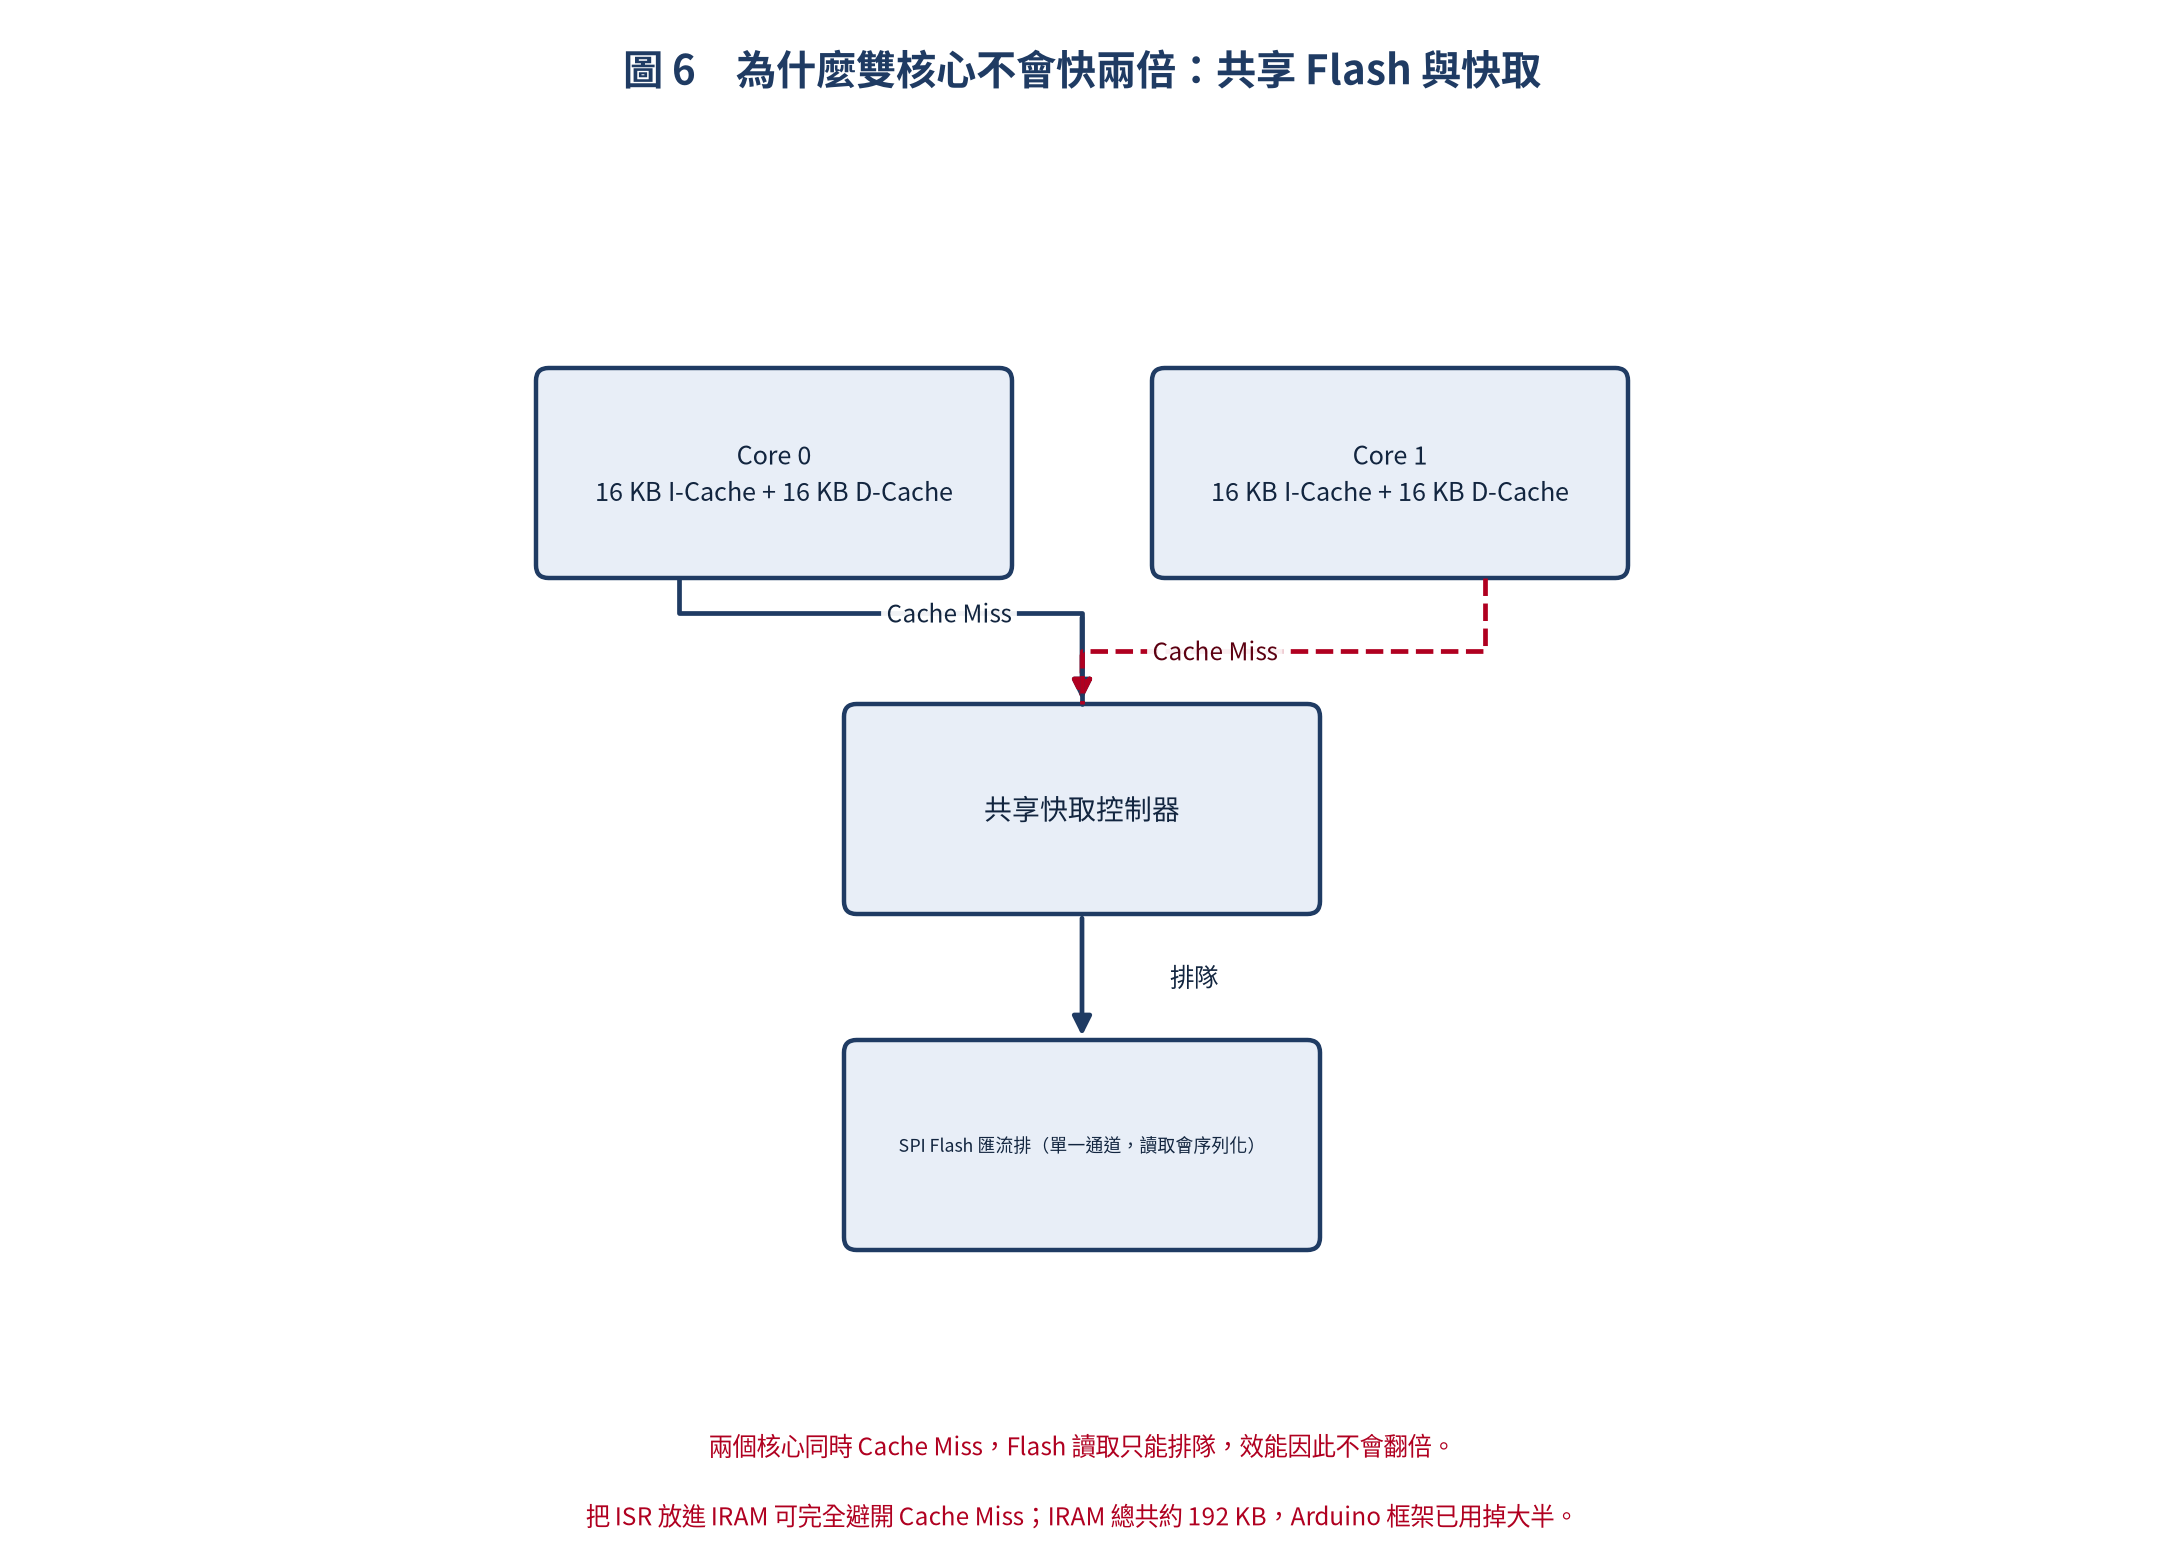
所以當 ISR 很短、又希望它絕對準時,就得把它搬進 IRAM,讓它不需要等 Flash:
// 將關鍵 ISR 放入 IRAM(避免 Cache Miss 延遲)
// 在函數前加上 IRAM_ATTR 即可
#include "esp_attr.h"

// 這個函數會被編譯到 IRAM (0x40080000+)
void IRAM_ATTR fastISR() {
    // 極速執行,不需從 Flash 讀取指令
    // 但只能呼叫也在 IRAM 中的函數
}

// 也可以在 ESP-IDF 的 CMakeLists.txt 或 component.mk 中設定
// IDF 自動將中斷處理函數放入 IRAM
IRAM 使用建議
- WiFi/BT 中斷:預設已使用 IRAM,不需修改
- 自訂 ISR:若 ISR 執行時間 < 10 us,不需要 IRAM
- 高速 ISR(> 10 us 或 > 10 kHz):使用 IRAM_ATTR
- IRAM 大小:總共約 192 KB,但 Arduino 框架已用掉大部分
- 檢查 IRAM 用量:透過 Serial 輸出或 ESP-IDF Monitor
實戰案例:WiFi 感測器站台
把前面所有東西組起來,就是一個很典型的 IoT 站台:Core 0 管網路、Core 1 管感測與控制,中間用 IPC 接起來。
// 實戰:雙核心 WiFi 感測器站台
// Core 0: WiFi + MQTT + HTTP Server
// Core 1: 感測器輪詢 + 控制演算法 + OLED 顯示

// === 共用資料結構 ===
typedef struct {
    float temperature;
    float humidity;
    float pressure;
    uint32_t timestamp;
} SensorData;

QueueHandle_t sensorToNetwork;  // Core 1 → Core 0
SemaphoreHandle_t i2cMutex;     // 保護 I2C 匯流排

// === Core 1:感測器任務 ===
void sensorTask(void *pv) {
    SensorData data;
    TickType_t lastWake = xTaskGetTickCount();

    while (1) {
        xSemaphoreTake(i2cMutex, portMAX_DELAY);
        // 讀取 BME280
        data.temperature = readBME280_Temp();
        data.humidity    = readBME280_Hum();
        data.pressure    = readBME280_Press();
        xSemaphoreGive(i2cMutex);

        data.timestamp = millis() / 1000;

        // 送給網路任務
        xQueueSend(sensorToNetwork, &data, 0);

        // 更新 OLED(同 Core 1,不需要同步)
        updateOLED(data.temperature, data.humidity);

        vTaskDelayUntil(&lastWake, pdMS_TO_TICKS(2000));  // 2 Hz
    }
}

// === Core 0:網路任務 ===
void networkTask(void *pv) {
    SensorData data;
    WiFi.begin("SSID", "PASSWORD");
    while (WiFi.status() != WL_CONNECTED) vTaskDelay(100);

    while (1) {
        if (xQueueReceive(sensorToNetwork, &data, portMAX_DELAY)) {
            // 透過 WiFi 上傳(Core 0 處理,不影響 Core 1 的感測器)
            uploadToCloud(data.temperature, data.humidity, data.pressure);
        }
    }
}

void setup() {
    sensorToNetwork = xQueueCreate(5, sizeof(SensorData));
    i2cMutex = xSemaphoreCreateMutex();

    xTaskCreatePinnedToCore(sensorTask,  "Sensor",  4096, NULL, 3, NULL, 1);
    xTaskCreatePinnedToCore(networkTask, "Network", 8192, NULL, 2, NULL, 0);
}

void loop() { vTaskDelay(1000); }
效能測試
這些機制的成本到底是多少?把表中的 CPU 週期換算成時間(240 MHz 下 1 週期約 4.17 ns),輪廓就很清楚了:
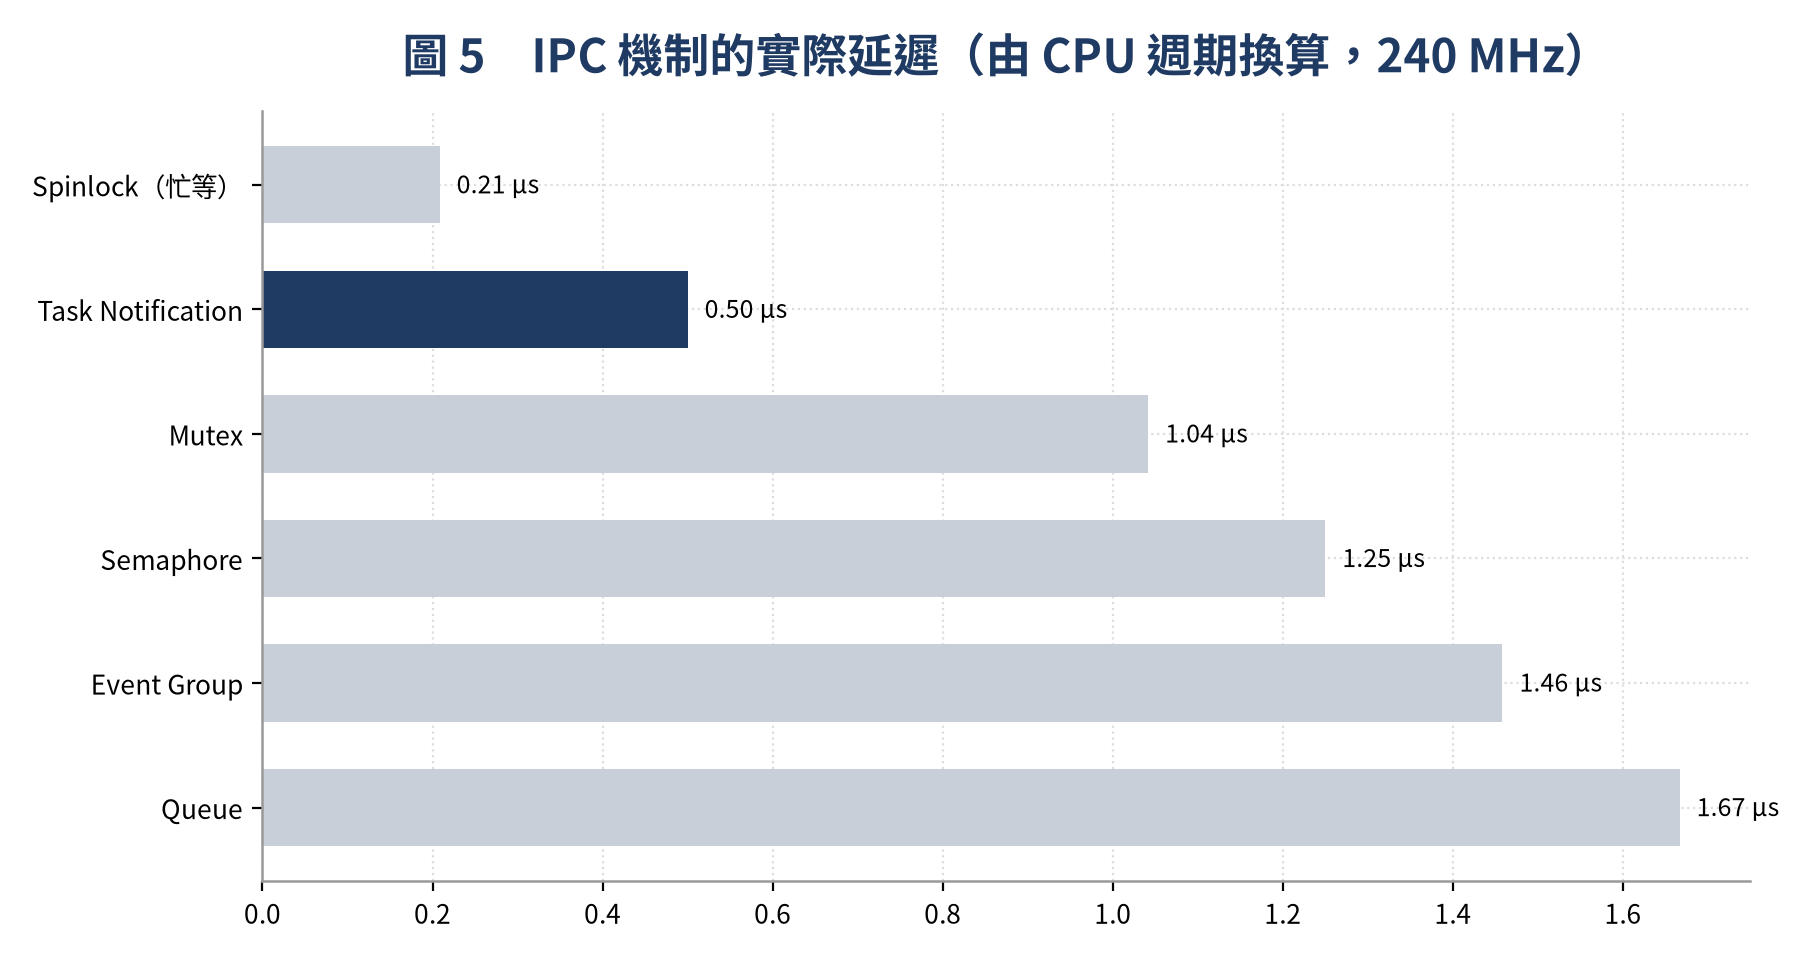
看完這個數字,你大概會發現一件反直覺的事:IPC 的開銷其實微不足道,最快的只要 0.5 微秒,最慢的 Queue 也不到 2 微秒。也就是說,雙核心專案跑不出預期效能時,兇手幾乎不會是 IPC 本身,而是共享資源的排隊(Flash 存取、I2C/SPI 匯流排)以及任務優先權安排不當。
這也正好呼應前面的架構圖:CPU 使用率不會翻倍,是因為兩個核心搶的是同一條 Flash。要真的變快,得先減少共享資源的存取,而不是把 IPC 換成更快的機制。
除錯與監控
最後是怎麼知道「任務到底跑在哪個核心」:
// 查看目前哪個核心在執行
Serial.printf("Running on Core: %d
", xPortGetCoreID());

// 列出所有任務與狀態(ESP-IDF)
// 在 terminal 輸入: monitor
// 或呼叫: vTaskList / vTaskGetRunTimeStats
// FreeRTOS 除錯選項需在 menuconfig 中啟用:
// Component config → FreeRTOS → Enable FreeRTOS trace facility

// 檢查任務堆疊使用量
UBaseType_t stackHighWaterMark;
TaskHandle_t xHandle = xTaskGetHandle("SensorPoll");
stackHighWaterMark = uxTaskGetStackHighWaterMark(xHandle);
Serial.printf("Sensor task free stack: %d words
", stackHighWaterMark);
常見問題
下面這張表把雙核心專案最常見的症狀整理起來,症狀通常很嚇人(重開機、任務卡死),但原因往往很單純:
| 問題 | 原因 | 解法 |
|---|---|---|
| WiFi 斷線 + 任務卡死 | 兩個核心同時存取 Flash(Cache Thrashing) | 降低任務頻率,或將 WiFi 任務優先權提高 |
| 重啟 (Guru Meditation) | Cache 衝突 + 中斷未正確路由 | 將 ISR 放入 IRAM,設定中斷 affinity |
| 感測器讀取錯誤 | I2C 匯流排同時被兩個核心存取 | 使用 Mutex 保護 I2C/SPI |
| Queue 滿了丟失資料 | 生產者速度 > 消費者速度 | 增大 Queue 長度,或降低生產者頻率 |
| Stack Overflow | 任務堆疊太小 | 使用 uxTaskGetStackHighWaterMark() 檢查 |
| 效能不如預期 | Amdahl's Law:序列化瓶頸 | 減少共享資源存取,增加 IPC 粒度 |
總結
ESP32 的雙核心架構是真實的對稱多處理(SMP)系統。正確使用 xTaskCreatePinnedToCore 搭配 IPC 機制,可以讓 Wi-Fi 通訊與即時控制完全並行,達到最佳效能。
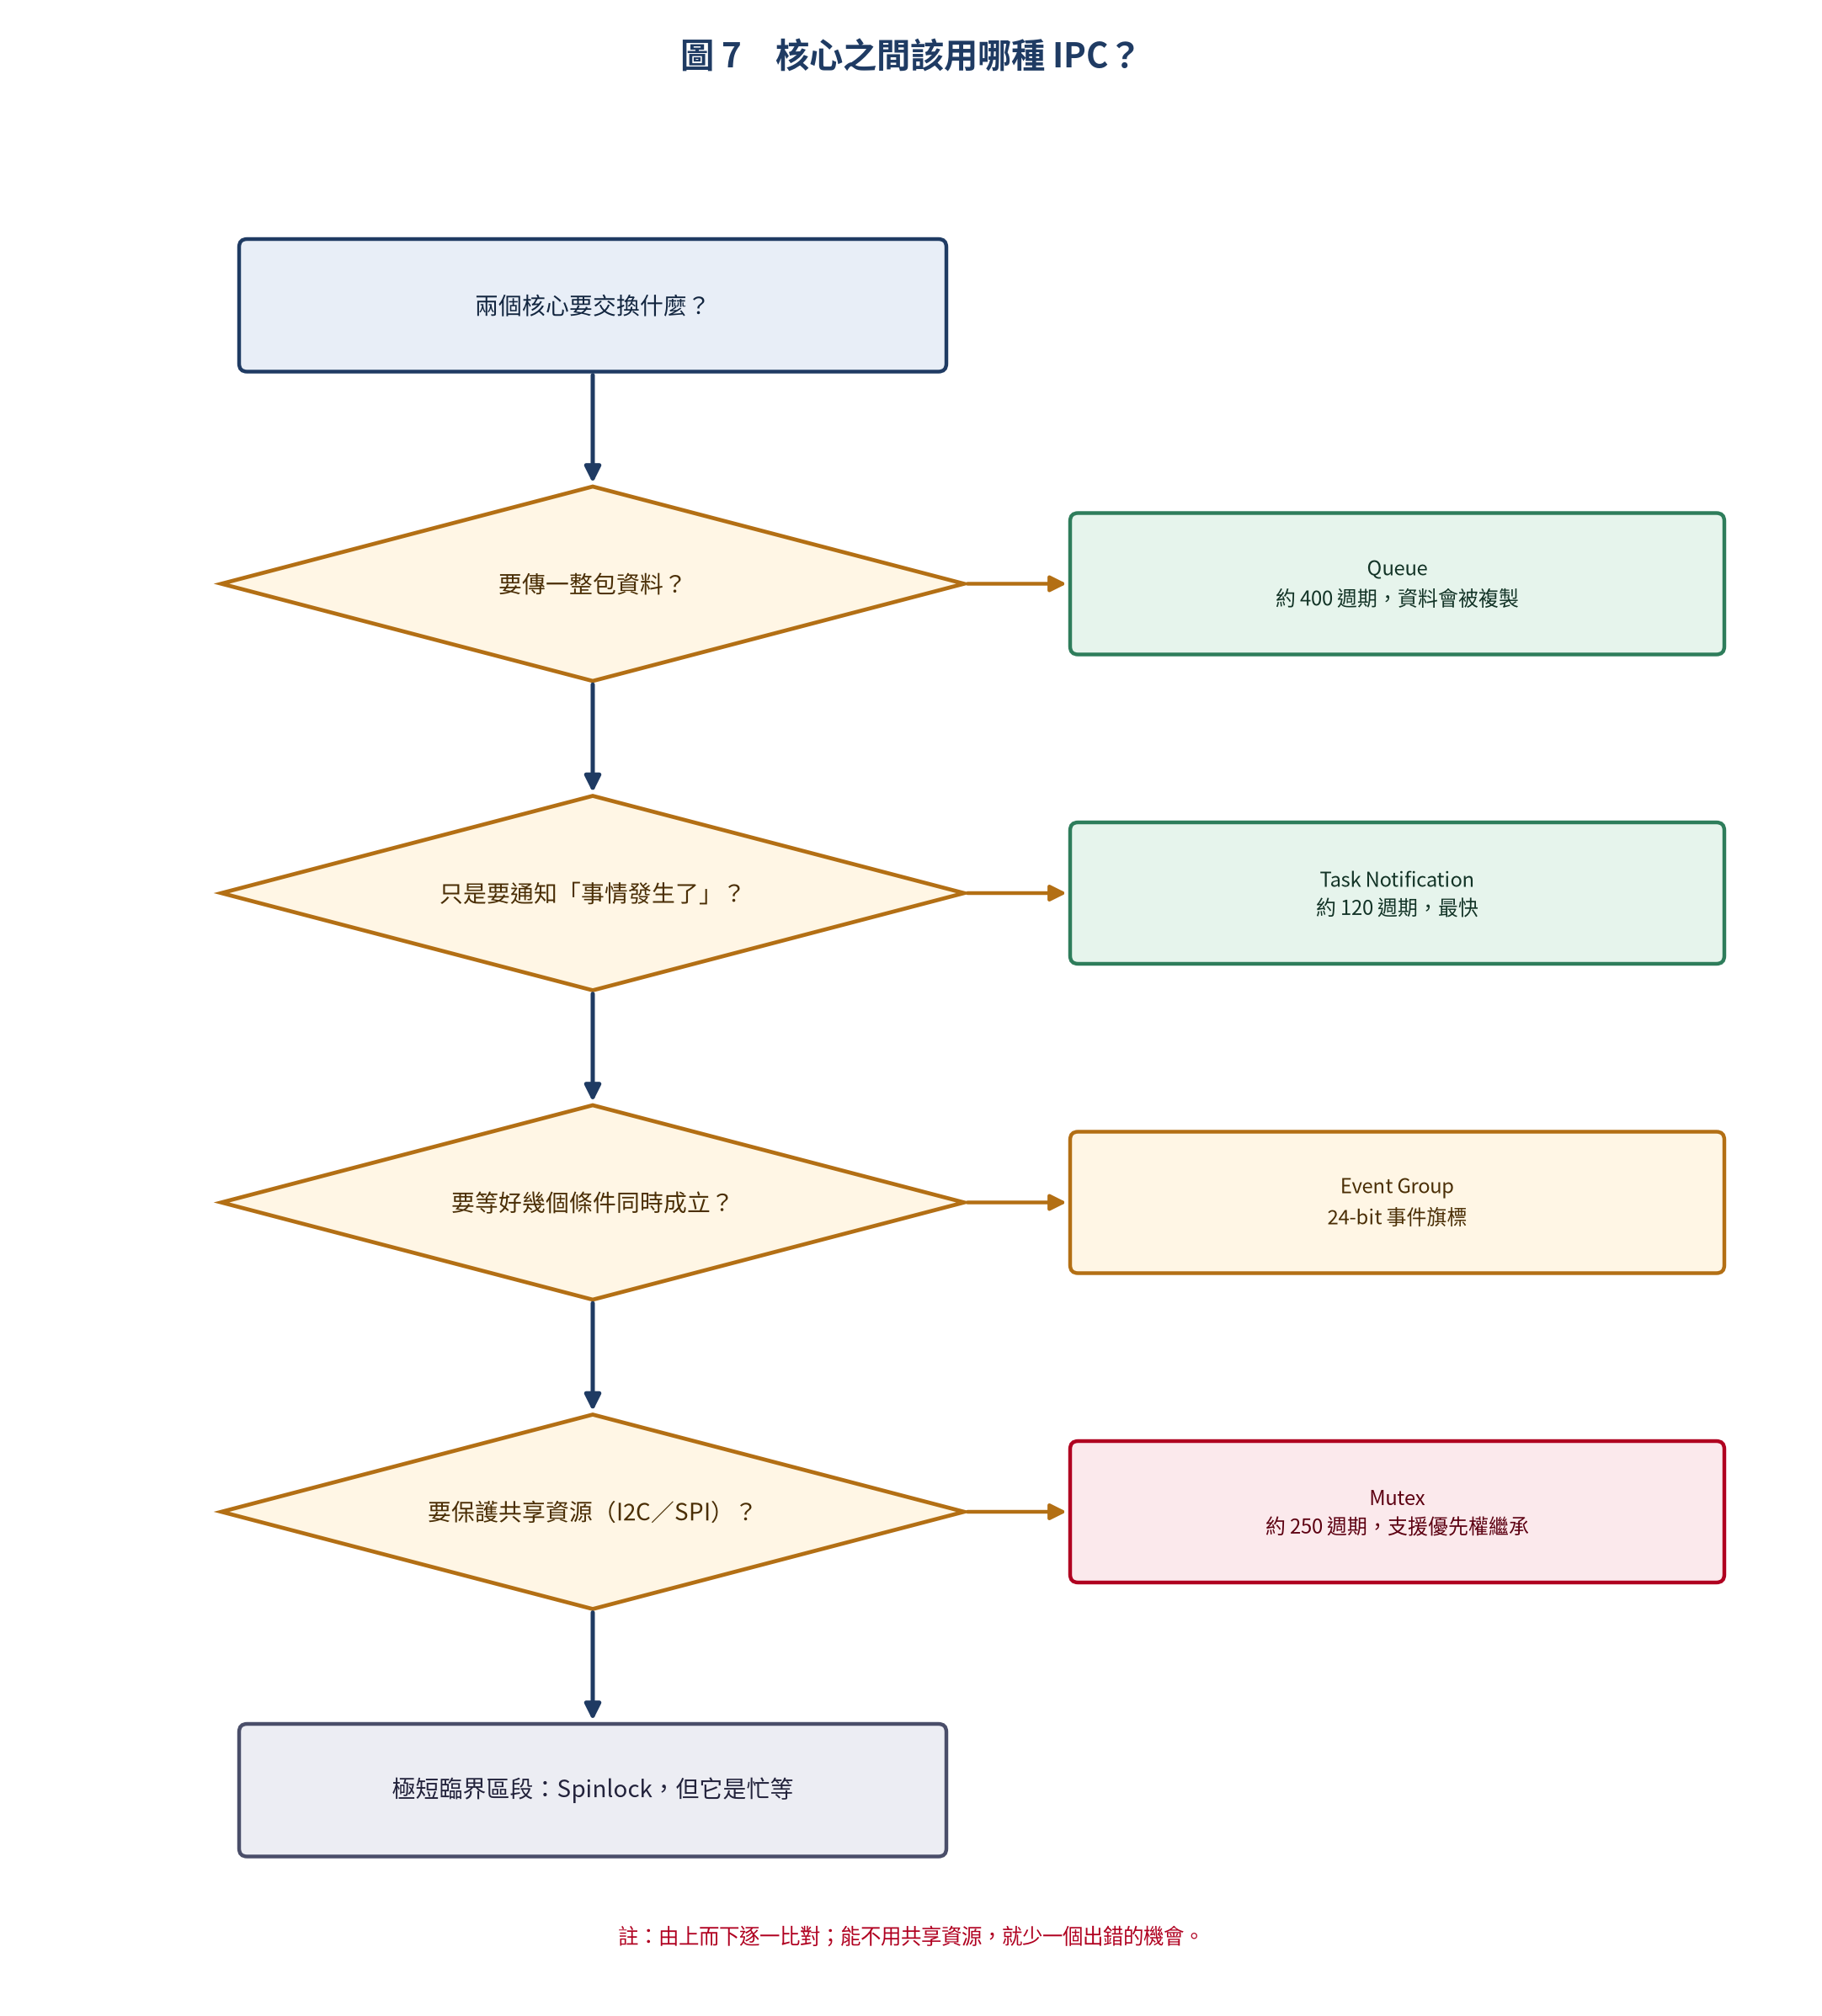
把選型流程攤成文字,建議分配策略就是這幾句:
- Core 0(PRO_CPU):WiFi/BT 協定棧、TCP/IP、MQTT、HTTP Server、檔案系統
- Core 1(APP_CPU):感測器輪詢、控制演算法(PID)、LCD/OLED 顯示、音頻處理
- IPC 選擇:資料傳遞用 Queue、事件同步用 Semaphore/Notification、資源互斥用 Mutex
- CORE 0 專用:所有 Arduino 的 yield()/delay() 相關函數預設綁定 Core 1
我自己的習慣是:先問「這個任務會不會碰到網路」,會的就往 Core 0 靠,不會的留在 Core 1;然後才去想要用哪一種 IPC。順序反過來,很容易寫出一堆共享狀態再去補 Mutex,最後變成到處都在等鎖。

文章評論