前言:為什麼量產產品幾乎都有一顆看門狗
在實驗室裡,程式當掉最糟的結果就是「重開就好」。但只要這個裝置被裝在客戶的機房、變電箱或屋頂上,一次死機就代表一次客訴、一趟出差、甚至一次賠償。
看門狗計時器(Watchdog Timer)就是為了這種情境存在的:它是一個獨立於主程式之外的硬體計時器,會在最壞的情況下把系統重新拉起來。
它的設計哲學很粗暴,但非常有效 —— 因為它假設「軟體終究會壞」,而硬體不會陪著一起壞。
看門狗的邏輯只有三步
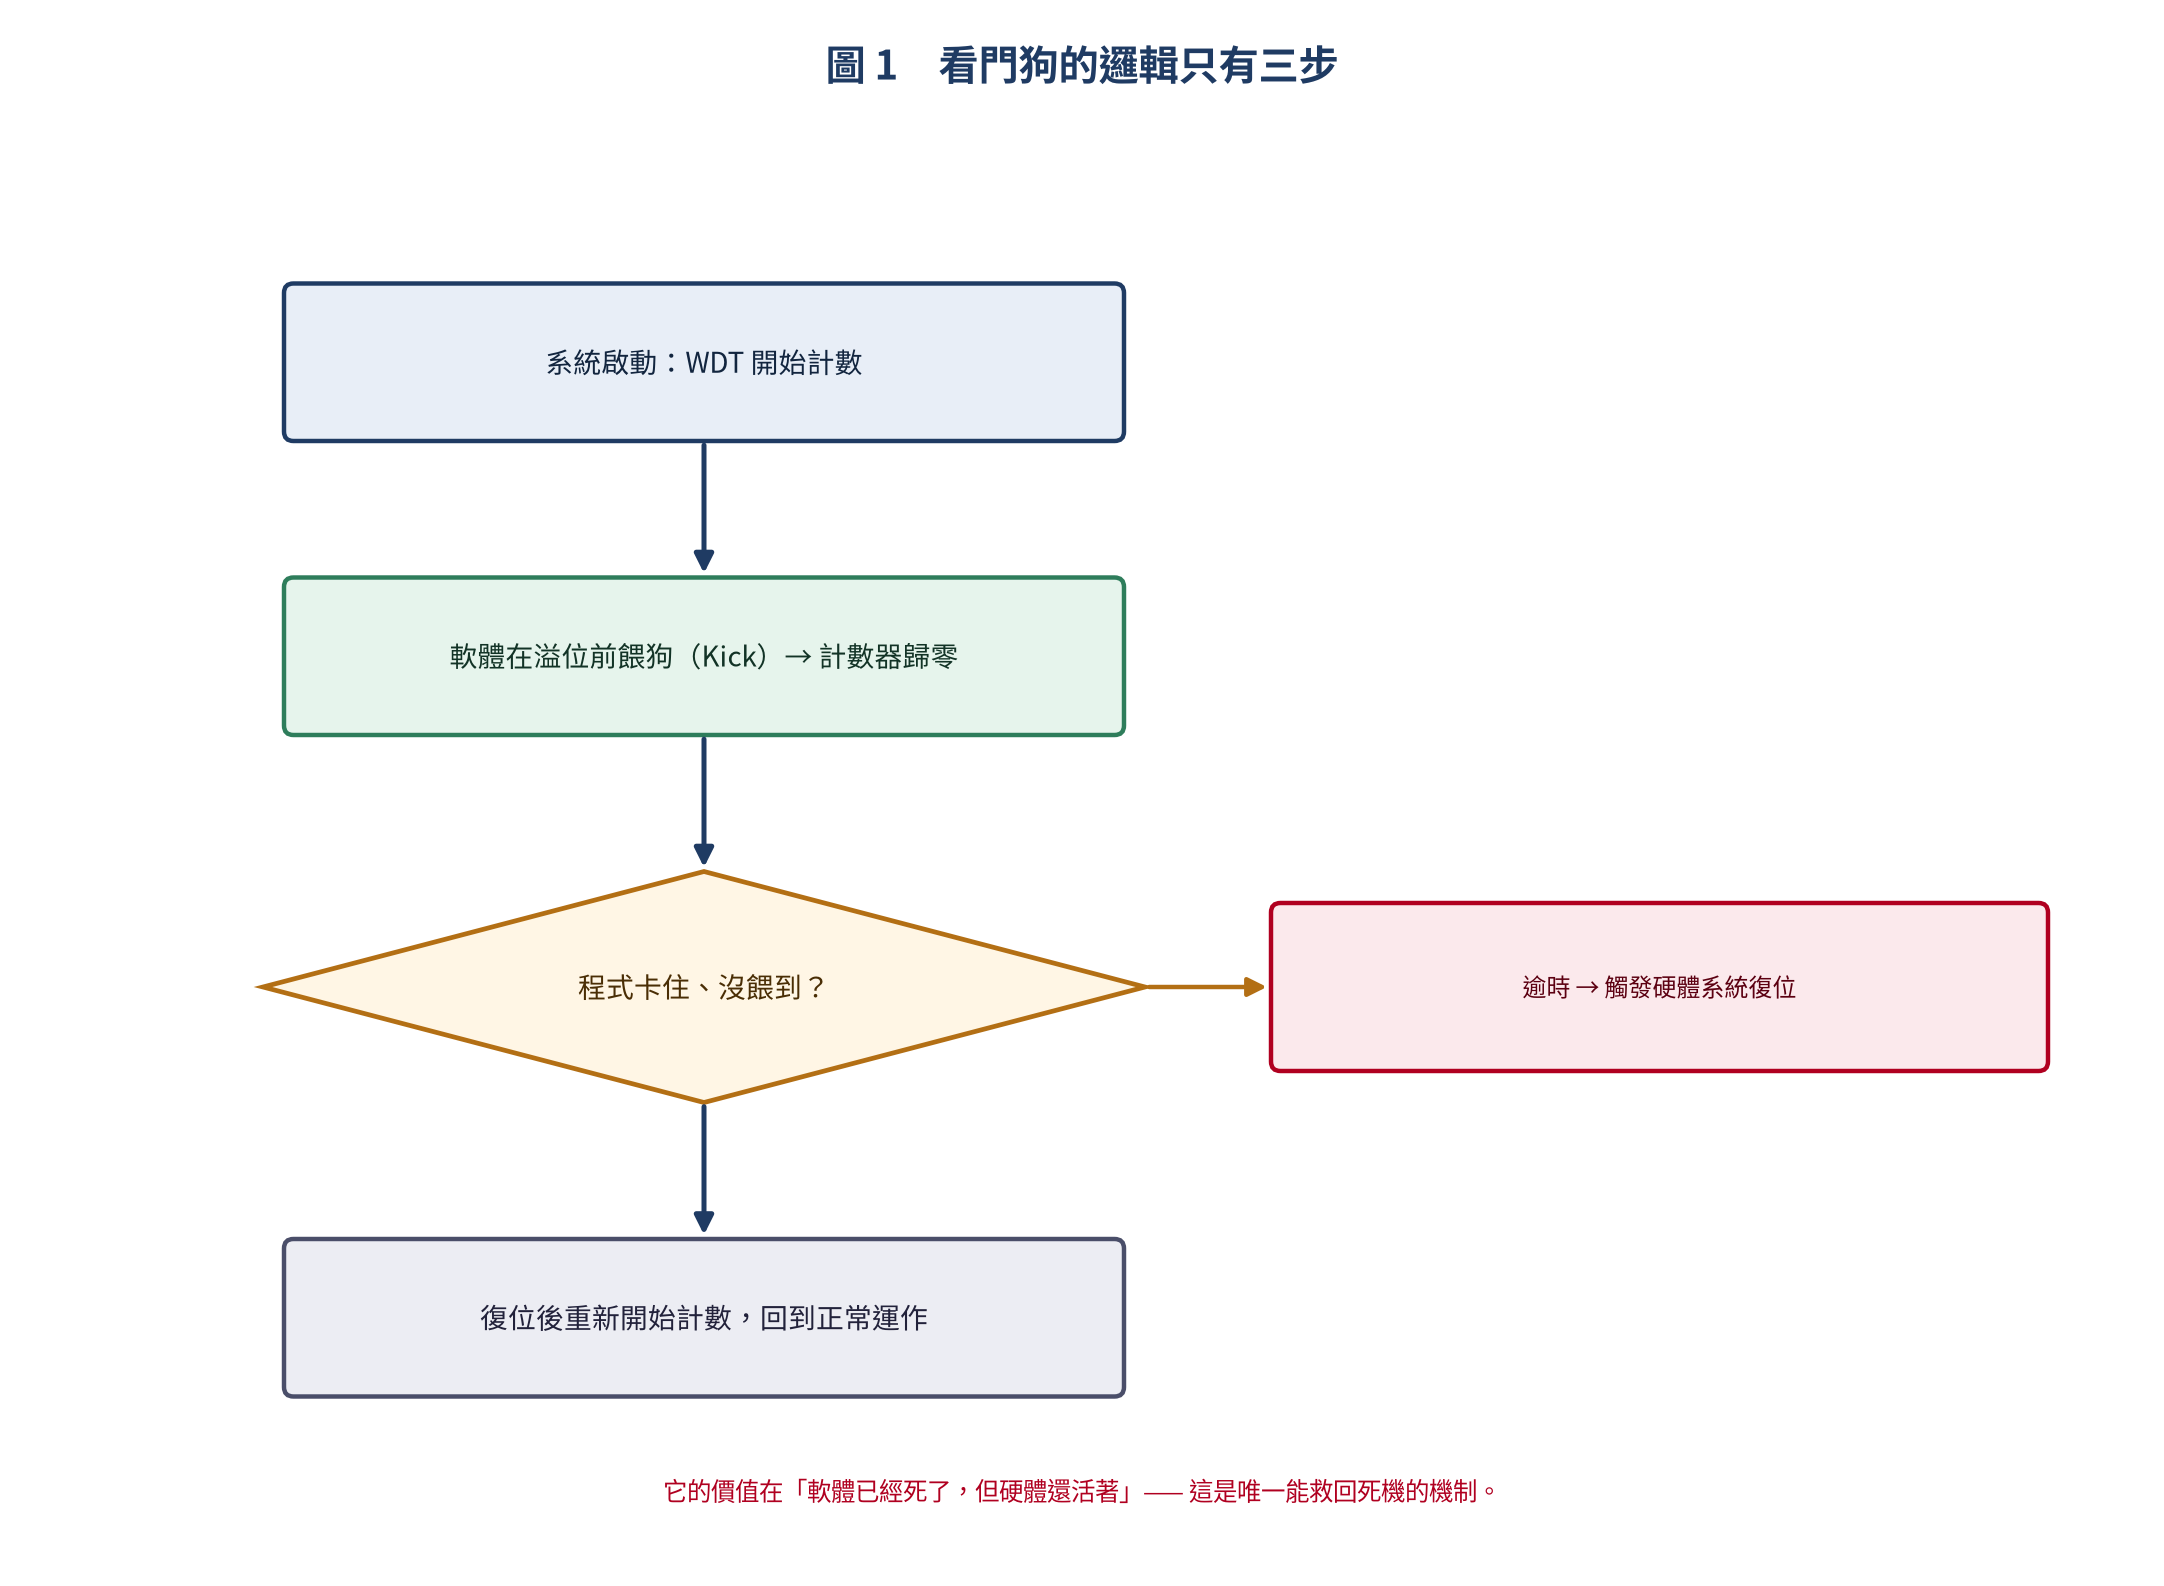
正常運作時你甚至感覺不到它的存在:主迴圈結尾餵一次狗,計數器就一直被歸零。真正有趣的是「沒餵到」的那一刻 —— 那代表軟體已經無法控制局面,讓硬體接手是最後的保險。
為什麼還需要它:五種真實的失效情境
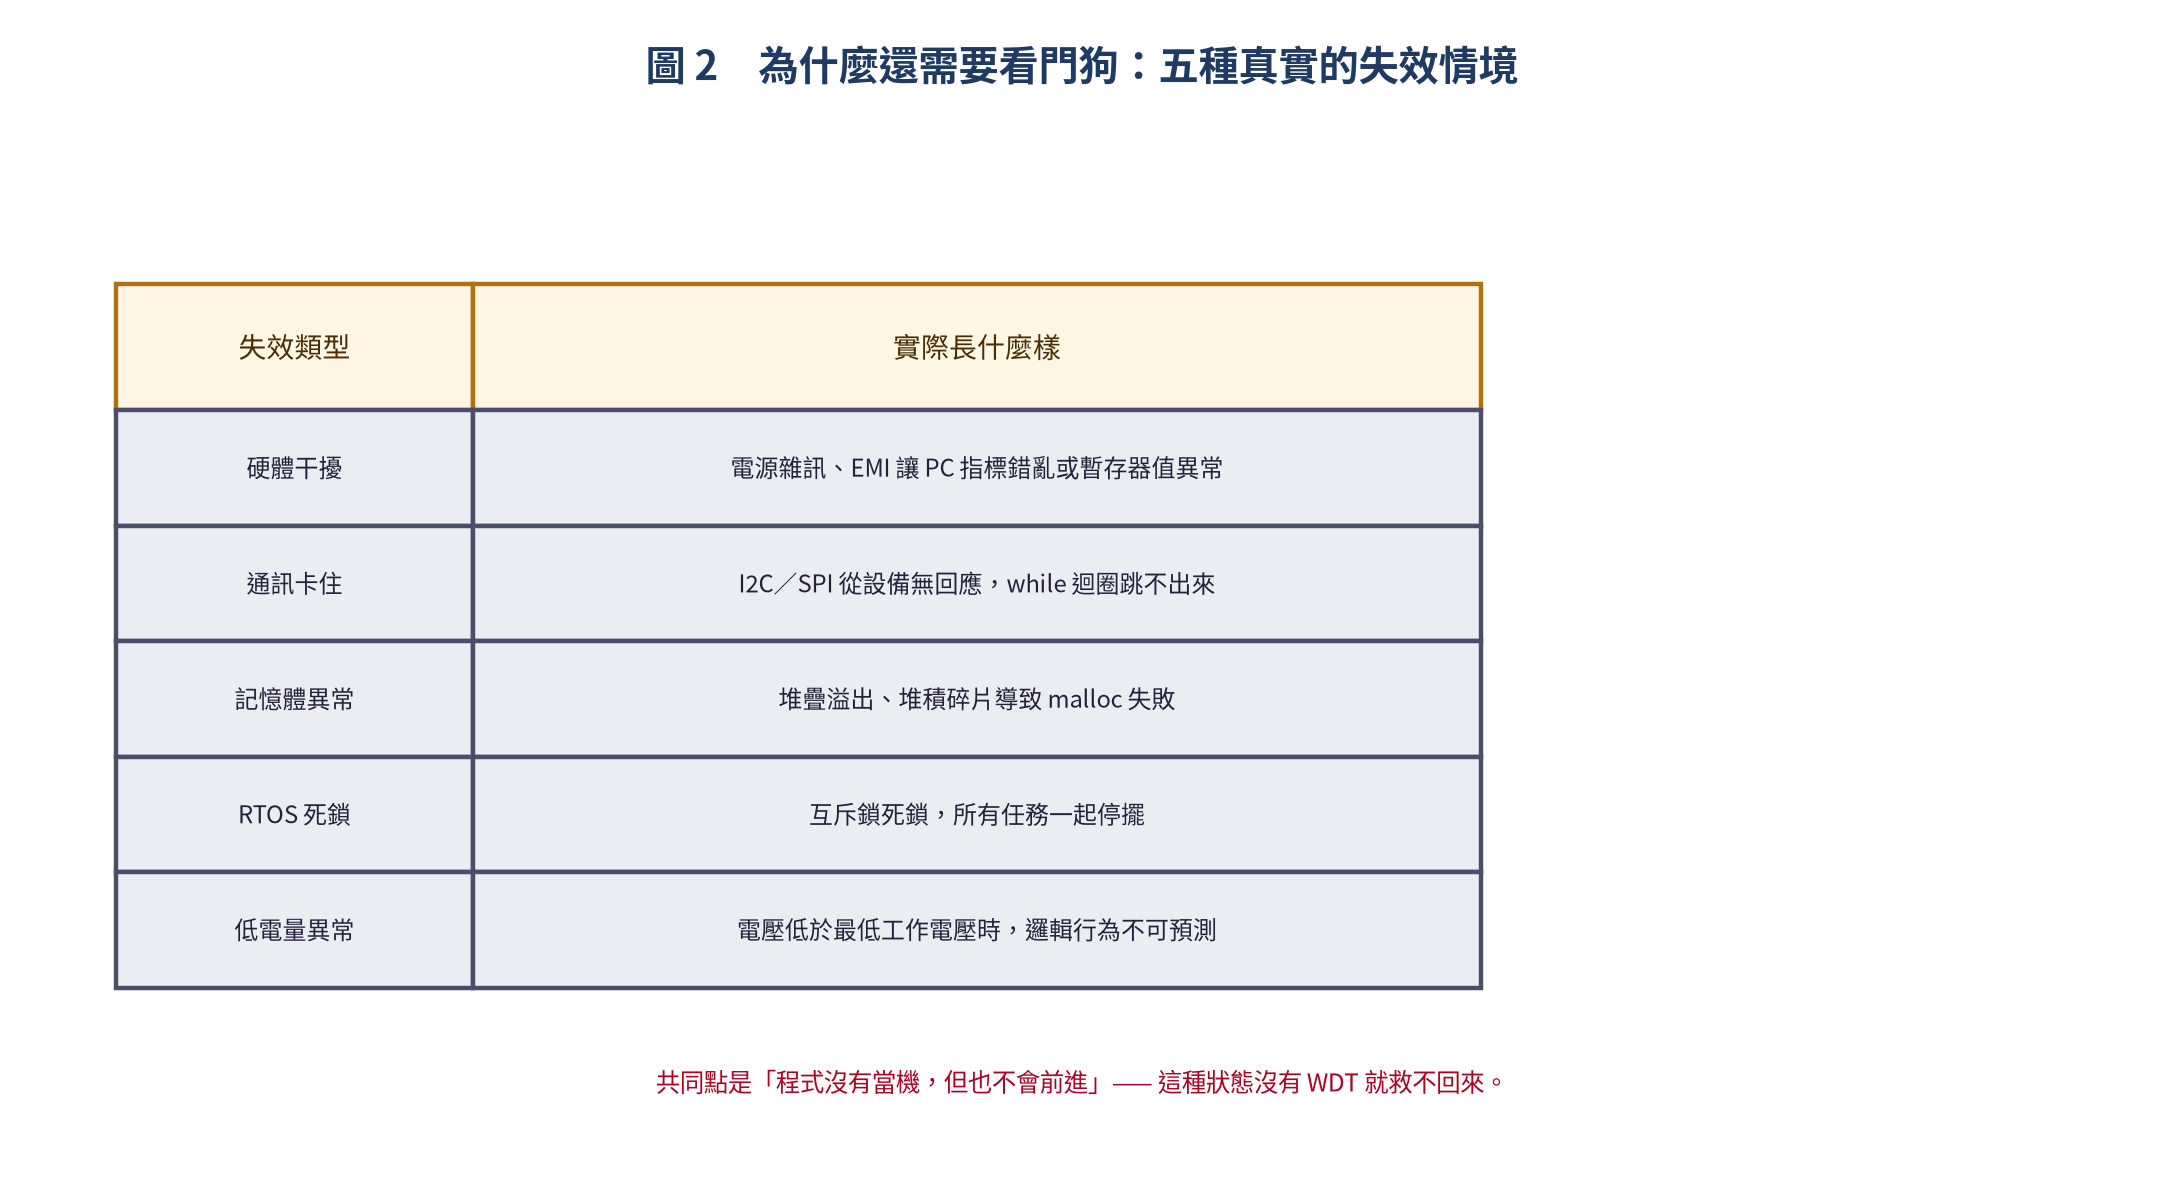
注意這五種情境的共同點:程式沒有當機,只是再也不前進。除錯器看不到例外交代、log 也不再增加,只剩一顆心跳燈還亮著。這種狀態沒有 WDT 就真的救不回來。
STM32 IWDG:獨立到幾乎沒人能救它
STM32 的 IWDG(Independent Watchdog)之所以叫「獨立」,是因為它的時鐘來自獨立的 LSI(約 32 kHz RC 振盪器),不依賴主時鐘。就算你的 PLL 跑掉、主時鐘掛了,它照樣在數。
// stm32_iwdg_wdt.c — STM32 IWDG 初始化與餵狗範例
#include "stm32f1xx_hal.h"

IWDG_HandleTypeDef hiwdg;

// IWDG 初始化:超時約 4 秒 (LSI=32kHz, Prescaler=32, Reload=0xFFF)
void WDT_Init(void)
{
    hiwdg.Instance = IWDG;
    hiwdg.Init.Prescaler = IWDG_PRESCALER_32;     // 32 kHz / 32 = 1 kHz
    hiwdg.Init.Reload    = 0xFFF;                  // 4096 ticks × 1ms = ~4.096 秒
    if (HAL_IWDG_Init(&hiwdg) != HAL_OK)
    {
        Error_Handler();  // IWDG 啟動失敗(通常不會發生)
    }
}

// 餵狗函式 — 主循環中定期調用
void WDT_Feed(void)
{
    HAL_IWDG_Refresh(&hiwdg);  // 寫入 0xAAAA 到 KVR
}

// 注意:IWDG 一旦啟動無法關閉!
// 除非觸發系統復位,否則 WDT 持續運行
設定時最容易卡住的是「超時到底怎麼算」。因為它用 LSI 當來源,所以要先把除頻值與 Reload 換算成實際秒數:
| 除頻值 | LSI=32kHz 時 Prescaler | 最大超時 (4096 ticks) | 典型設定 (Reload=0xFFF) |
|---|---|---|---|
| 4 | 8,192 Hz | 0.5 秒 | 125 μs / tick |
| 8 | 4,096 Hz | 1.0 秒 | 250 μs / tick |
| 16 | 2,048 Hz | 2.0 秒 | 500 μs / tick |
| 32 | 1,024 Hz | 4.0 秒 | 1.0 ms / tick |
| 64 | 512 Hz | 8.0 秒 | 2.0 ms / tick |
| 128 | 256 Hz | 16.0 秒 | 4.0 ms / tick |
| 256 | 128 Hz | 32.0 秒 | 8.0 ms / tick |
這張表建議存起來。實務上最常用的是除頻 32 或 64 那一列 —— 超時落在 4 到 8 秒之間,對絕大多數應用都夠用,又不會因為一次正常的長運算就誤觸發。
還有一個必須知道的特性:IWDG 一旦啟動就不能關。它上電後就永久運行,連除錯時都得自己想辦法處理(後面「常見陷阱」會講)。
ESP32 TWDT:以「任務」為單位的看門狗
ESP32 的設計思路跟 STM32 很不一樣:它的 TWDT(Task Watchdog Timer)監控的是RTOS 任務,而不是整顆系統。
// esp32_twdt.c — ESP32 TWDT 初始化與餵狗範例
#include "freertos/FreeRTOS.h"
#include "freertos/task.h"
#include "esp_task_wdt.h"

// TWDT 初始化:超時 10 秒,監控所有任務
void WDT_Init(void)
{
    // 初始化 TWDT,超時 10 秒
    esp_task_wdt_config_t twdt_config = {
        .timeout_ms = 10000,          // 10 秒超時
        .trigger_panic = true,        // 超時時觸發 panic(系統復位)
    };
    ESP_ERROR_CHECK(esp_task_wdt_init(&twdt_config));

    // 將當前任務註冊到 TWDT 監控
    ESP_ERROR_CHECK(esp_task_wdt_add(NULL));  // NULL = 當前任務
}

// 餵狗函式 — 在任務主循環中定期調用
void WDT_Feed(void)
{
    esp_task_wdt_reset();  // 重置當前任務的 WDT 計數器
}

// 任務範例:處理感測器資料
void sensor_task(void *pvParameters)
{
    WDT_Init();  // 註冊此任務到 TWDT

    while (1) {
        read_sensor_data();       // 讀取感測器
        process_data();           // 資料處理
        send_via_mqtt();          // MQTT 發送
        WDT_Feed();               // 餵狗
        vTaskDelay(pdMS_TO_TICKS(100));  // 100ms 延遲
    }
}

// 注意:TWDT 預設監控 IDLE 任務
// 若 IDLE 任務未得到 CPU 時間(高優先級任務霸佔 CPU),TWDT 也會觸發
差別在哪?當 TWDT 觸發時,它可以告訴你是哪個任務卡住;而 STM32 的 IWDG 只會給你一句「系統復位了,原因不明」。在複雜的多任務系統裡,這個差異會省下好幾天除錯時間。
除了 TWDT,ESP32 還有另外兩顆看門狗:
// esp32_iwdt.c — 中斷看門狗設定
#include "soc/cpu.h"
#include "esp_intr_alloc.h"

// IWDT 超時時間設定(ISP 級別)
void IWDT_Init(void)
{
    // IWDT 在 ESP32-IDF 中預設啟用
    // 可在 menuconfig 中設定超時:
    //   CONFIG_ESP_INT_WDT_TIMEOUT_MS=300
    //   CONFIG_ESP_INT_WDT=y

    // IWDT 會在 ISR 執行超過設定時間時觸發 panic
    // 幫助開發者找出耗時過長的中斷處理程式
    printf("IWDT active: interrupt watchdog enabled\n");
}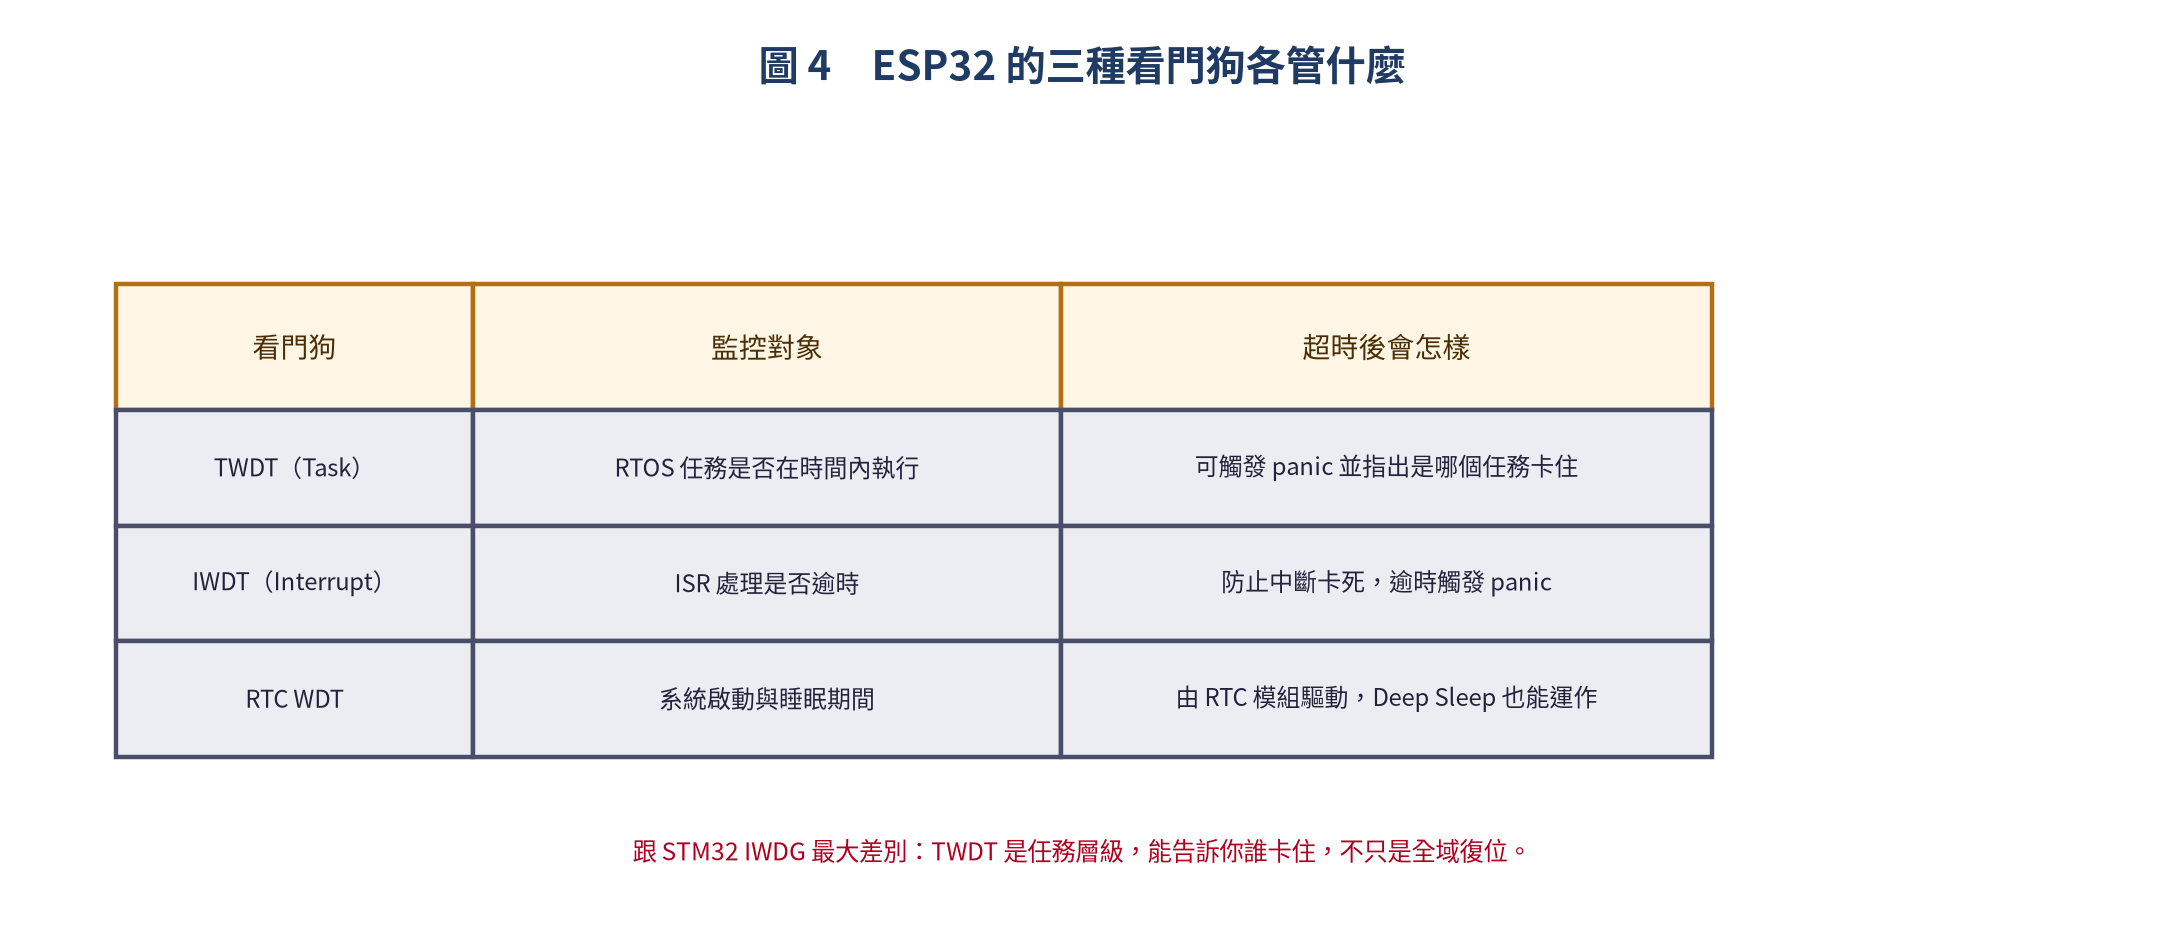
其中 IWDT 值得特別提一下:它監控的是中斷服務程式。中斷寫太長、卡在裡面,整個系統的即時性就毀了 —— IWDT 就是專門來抓這種問題的。
觸發之後:先問「是誰讓我重啟的」
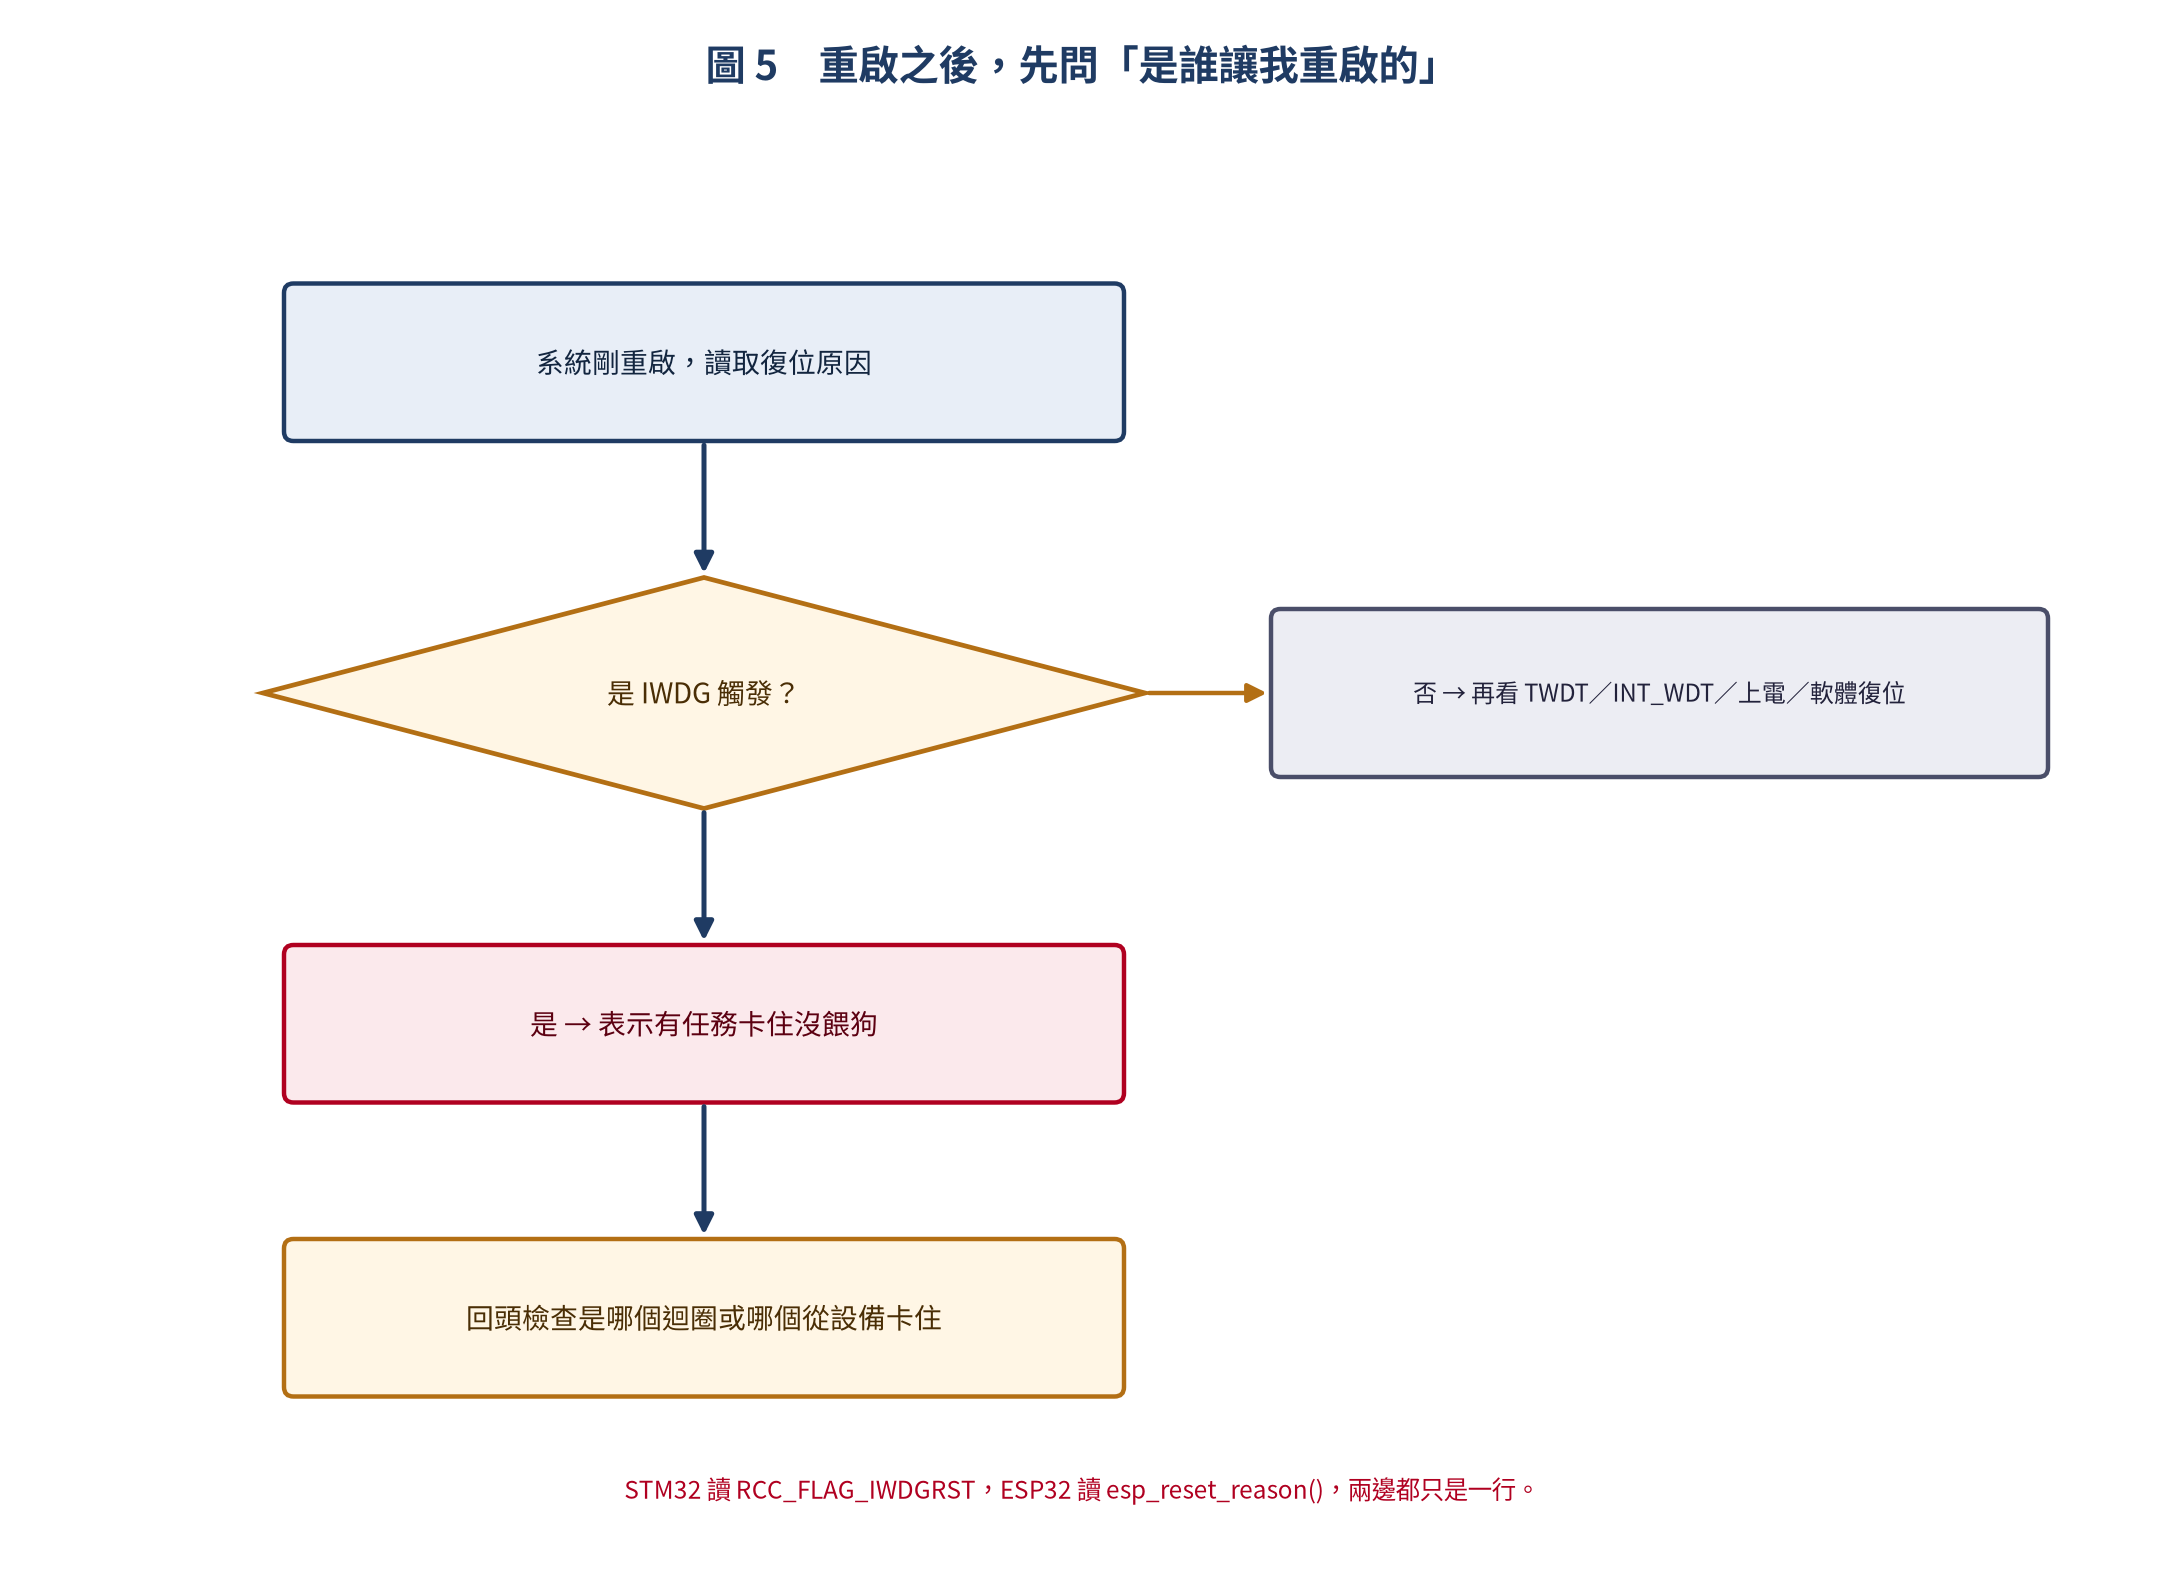
// STM32 — 檢查復位原因
if (__HAL_RCC_GET_FLAG(RCC_FLAG_IWDGRST)) {
    printf("系統復位:IWDG Watchdog 觸發!\n");
}
__HAL_RCC_CLEAR_RESET_FLAGS();

// ESP32 — 檢查復位原因
esp_reset_reason_t reason = esp_reset_reason();
if (reason == ESP_RST_WDT) {
    printf("系統復位:Task Watchdog 觸發!\n");
} else if (reason == ESP_RST_INT_WDT) {
    printf("系統復位:Interrupt Watchdog 觸發!\n");
}這一段程式碼應該放在每一支韌體的最前面。原因很簡單:沒有它,你永遠不知道這次重啟是看門狗救回來的,還是有人拔了電源。而這兩件事要處理的方向完全不同。
STM32 與 ESP32 的看門狗比一比
兩邊的設計哲學差很多,這張表是最快的理解方式:
| 項目 | STM32 IWDG | ESP32 TWDT |
|---|---|---|
| 時鐘源 | 獨立 LSI (32 kHz RC) | RC 振盪器 (~615 kHz) |
| 計數器 | 12-bit 遞減 (0~4095) | 32-bit 遞增 (0~2³²) |
| 除頻器 | 4/8/16/32/64/128/256 | 無硬體除頻 |
| 最長超時 | ~26.3 秒 (÷256 × 4096) | ~7 秒 |
| 監控粒度 | 硬體層級(系統全域) | 任務層級(可指定任務) |
| 可否關閉 | 不可(啟動後永久運行) | 可(esp_task_wdt_deinit) |
| 低功耗支援 | Stop/Standby | Active/Modem-sleep |
| 復位方式 | 硬體復位(不可遮罩) | 硬體復位 / panic 中斷 |
看幾件事就好:STM32 的 IWDG 不可關閉、最長可達 26.3 秒、監控粒度是整顆系統;ESP32 的 TWDT 可以關、最長約 7 秒、但能精確到任務層級。
這兩種取捨沒有誰對誰錯:要「絕對不會被軟體關掉的保險」就選 IWDG 那條路;要「知道是誰卡住、還能針對單一任務監控」就是 TWDT 的強項。工業級產品通常兩個都開。
進階:多層架構與餵狗策略
先看架構。單一顆看門狗只能救「大部分」的失效,真正要求可靠度的產品會這樣疊:
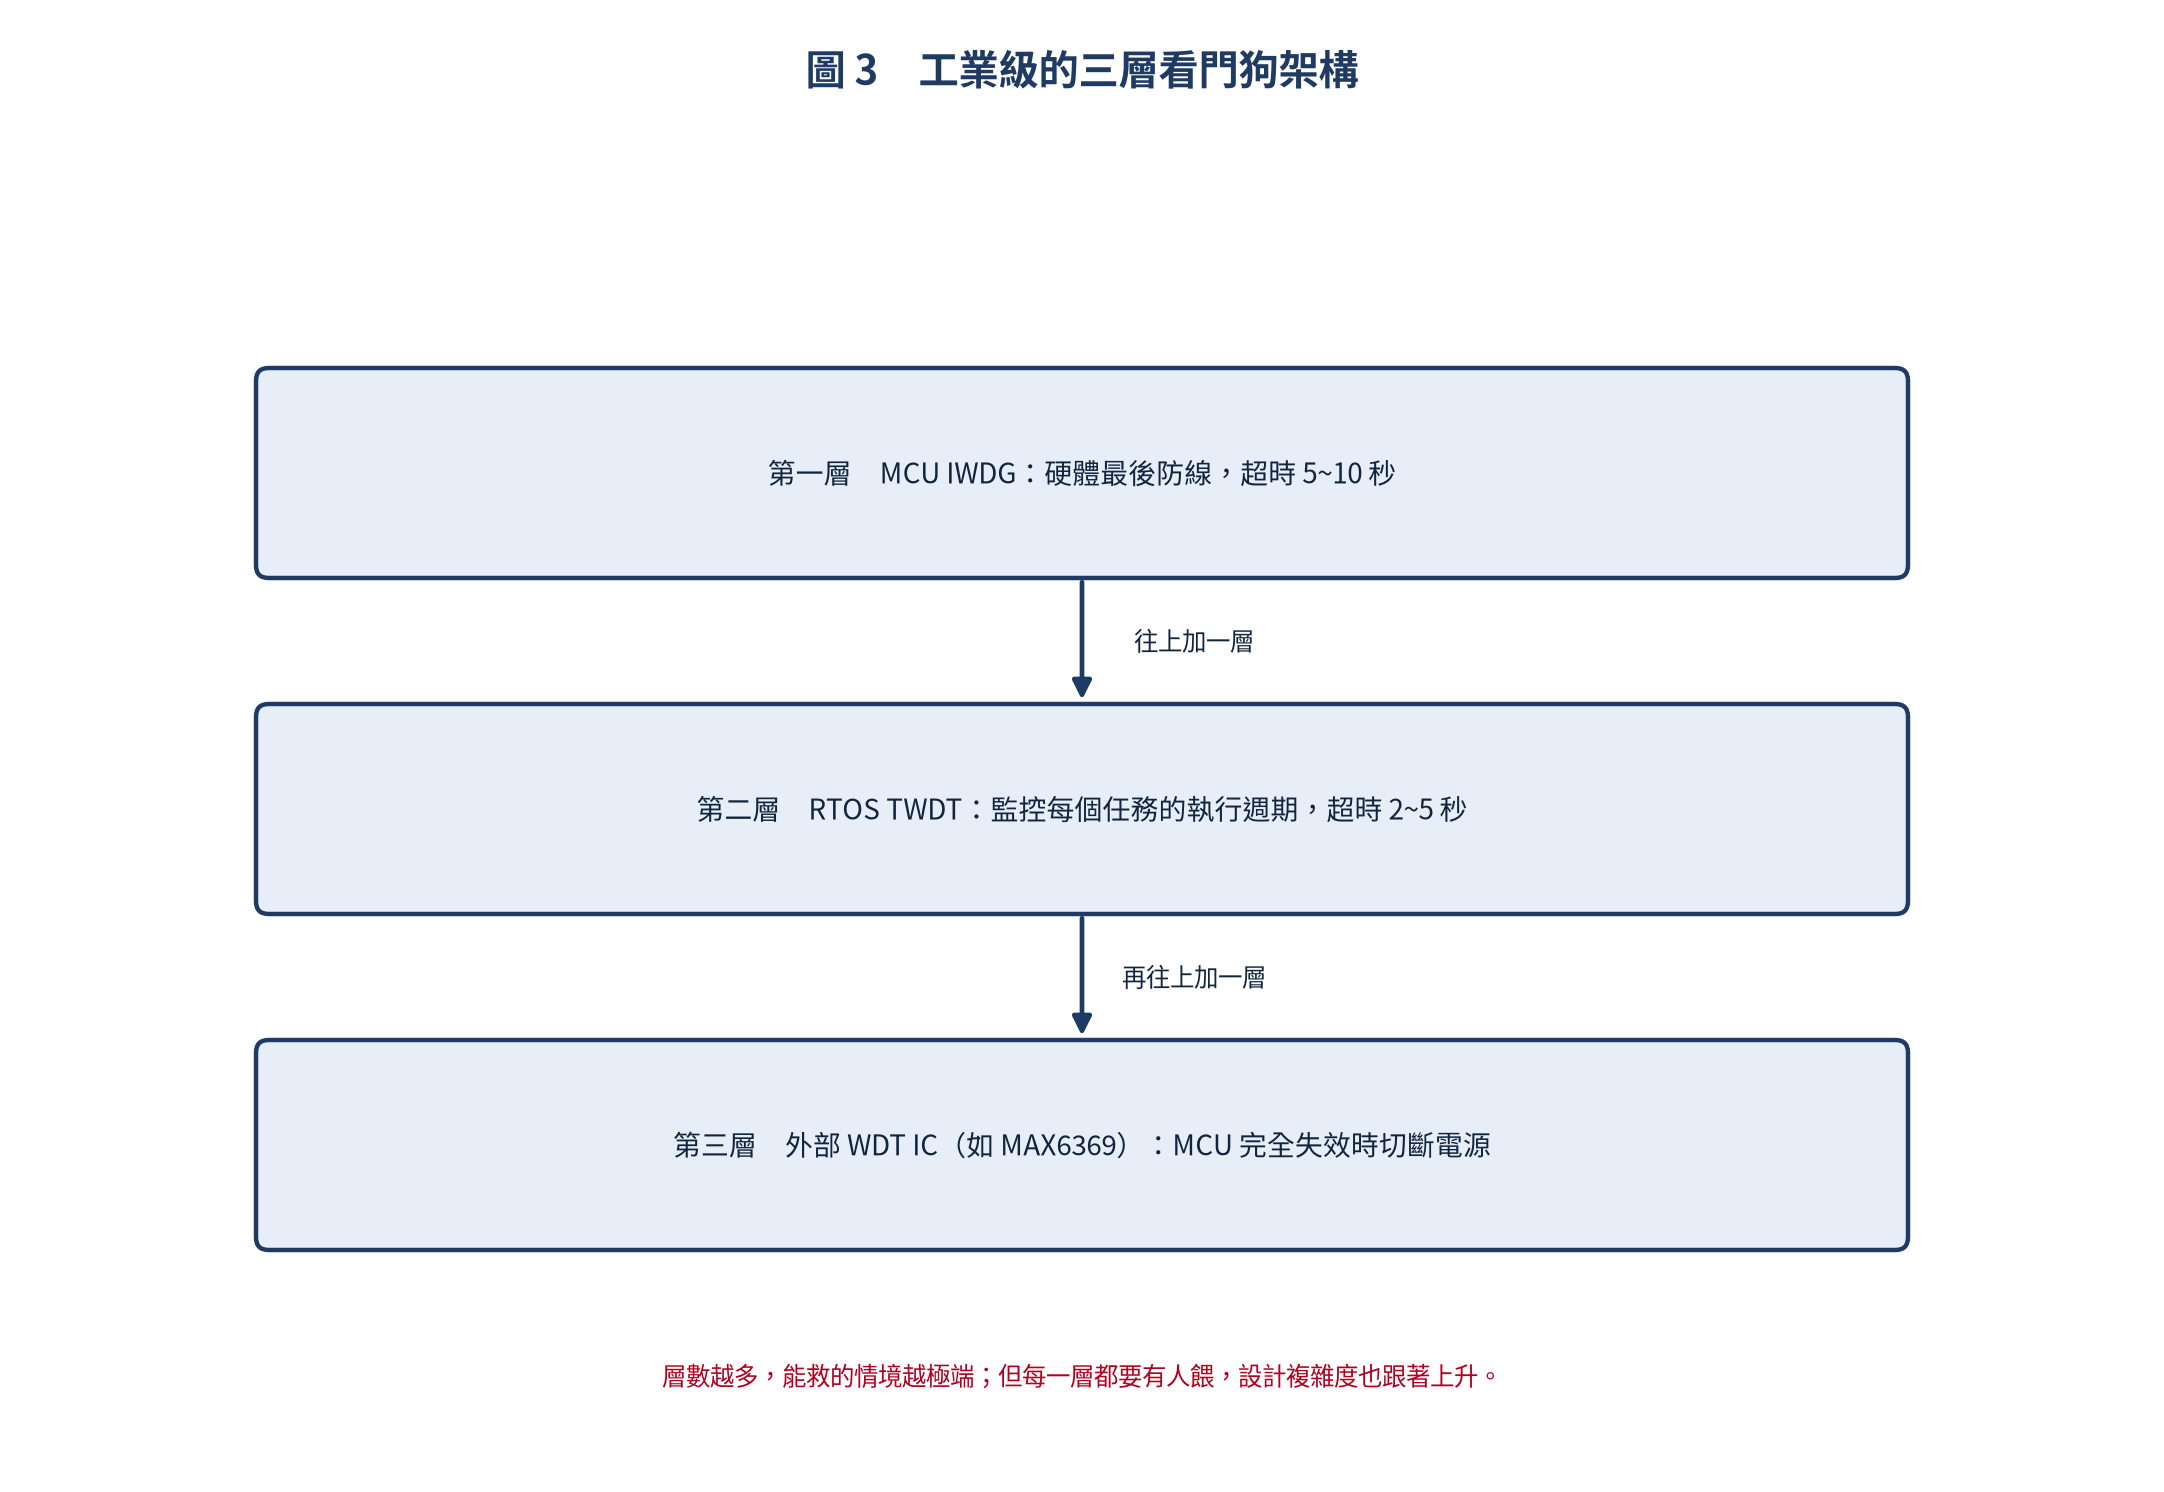
接著是餵狗的位置 —— 這件事比「餵幾次」重要得多:
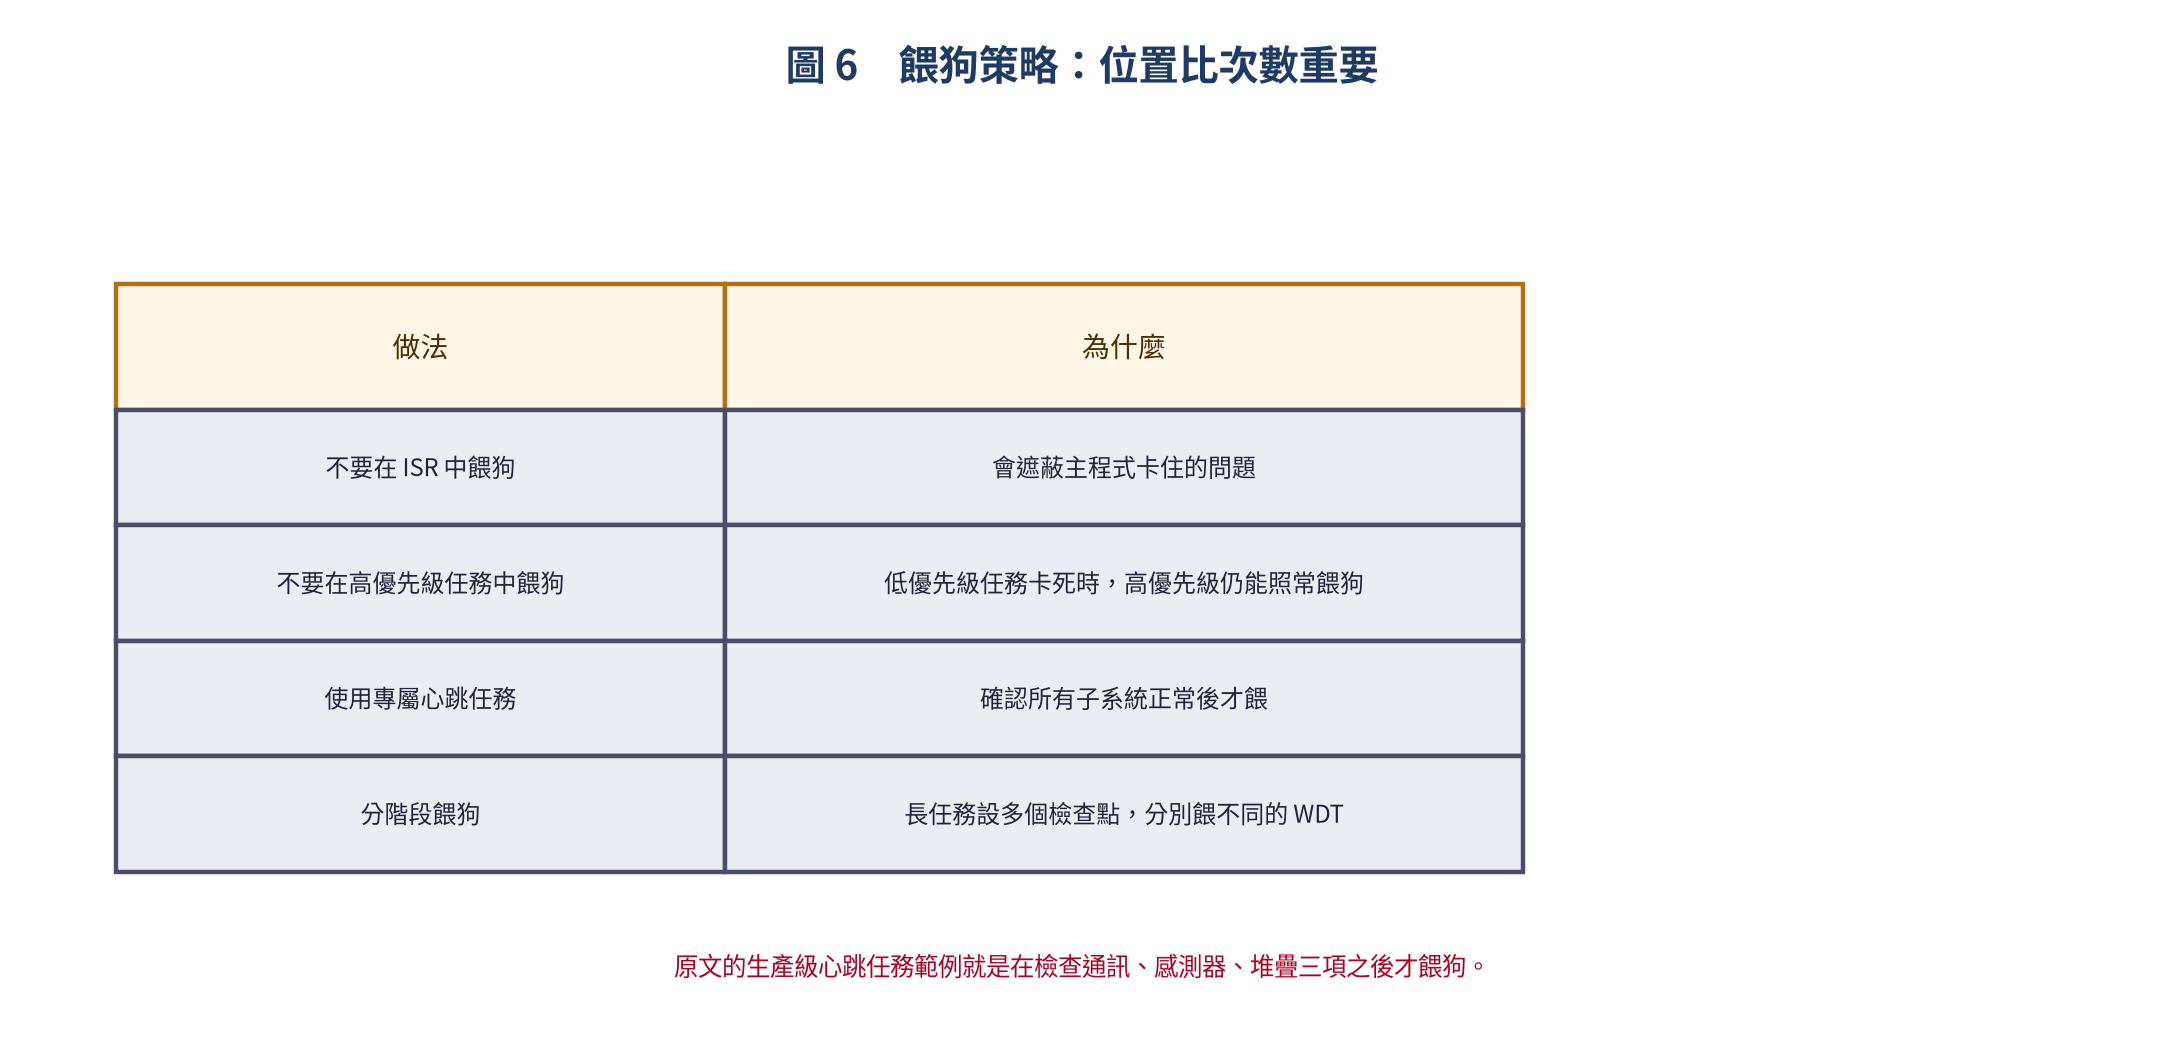
原文提供的生產級範例值得完整看一遍,它把「心跳任務」的邏輯寫得很清楚:只有在通訊、感測器、堆疊三項都正常時才餵狗;任何一項異常就只記錄、不餵,讓看門狗自己動手。
// heartbeat_task.c — 生產級心跳監控任務
void heartbeat_task(void *pvParameters)
{
    TickType_t last_wake = xTaskGetTickCount();
    const TickType_t interval = pdMS_TO_TICKS(1000);  // 1 秒

    while (1) {
        vTaskDelayUntil(&last_wake, interval);

        // 檢查各子系統狀態
        bool comm_ok     = (HAL_GetTick() - last_comm_tick < 5000);
        bool sensor_ok   = (sensor_error_count < 3); bool stack_ok = (uxTaskGetStackHighWaterMark(NULL) > 128);

        if (comm_ok && sensor_ok && stack_ok) {
            WDT_Feed();  // 所有子系統正常,餵狗
            led_green_on();
        } else {
            led_red_on();
            // 記錄錯誤但不餵狗,讓 WDT 復位
            log_error("System unhealthy: comm=%d sensor=%d stack=%d",
                      comm_ok, sensor_ok, stack_ok);
        }
    }
}
這段程式碼最漂亮的地方是:它把「系統健康判斷」與「處置」分開了。判斷交給心跳任務,處置交給硬體 —— 軟體再怎麼錯,也無法阻止硬體把自己重開。
四個會讓你懷疑人生的陷阱
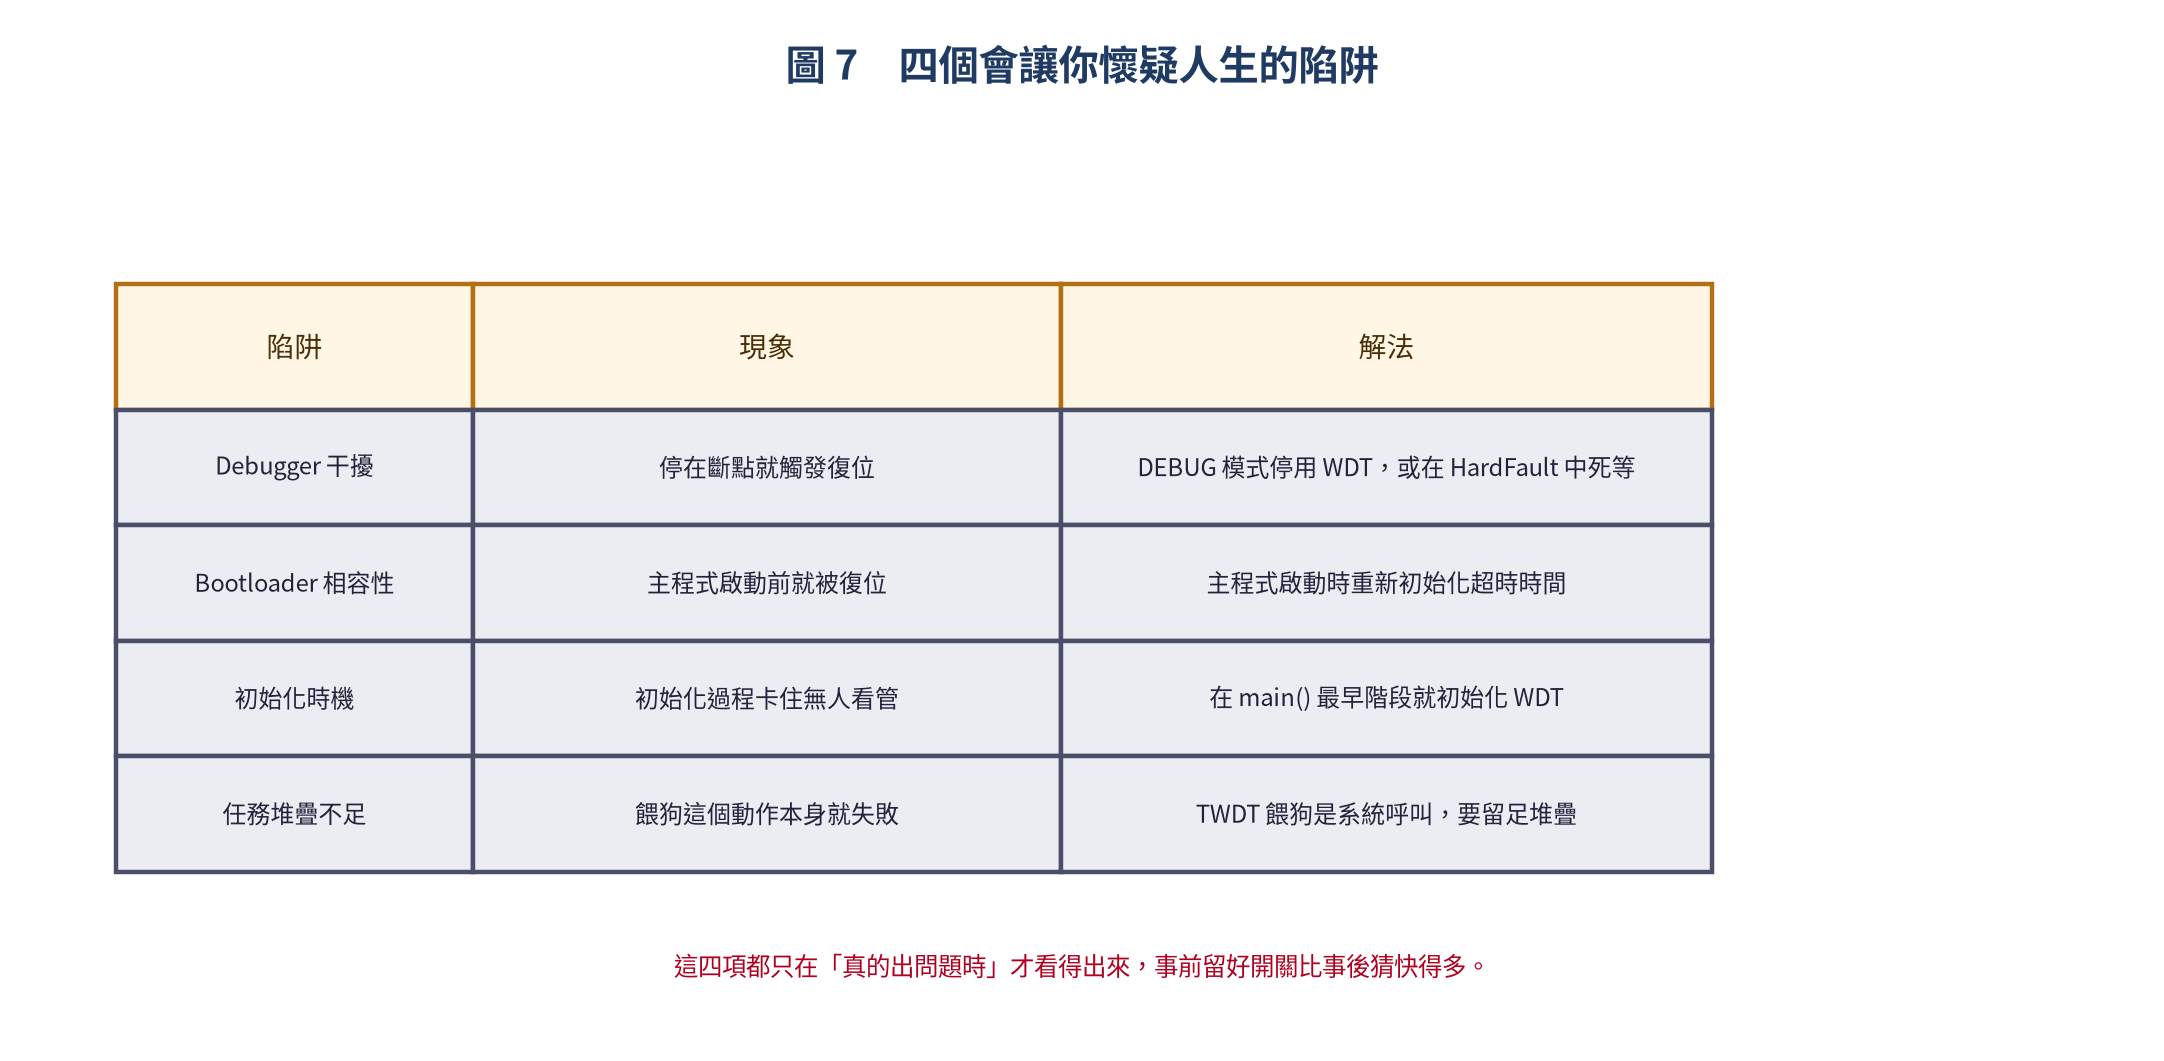
其中 Debugger 那一項幾乎每個人第一次用都會中:你停在斷點思考人生,看門狗也在思考人生 —— 然後把你重開。解法很簡單,在 DEBUG build 把 WDT 關掉,或是在 HardFault_Handler 裡直接死等。
總結
看門狗是那種「平常完全無感、出事時救命」的機制。四個重點收好:
- 它的前提是軟體會壞:所以救援工作交給硬體
- 餵狗的位置比次數重要:別在 ISR、別在高優先級任務餵
- 復位原因一定要記錄:不然你永遠在猜
- 要求可靠度就疊多層:MCU 硬體層、RTOS 任務層、外部 IC 各司其職
下次你的裝置在客戶那裡掛掉時,你會感謝自己當初多寫了那三行。

文章評論