先講一件我踩過的事:我以前寫 UART 收資料,用中斷一個 byte 一個 byte 接,接完再自己塞進緩衝。等到要同時跑 ADC 連續取樣跟通訊,CPU 就開始喘了 —— 明明時脈沒變、程式也沒寫錯,就是資料一多就掉資料。
問題不在演算法,在「搬資料」這件事本身就吃掉了 CPU 的每一分力氣。DMA 傳輸(Direct Memory Access,直接記憶體存取)要解決的就是這個:讓周邊設備自己去跟記憶體交換資料,CPU 只負責下指令跟收結果。
什麼是 DMA?為什麼需要它?
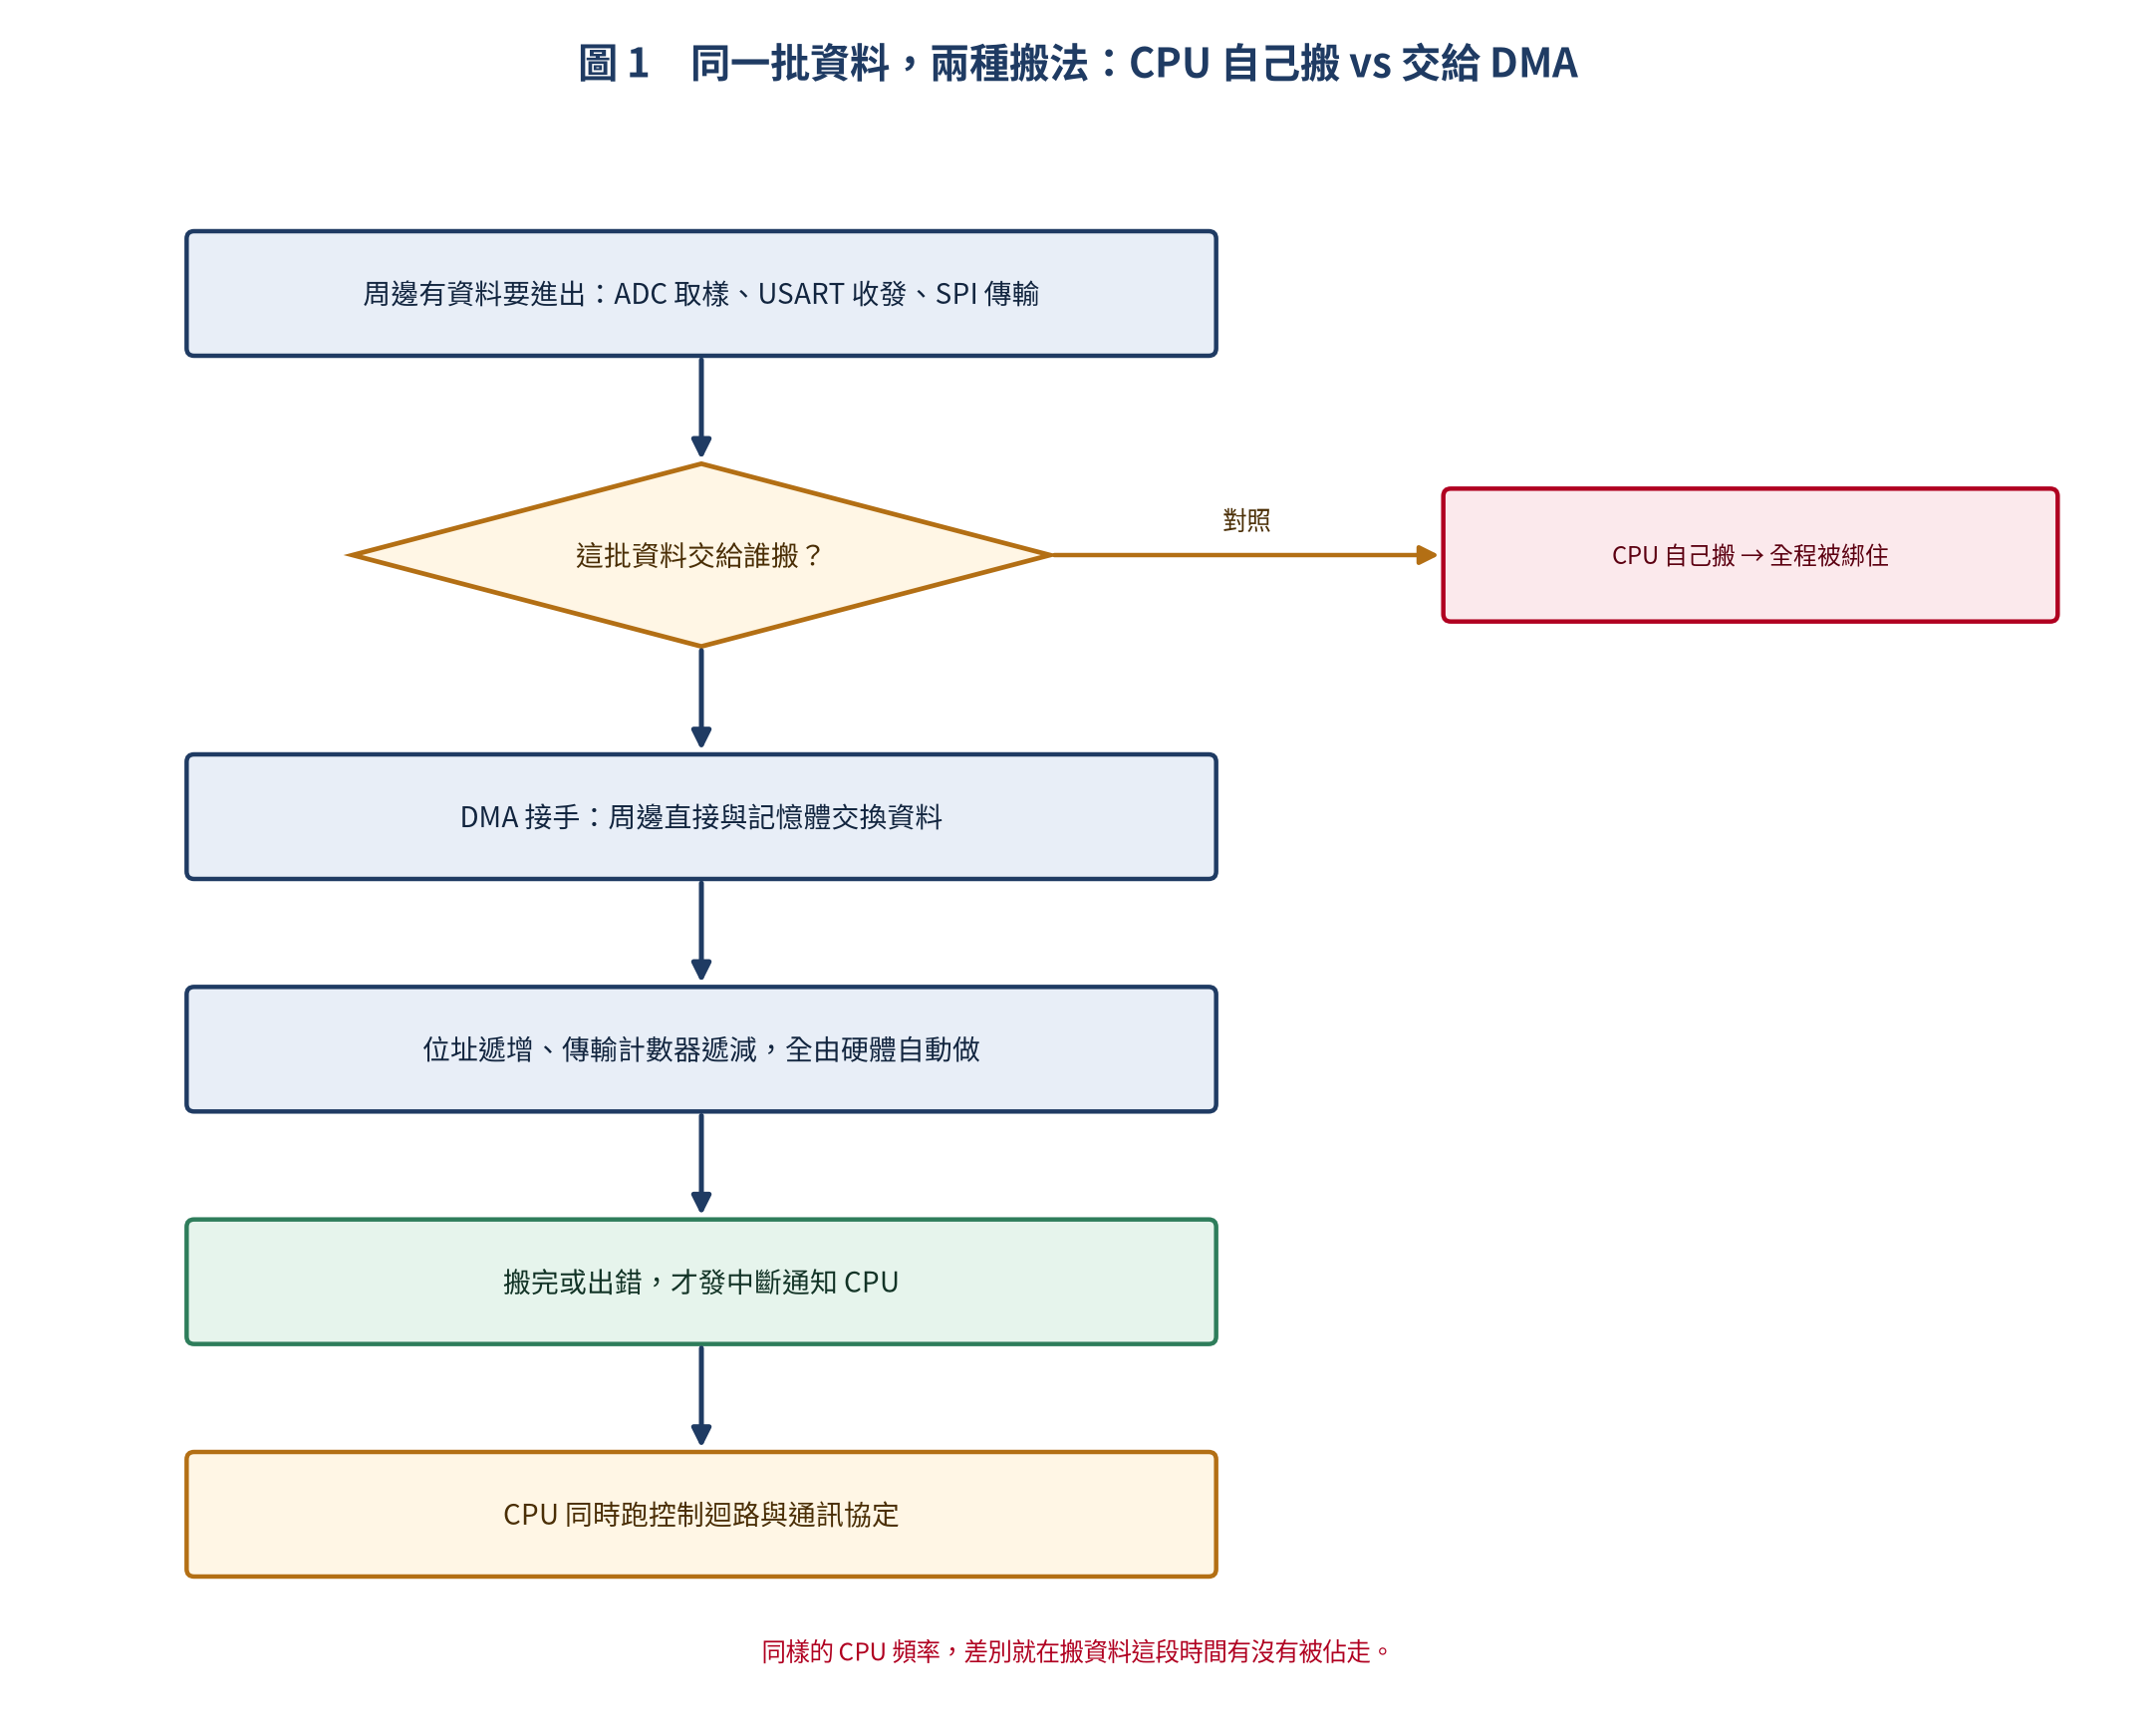
先看沒有 DMA 的時候,我們在做什麼。傳統的程式 I/O 模式裡,CPU 必須逐字節、逐字地把資料從周邊讀進來再寫進記憶體。你寫的每一行收資料的程式碼,本質上都在做同一件事 —— 當搬運工。
當搬運工不丟臉,丟臉的是代價:
- CPU 被「綁架」在資料搬運上,其他事情都別想做了
- 高頻率的資料傳輸(例如 ADC 1 MSps)會把 CPU 頻寬直接吃光
- 控制迴路、通訊協定這類講究即時性的任務,會被搬運排隊排到延遲
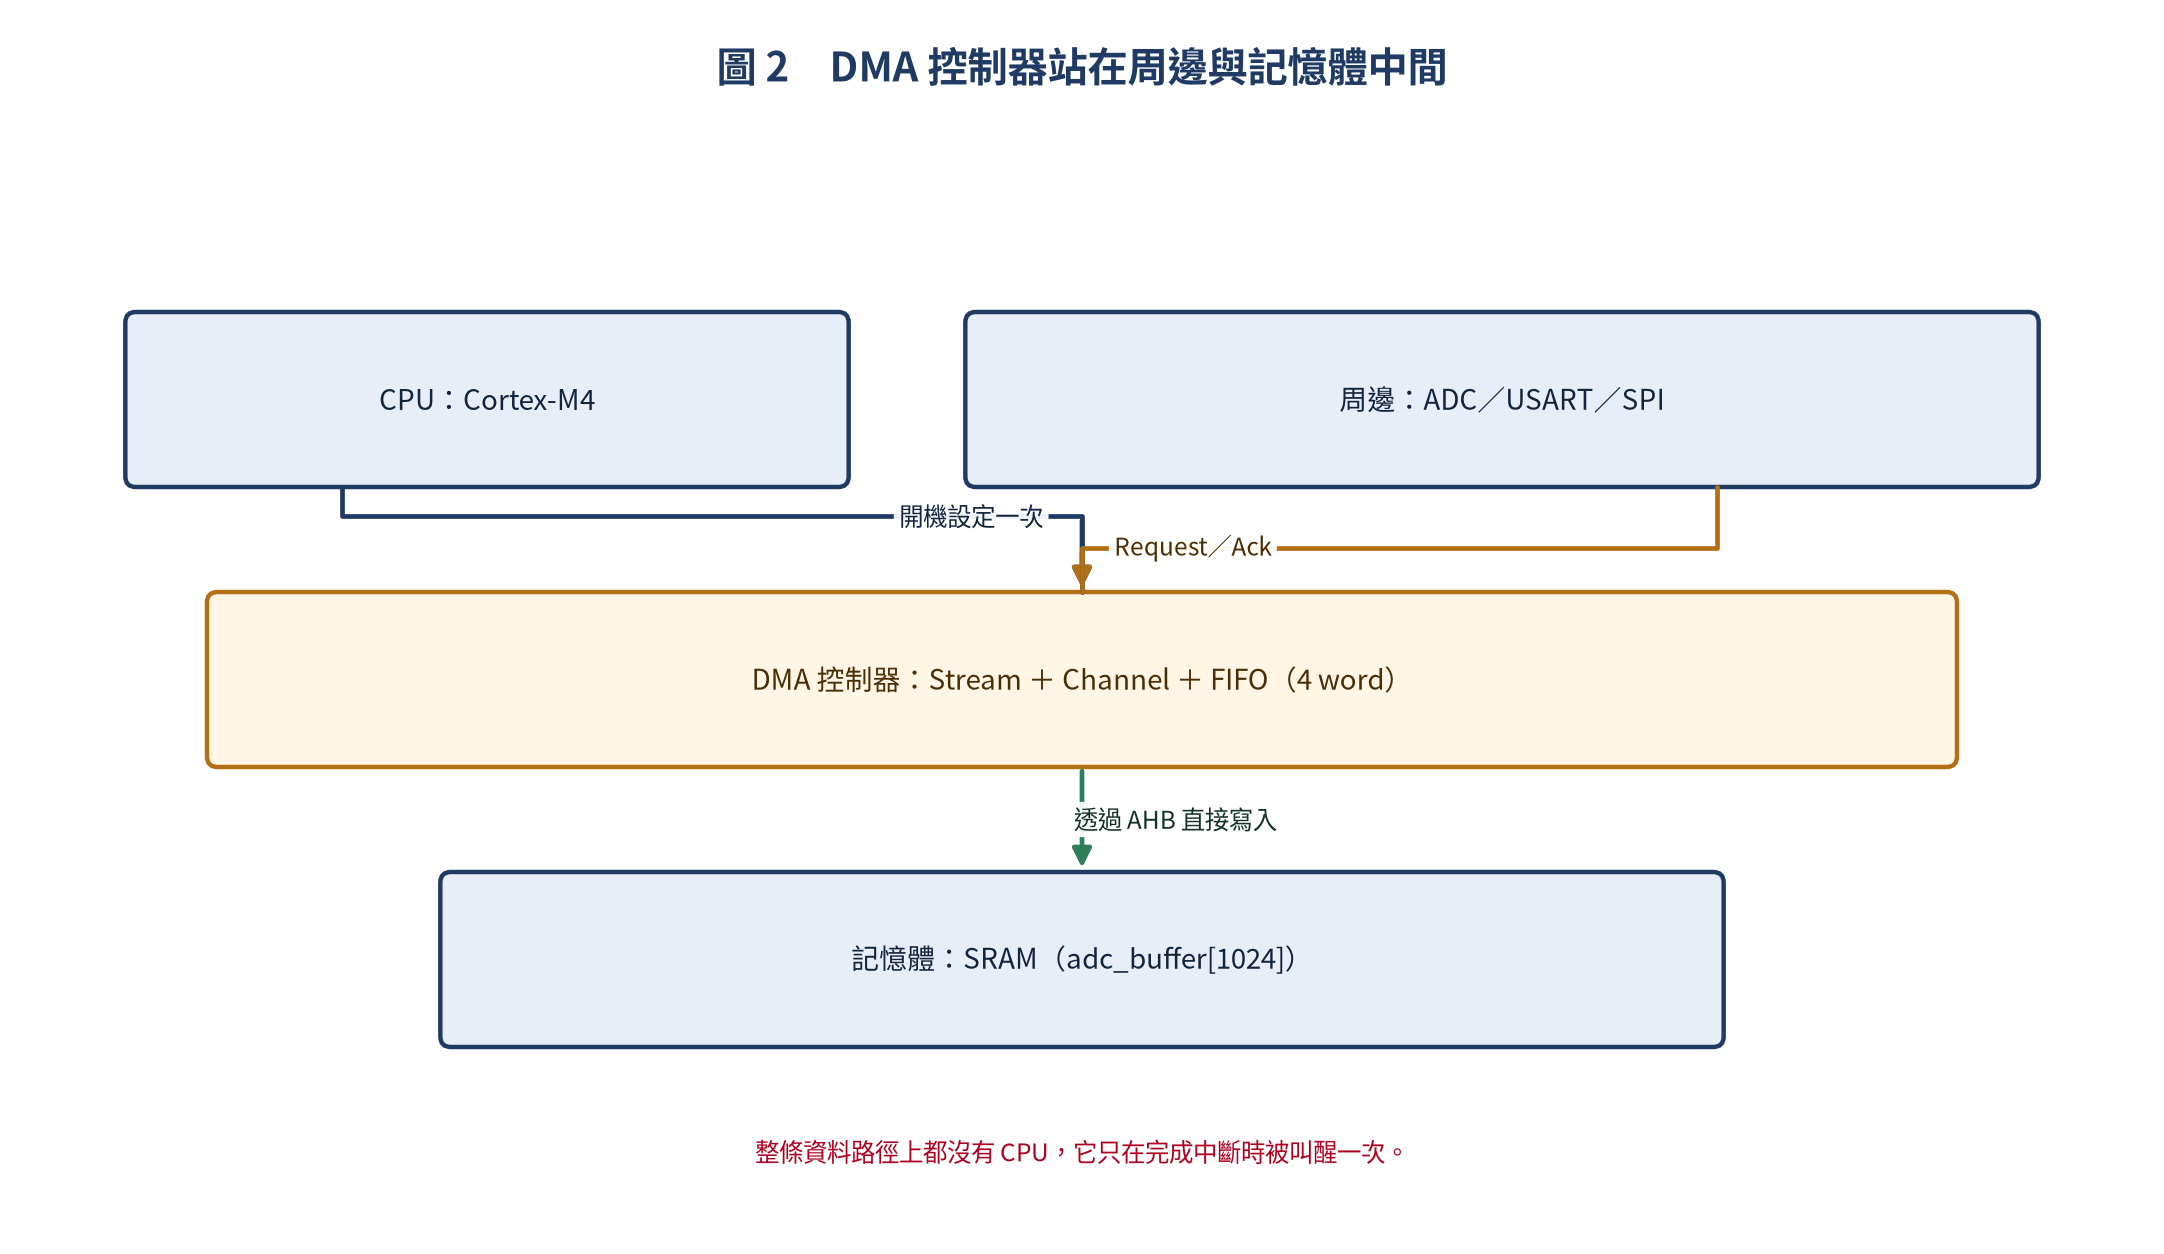
DMA 控制器就是專門為這件事做的一顆「資料搬運引擎」。它在背景自己完成記憶體與周邊之間的傳輸,平常不吵你,只在傳輸完成或發生錯誤的時候才通知 CPU。所以下面這篇文章,我從硬體架構開始講,再講傳輸模式、配置流程,最後用 STM32 跟 ESP32 各寫一份完整的程式。
DMA 控制器架構
把它想成「站在周邊與記憶體中間的一個獨立角色」就很好懂了。周邊有資料要進或要出,是它去接手;而 CPU 只需要在開機的時候把規則講清楚一次,之後就可以完全放手。
以 STM32F4 為例,DMA2 有 8 個 Stream(資料流),每個 Stream 又有 8 個 Channel(通道)。這幾個名詞第一次看會很亂,但其實原文這張表就已經講完了:
| 元件 | 說明 |
|---|---|
| DMA 控制器 | STM32F4 有 DMA1 和 DMA2,共 16 個 Stream |
| Stream(資料流) | 每個 Stream 管理一組傳輸,可配置優先級 |
| Channel(通道) | 每個 Stream 可選 8 個觸發源之一(如 USART_TX、SPI_RX) |
| FIFO | 每個 Stream 有 4 word FIFO,用於資料寬度匹配 |
| 傳輸計數器 | 每次傳輸遞減,歸零時觸發完成中斷 |
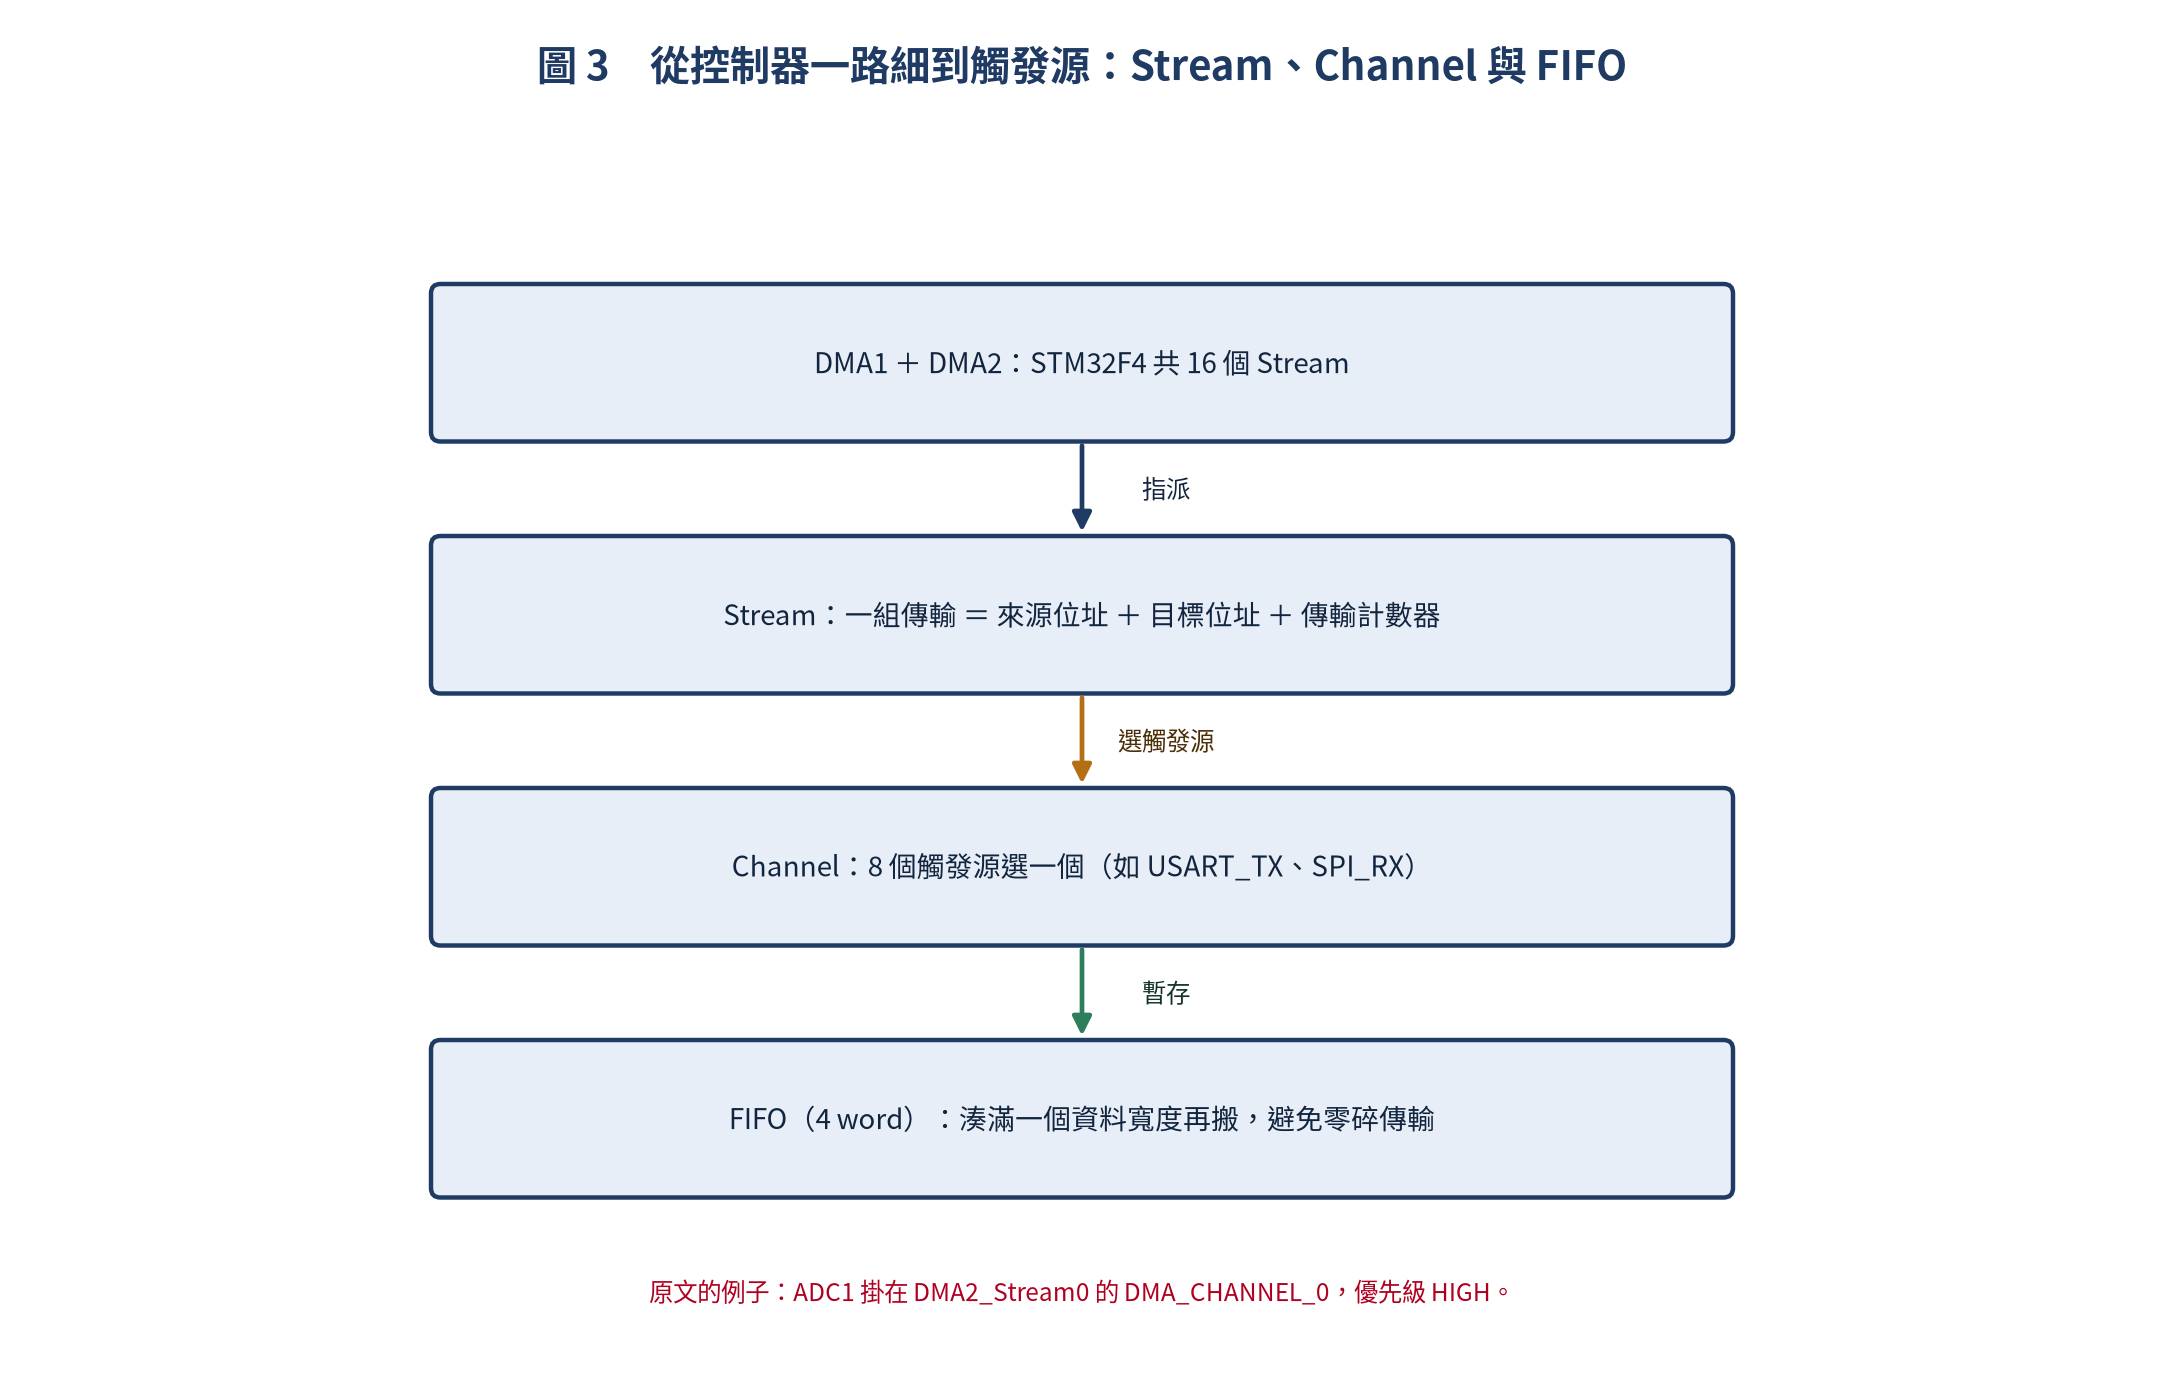
我自己的記法是這樣:Stream 是「一條搬運路線」,Channel 是「這條路線給誰用」,FIFO 則是「先把貨湊齊再上車」。所以你會看到程式裡寫 DMA2_Stream0、DMA_CHANNEL_0、Priority 這三樣東西是綁在同一組設定裡的 —— 它們講的其實是同一條路線的三個面向。
DMA 傳輸類型
方向只有四種,名字都是縮寫,拆開來看就沒什麼好怕的:
- M2M(Memory-to-Memory):記憶體對記憶體,等於硬體版的 memcpy
- M2P(Memory-to-Peripheral):記憶體送到周邊,例如 SPI 發送、DAC 輸出
- P2M(Peripheral-to-Memory):周邊送進記憶體,例如 ADC 取樣、UART 接收
- P2P(Peripheral-to-Peripheral):周邊直接對周邊,只有部分系列支援
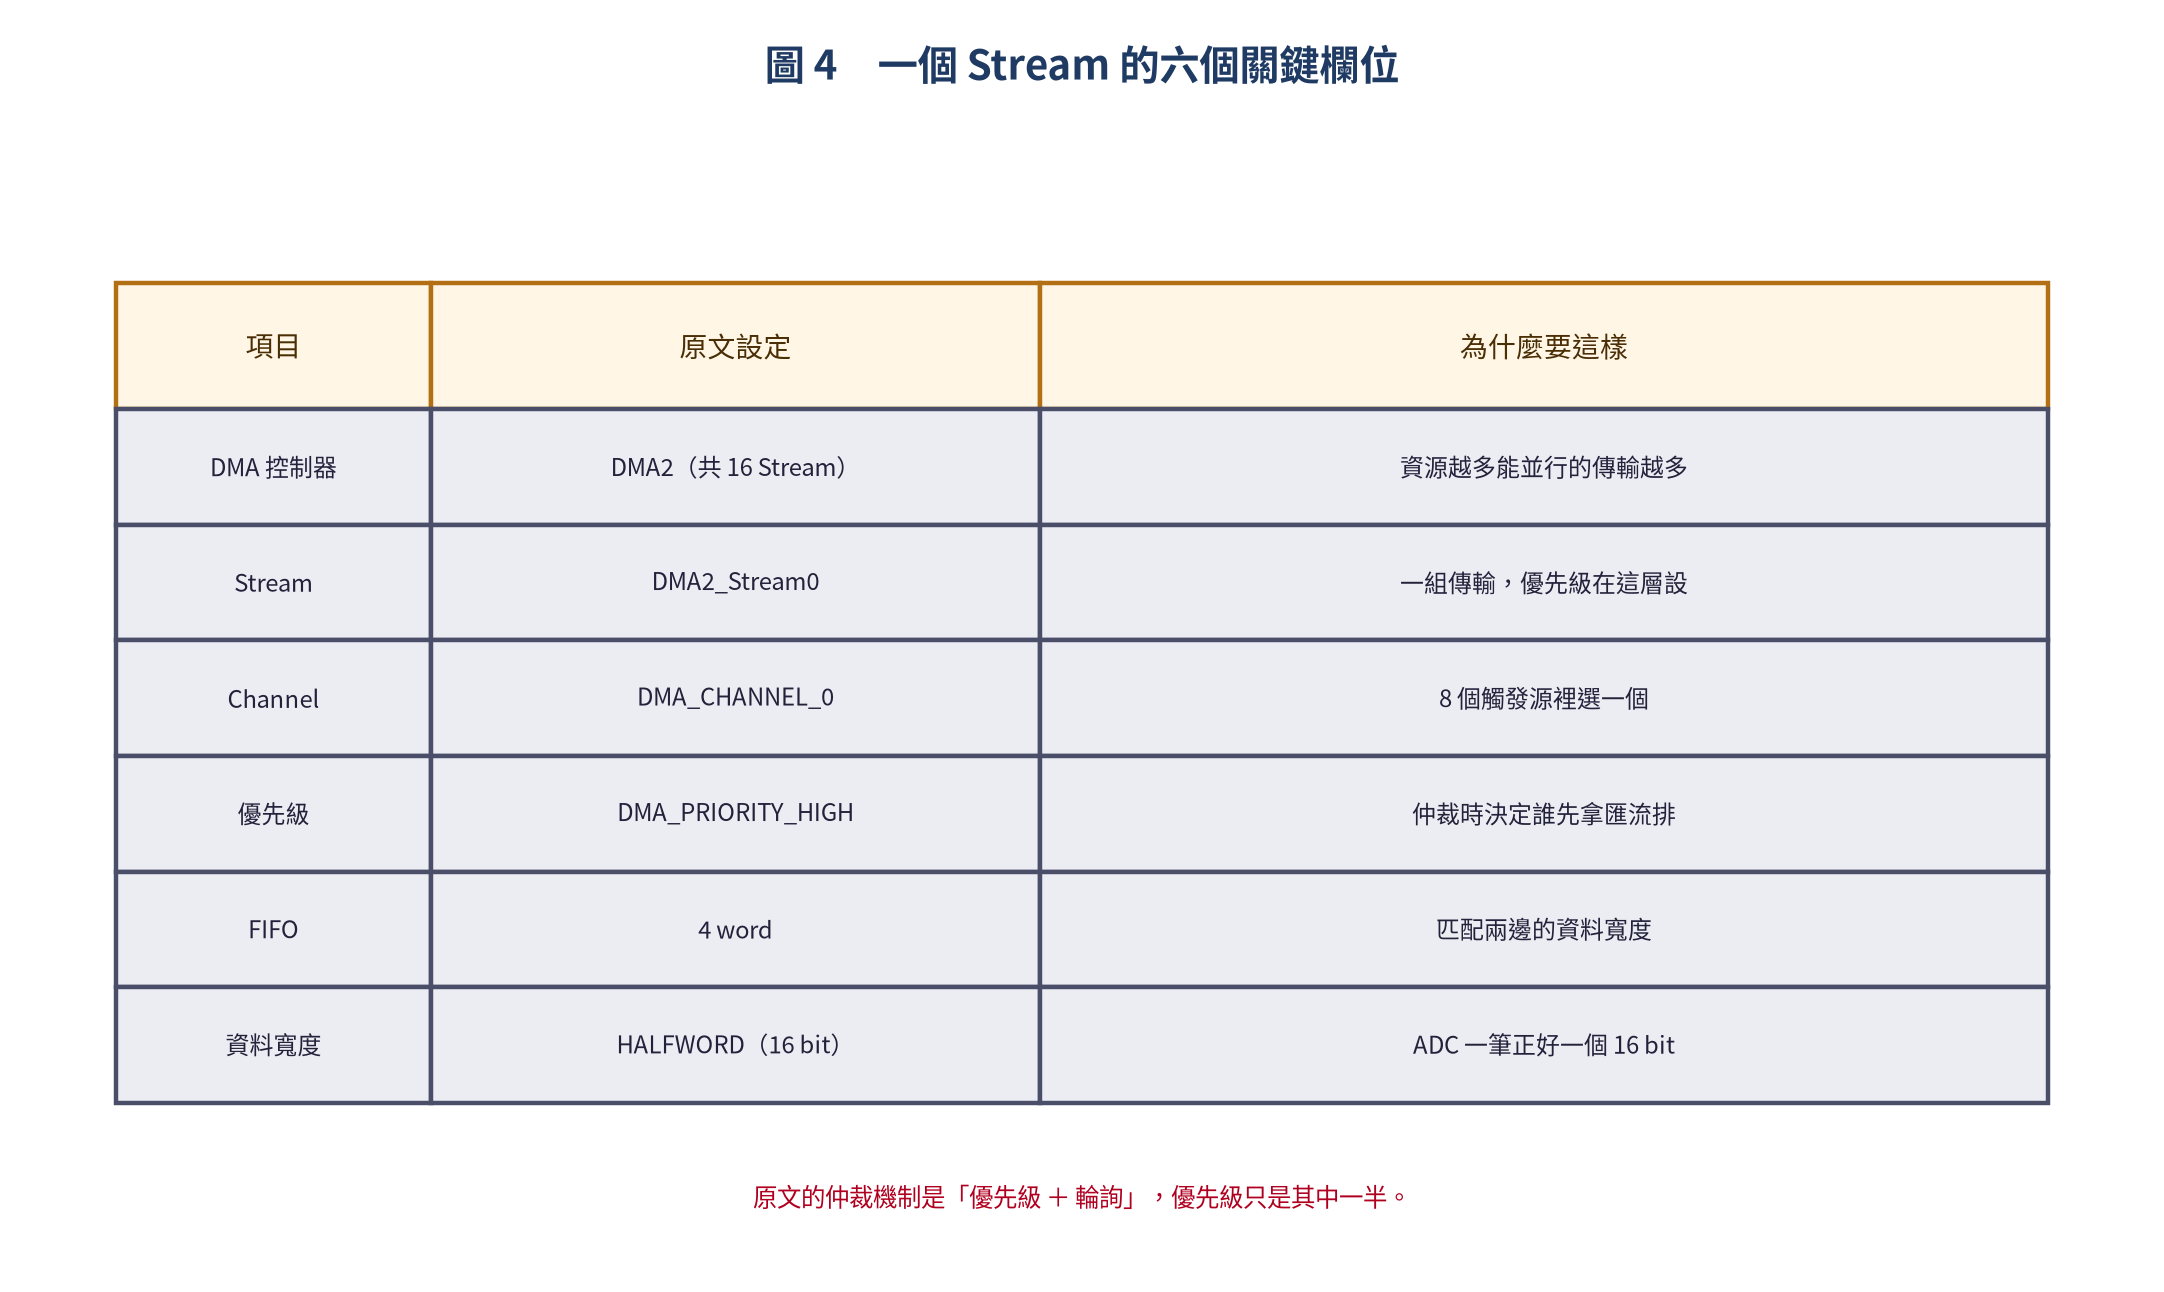
這張表是我的私房檢查清單。方向只是其中一格,真正讓人在半夜 debug 的是優先級、資料寬度跟 FIFO 這幾格 —— 之後 HAL 初始化那段程式碼看起來很長,其實就是在填這些格子。
DMA 請求/確認握手機制
DMA 不是「CPU 說搬就馬上搬」,它是周邊跟 DMA 控制器之間打招呼換來的。當周邊(例如 USART)的 RX 寄存器收到一個字節,流程是這樣跑的:
- 周邊拉高 DMA Request 訊號
- DMA 控制器開始仲裁(看優先級,也看輪詢)
- DMA 回一個 Ack,拿到匯流排控制權
- DMA 從周邊的資料寄存器把資料讀出來,寫進記憶體位址
- 位址遞增、傳輸計數器遞減
- 釋放匯流排,等下一次 Request
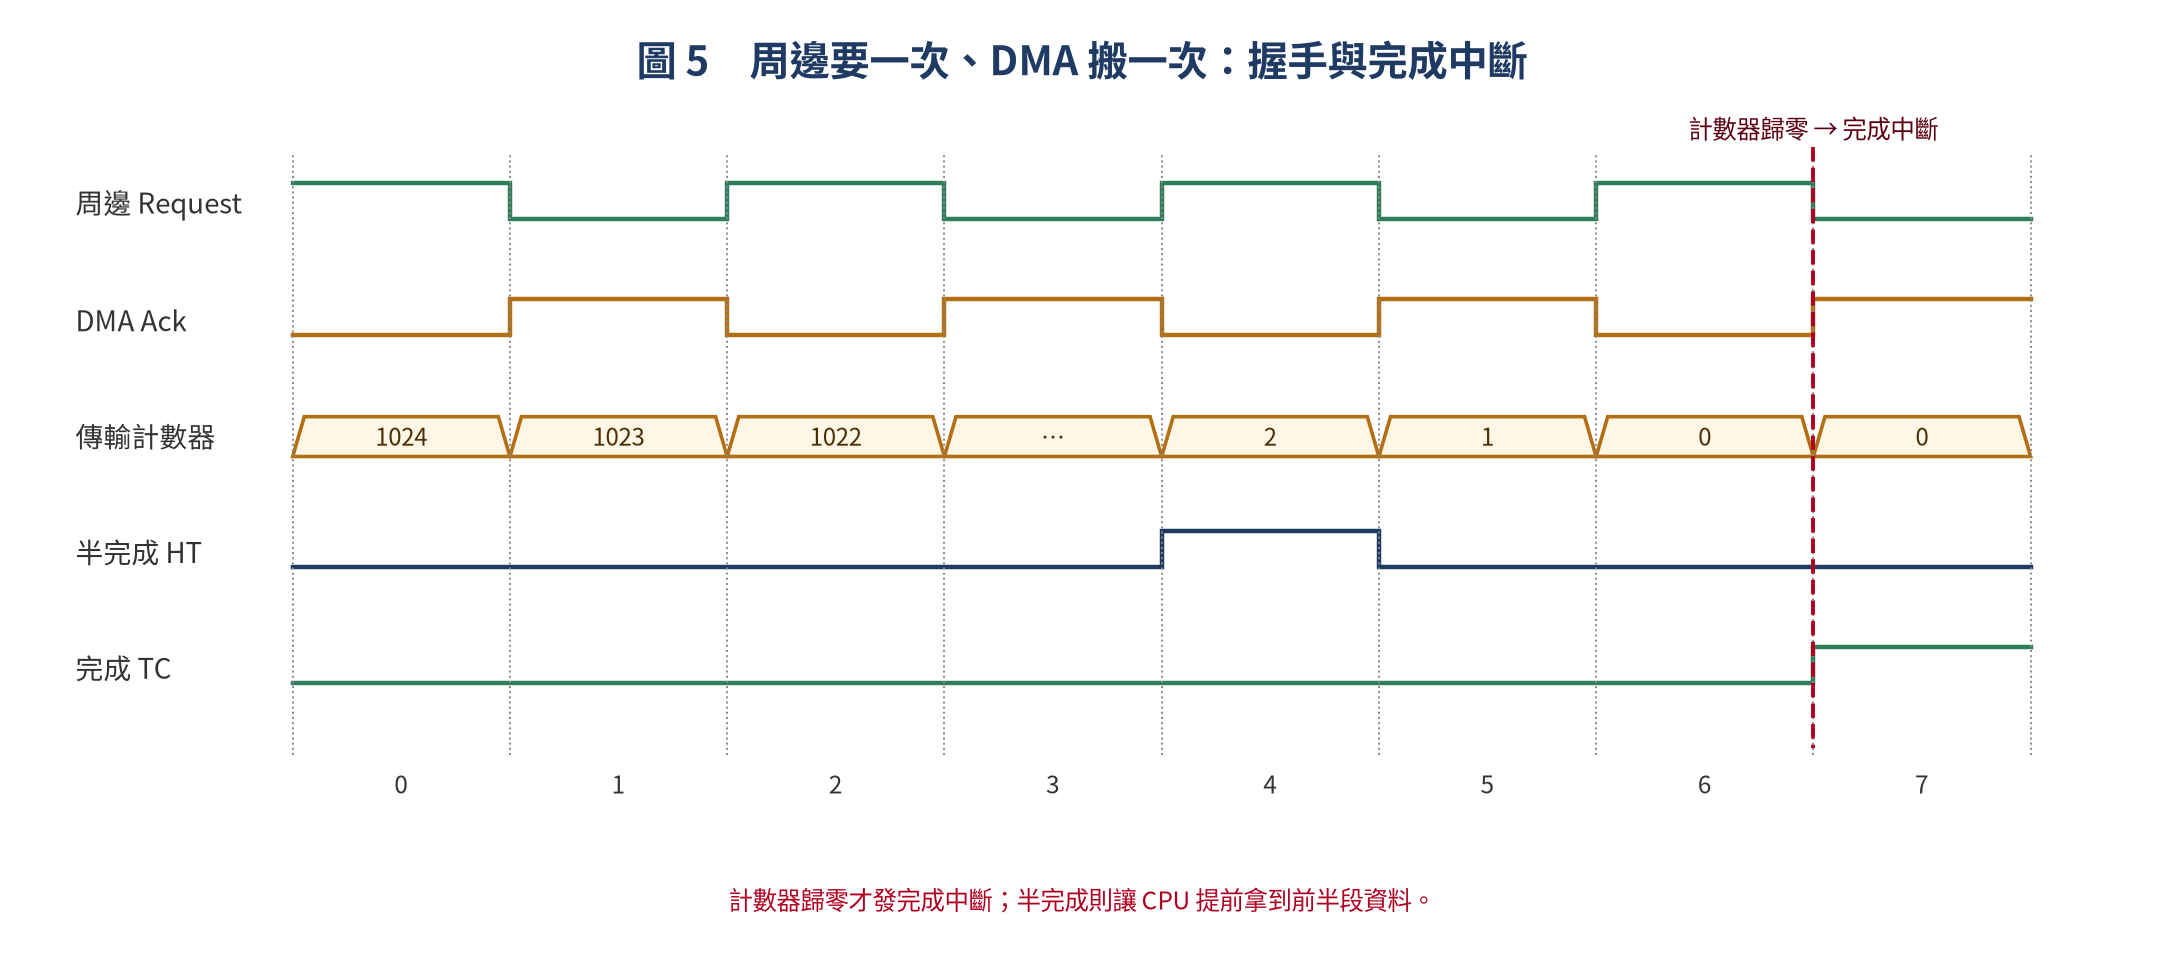
注意最後兩步:一次 Request 只搬一筆,搬完就把匯流排還回去。所以你會在時序圖上看到 Request 跟 Ack 一來一往、計數器一格一格往下掉。真正重要的是最下面那兩條旗標線 —— 半完成與完成,它們決定了 CPU 什麼時候被叫醒。
Ping-Pong Buffer(雙緩衝)
接下來是我認為最值得學的一個技巧。DMA 一直在寫,CPU 又要一直讀,兩邊搶同一塊記憶體遲早出事,所以我們準備兩塊:
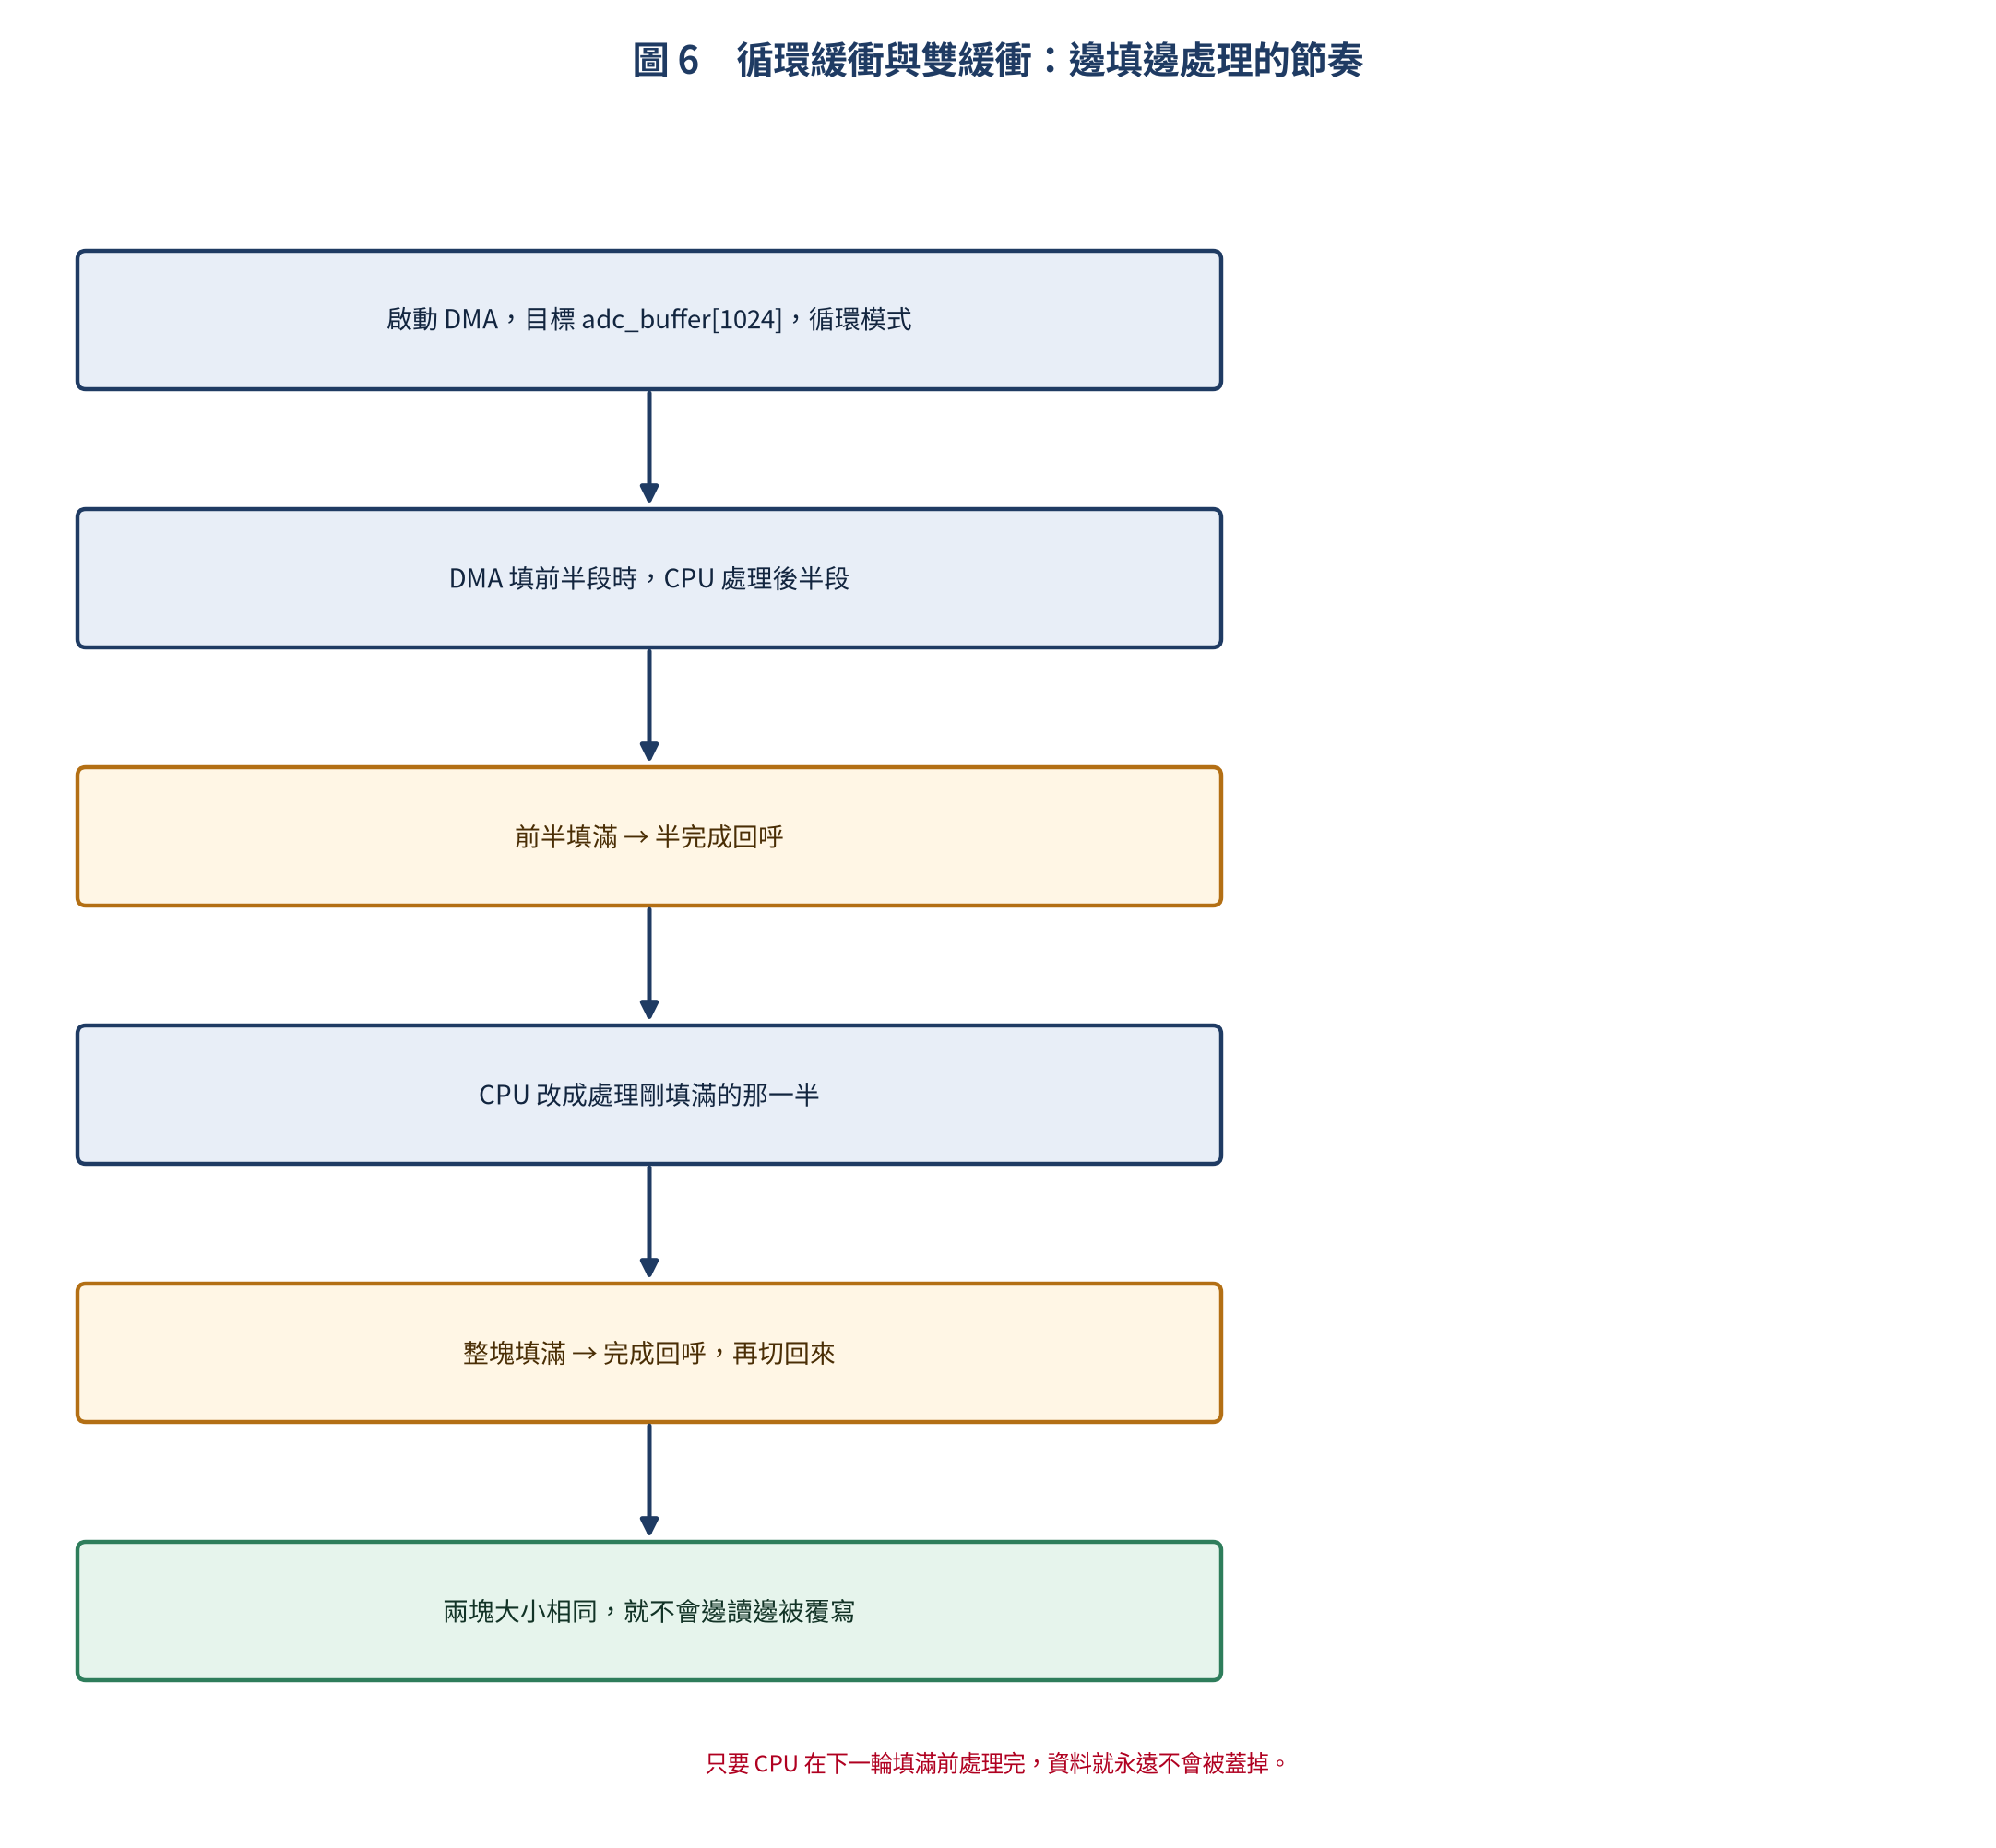
規則只有一句話:DMA 正在寫的那一塊,CPU 不碰;CPU 正在處理的那一塊,DMA 不碰。於是兩個角色可以一直平行作業,畫面(或資料流)不會開天窗。實作上有三個重點:
- 在 DMA 完成中斷裡切換 Buffer 指標
- 兩個 Buffer 的大小必須相同
- 用 Circular Mode,或部分系列支援的雙 Buffer Mode 讓硬體自動切換
STM32 HAL 實作:DMA + ADC 連續取樣
先初始化 DMA,再初始化 ADC,最後一行啟動。整段程式碼只有一個地方要特別注意:設定完之後 CPU 就真的要放手,不要又偷偷跑去輪詢。
#include "stm32f4xx_hal.h"

#define ADC_BUF_LEN  1024
uint16_t adc_buffer[ADC_BUF_LEN];

ADC_HandleTypeDef hadc1;
DMA_HandleTypeDef hdma_adc;

void MX_DMA_Init(void) {
    __HAL_RCC_DMA2_CLK_ENABLE();
    hdma_adc.Instance = DMA2_Stream0;
    hdma_adc.Init.Channel  = DMA_CHANNEL_0;
    hdma_adc.Init.Direction = DMA_PERIPH_TO_MEMORY;    // P2M
    hdma_adc.Init.PeriphInc = DMA_PINC_DISABLE;         // 周邊位址不遞增
    hdma_adc.Init.MemInc    = DMA_MINC_ENABLE;          // 記憶體位址遞增
    hdma_adc.Init.PeriphDataAlignment = DMA_PDATAALIGN_HALFWORD;  // 16 bit
    hdma_adc.Init.MemDataAlignment    = DMA_MDATAALIGN_HALFWORD;
    hdma_adc.Init.Mode      = DMA_CIRCULAR;              // 循環模式
    hdma_adc.Init.Priority  = DMA_PRIORITY_HIGH;
    HAL_DMA_Init(&hdma_adc);

    __HAL_LINKDMA(&hadc1, DMA_Handle, hdma_adc);
}

void MX_ADC1_Init(void) {
    hadc1.Instance = ADC1;
    hadc1.Init.ScanConvMode  = DISABLE;
    hadc1.Init.ContinuousConvMode = ENABLE;   // 連續轉換
    hadc1.Init.ExternalTrigConv = ADC_SOFTWARE_START;
    hadc1.Init.NbrOfConversion = 1;
    HAL_ADC_Init(&hadc1);
}

int main(void) {
    HAL_Init();
    MX_DMA_Init();
    MX_ADC1_Init();

    // 啟動 DMA + ADC(硬體自動搬運)
    HAL_ADC_Start_DMA(&hadc1, (uint32_t*)adc_buffer, ADC_BUF_LEN);

    while (1) {
        // CPU 可以在這裡做其他事!
        // 最新的 ADC 資料一直在 adc_buffer[] 中更新
        uint16_t latest = adc_buffer[ADC_BUF_LEN - 1];
        HAL_Delay(10);
    }
}

// DMA 完成回呼(每填滿一次觸發)
void HAL_ADC_ConvCpltCallback(ADC_HandleTypeDef* hadc) {
    // 可在此切換 Ping-Pong Buffer
    // HAL_ADC_Start_DMA(&hadc1, (uint32_t*)ping_buffer, ADC_BUF_LEN);
}
我自己最常被問的是「那我到底要去哪裡拿資料」。答案是主迴圈裡直接讀 adc_buffer 就好 —— 它一直在被更新,你讀到的永遠是最近的取樣值,這正是 DMA 值錢的地方。
ESP32 實作:DMA + SPI 傳輸
ESP32 的 SPI 控制器本身就內建硬體 DMA(GDMA),所以不用像 STM32 那樣自己配 Stream 跟 Channel,只要在初始化時把 DMA 開起來就好:
#include "driver/spi_master.h"

#define DMA_CHUNK_SIZE  4096
uint8_t tx_buffer[DMA_CHUNK_SIZE];
uint8_t rx_buffer[DMA_CHUNK_SIZE];

void app_main(void) {
    spi_bus_config_t bus_cfg = {
        .miso_io_num = 12,
        .mosi_io_num = 13,
        .sclk_io_num = 14,
        .quadwp_io_num = -1,
        .quadhd_io_num = -1,
        .max_transfer_sz = DMA_CHUNK_SIZE * 2,
    };
    spi_bus_initialize(SPI2_HOST, &bus_cfg, SPI_DMA_CH_AUTO);  // 啟用 DMA

    spi_device_handle_t spi;
    spi_device_interface_config_t dev_cfg = {
        .clock_speed_hz = 10 * 1000 * 1000,  // 10 MHz
        .mode = 0,
        .spics_io_num = 15,
        .queue_size = 1,
    };
    spi_bus_add_device(SPI2_HOST, &dev_cfg, &spi);

    // DMA 傳輸(資料自動透過 GDMA 搬運,不佔用 CPU)
    spi_transaction_t t = {
        .length = DMA_CHUNK_SIZE * 8,     // 位元數
        .tx_buffer = tx_buffer,
        .rx_buffer = rx_buffer,
    };
    spi_device_transmit(spi, &t);  // 底層使用 DMA 傳輸

    // 同時,CPU 可以處理其他任務
    printf("SPI DMA 傳輸完成!\n");
}
差別在這裡:ESP32 的 DMA 是「預設幫你做好」,STM32 的 DMA 是「給你一張空白表格自己填」。前者上手快,後者彈性大。但兩邊的核心觀念一模一樣:資料搬運不經過 CPU,CPU 才有餘力去處理真正需要動腦的事。
DMA + FIFO 的搭配
DMA 跟 FIFO 是天生一對:一個負責搬,一個負責在兩邊速率不一致時當緩衝。幾個常見的組合:
- UART RX:DMA 把 UART FIFO 的資料週期性搬進 Ring Buffer,CPU 再從 Ring Buffer 慢慢讀
- SPI TX:CPU 只要把 DMA Buffer 填好,DMA 會逐 byte 餵給 SPI FIFO,CPU 全程解放
- ADC + DMA + 雙 Buffer:DMA 輪流填兩塊,CPU 處理已經填滿的那一塊
還有一個很少人一開始就知道的細節:DMA 的觸發來源通常設在 FIFO 的「幾乎空」或「幾乎滿」事件,而不是每個 byte 都觸發一次。理由是傳輸次數會直接影響匯流排佔用,把零碎的搬運合併成一筆大的,效率差很多。
常見陷阱
接下來這三件事,是我看過最多人卡住的地方。它們的共同點是:程式看起來完全沒錯,數字也都對,但行為就是不如預期。
Cache Coherency(快取一致性)
這是 STM32H7 這類高階 MCU 最經典的坑。CPU 的 Cache 裡可能還放著資料的舊副本,而 DMA 是直接寫進 SRAM 的 —— 結果就是 CPU 很開心地讀到 Cache 裡的舊資料,然後懷疑人生。
解法:把 DMA 緩衝區所在的記憶體區域設成「非快取」(Non-Cacheable),或者在存取前先做 Cache 的清理與失效。
// STM32H7 解法:使用非快取記憶體區段
// 或在 DMA 讀取前失效 Cache
SCB_InvalidateDCache_by_Addr((uint32_t*)buffer, size);
// 在 DMA 寫入前清理 Cache
SCB_CleanDCache_by_Addr((uint32_t*)buffer, size);
Buffer Overflow / Underflow
當 DMA 的搬運速度超過 CPU 的處理速度,Buffer 會來不及被讀走就被下一輪覆寫(Overflow)。反過來,CPU 處理太快、資料還沒進來,讀到的就是空的(Underflow)。
解法:用 Ping-Pong Buffer 搭配水位標記(Watermark),或改用 Circular DMA Mode 並確實追蹤讀寫指標。
DMA 與中斷競爭
DMA 完成中斷如果跟其他中斷同時發生,就有機會在共享資料上撞車,也就是資料競爭(Race Condition)。
解法:在 DMA 回呼裡用原子操作,或直接關中斷來保護那段共享資料。這段程式碼很短,但少了它,你的 bug 會是那種一個月才出現一次的類型。
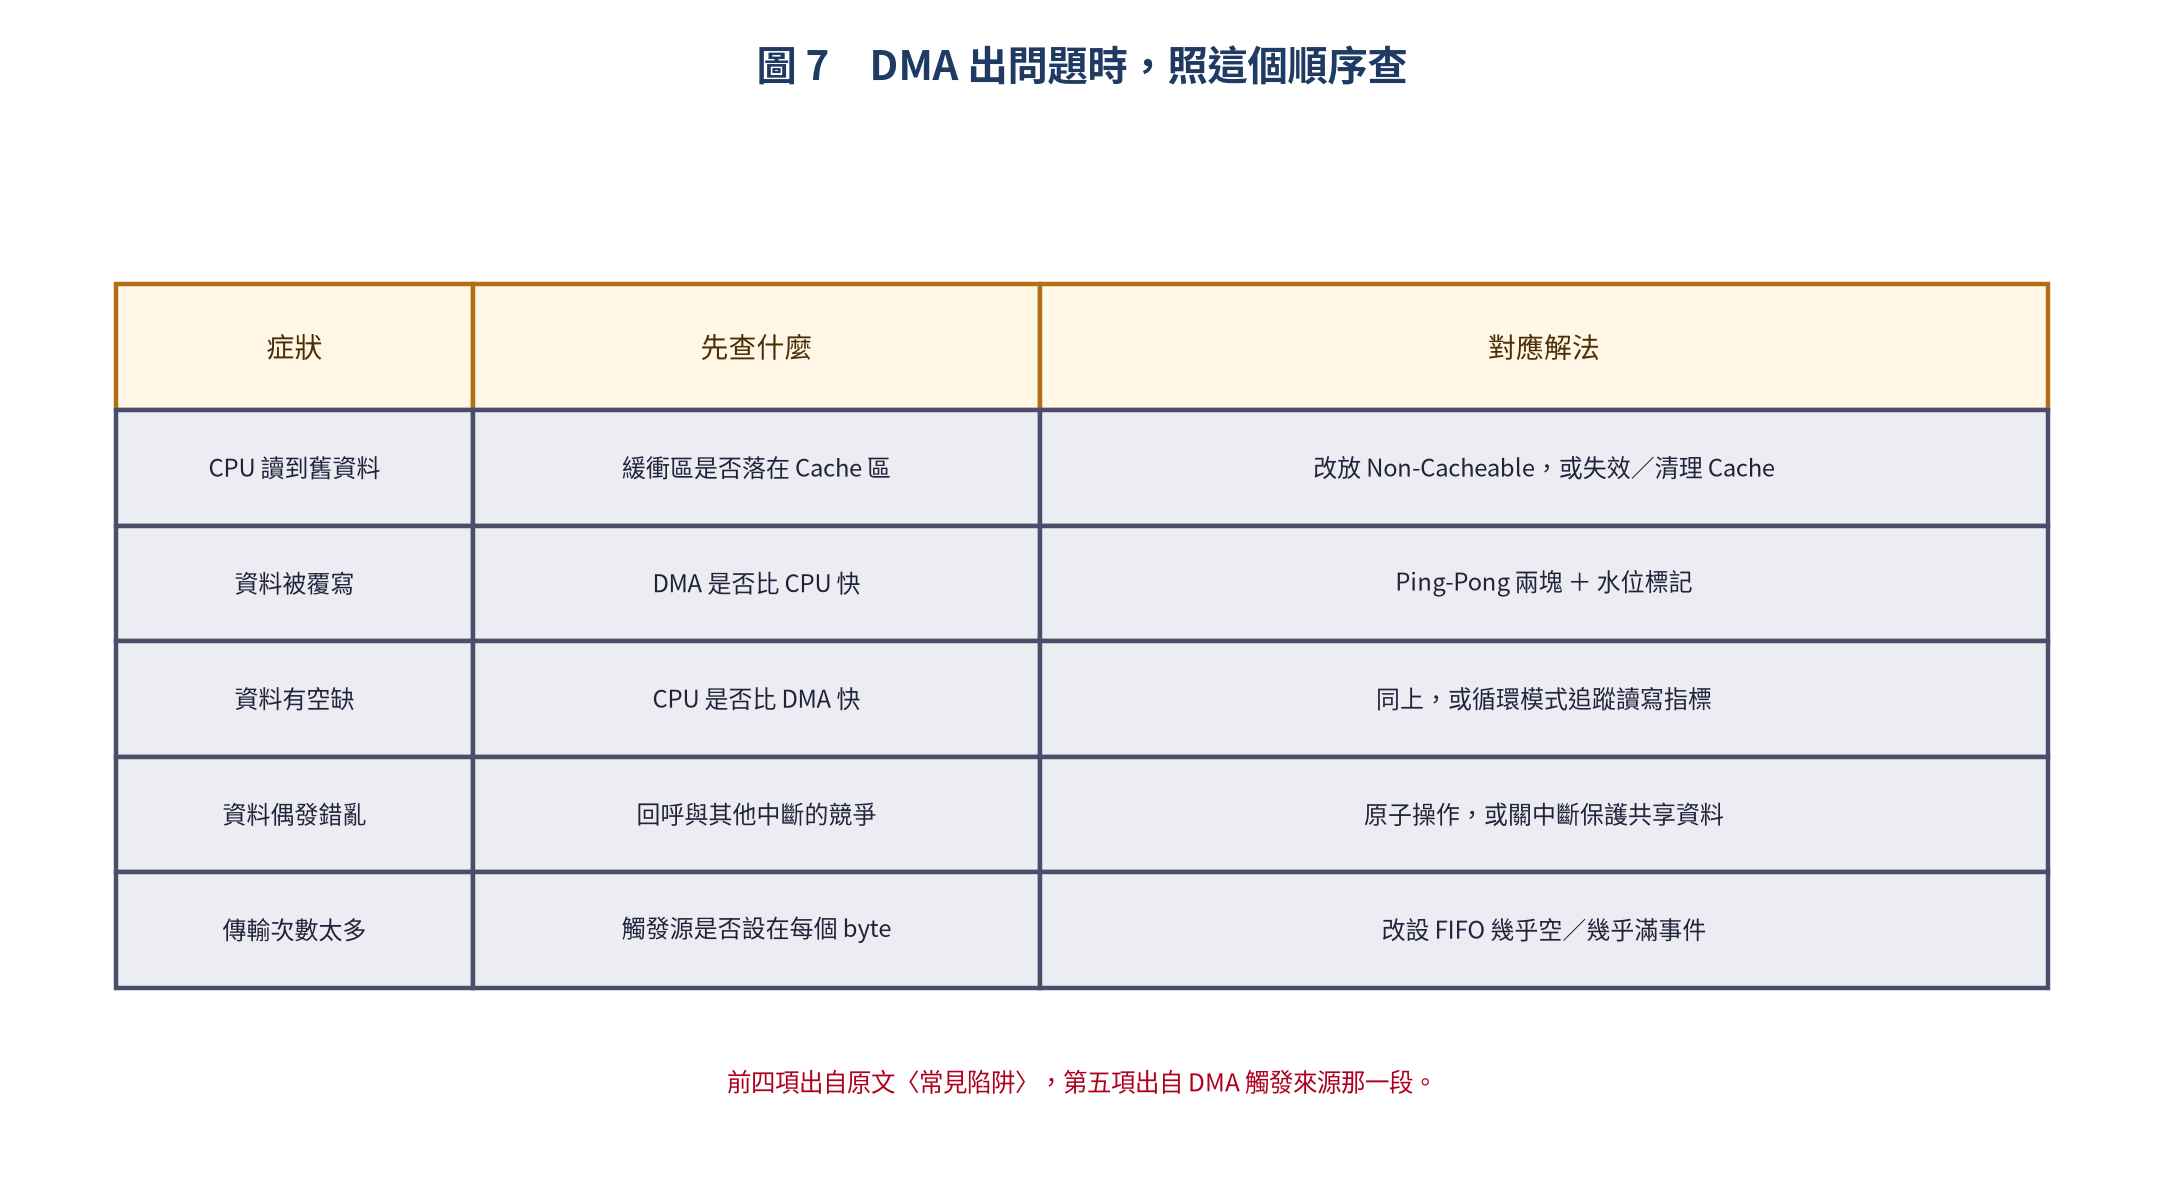
上面這張表是我整理過的排查順序。經驗上,先確認問題是「資料不對」還是「資料不見」,再往 Cache 與記憶體一致性的方向查,通常五分鐘內就能縮小範圍。
總結
DMA 是嵌入式系統裡與 Timer、Interrupt 並列的三大核心硬體資源之一。同樣的 CPU 頻率,用不用 DMA 決定你能處理多少資料流 —— 這就是從「能用」到「高效能」的分界線。
如果你剛開始學,我的建議是從 STM32 HAL 的 ADC + DMA 範例下手,先親眼看著 CPU 從輪詢裡被解放出來是怎麼一回事;等你習慣了,再回來挑戰 Ping-Pong Buffer 跟快取一致性。
延伸閱讀:FIFO 完全解析 · Modbus 通訊協定 · PID 演算法

文章評論