什麼是 FIFO?
先講最白話的版本:FIFO 就是一個排隊用的緩衝區。東西從後面排進去、從前面拿出來,誰先到誰先被服務 —— First-In-First-Out,中文就叫先進先出。
聽起來沒什麼了不起,但嵌入式世界幾乎每個角落都有它:UART 收進來的資料、SPI 要送出去的佇列、DMA 搬資料的中繼站,還有兩個不同時鐘域之間的資料交換(Clock Domain Crossing, CDC)。少了 FIFO,這些事情全部得靠 CPU 硬扛。
這篇我想從頭把四件事講清楚:結構長什麼樣、空跟滿怎麼判斷、深度要開多大、跨時域該怎麼設計。範例同時給 C 語言的 Ring Buffer 和 STM32 的硬體 FIFO,兩邊對照著看,會比只看理論快很多。
FIFO 的應用場景
實務上 FIFO 幾乎都是為了解決下面這四類問題:
- 速率匹配:生產者和消費者的速度不一樣。ADC 一直取樣,處理器卻只能慢慢讀,中間就得放一個 FIFO 當水庫。
- 突發緩衝:短時間內大量資料衝進來,慢速的讀取端一時消化不完,先丟進 FIFO 排隊。
- 跨時域同步:兩個時鐘域互不同步,直接用同一條線傳資料會出錯,得靠 Async FIFO 接手。
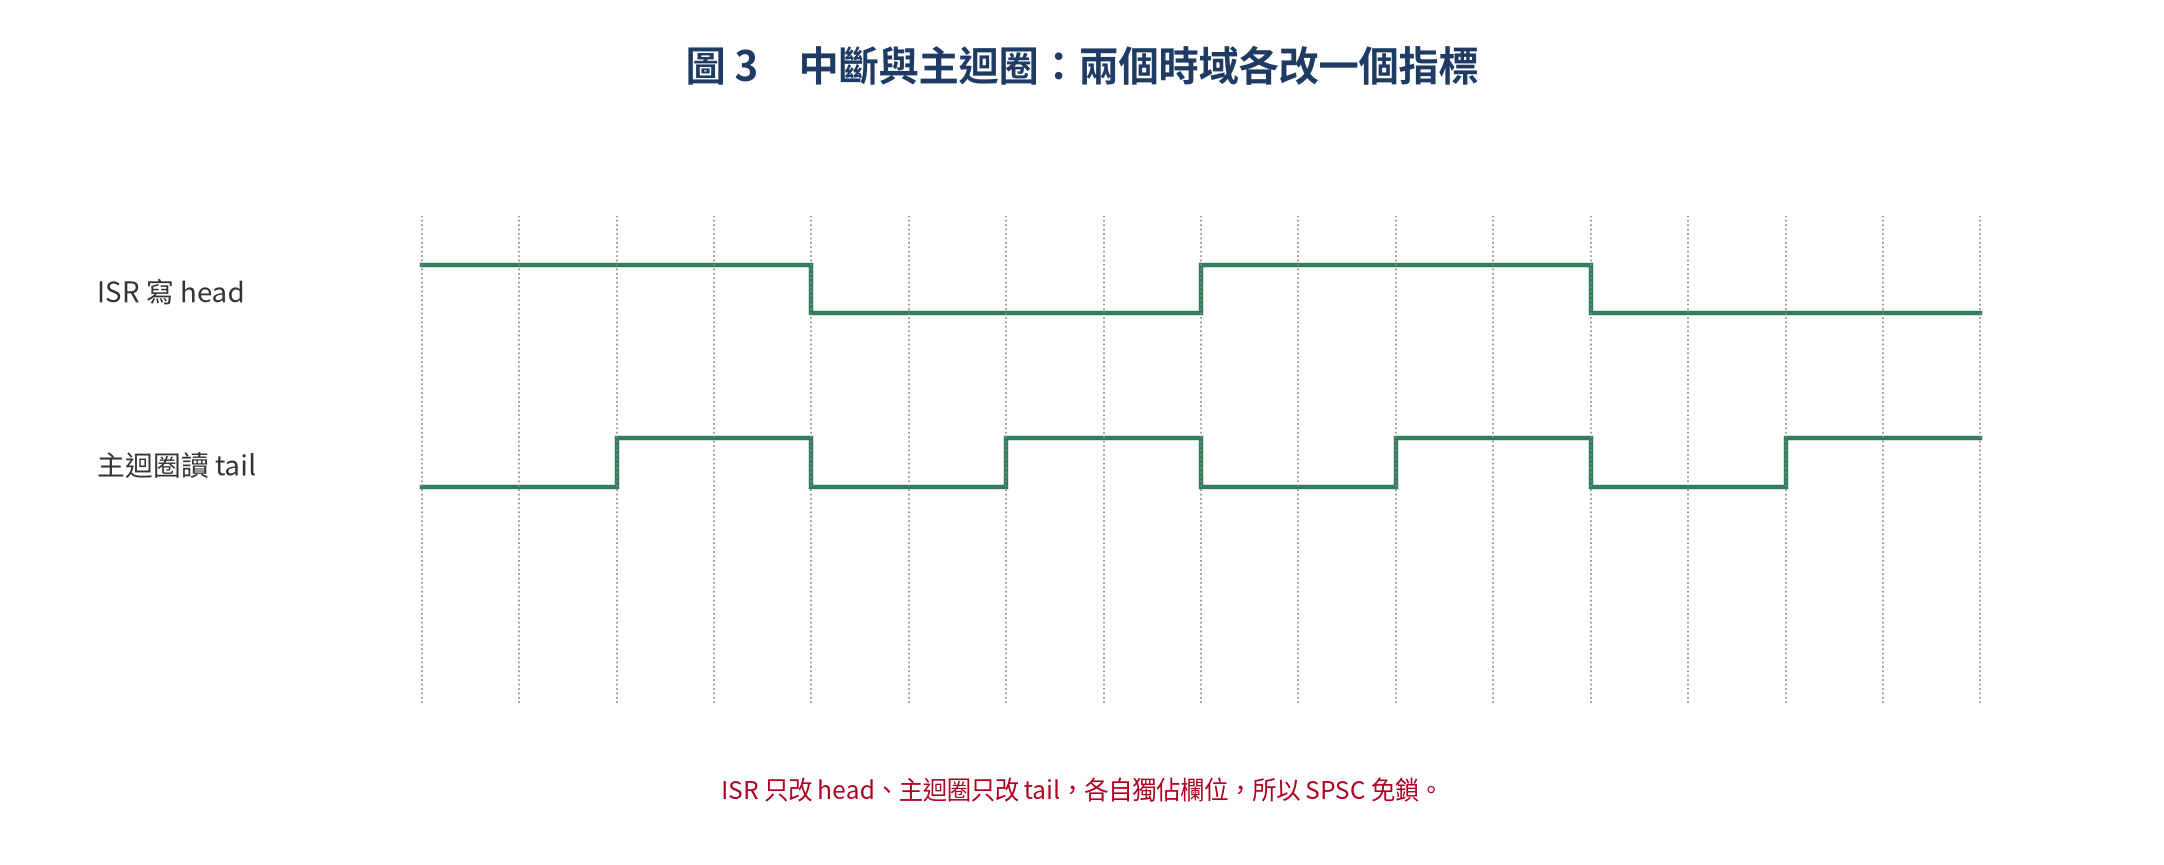
- 中斷安全佇列:ISR 負責寫、主迴圈負責讀,兩邊各改各的欄位,就不會互相踩到。
FIFO 的硬體結構
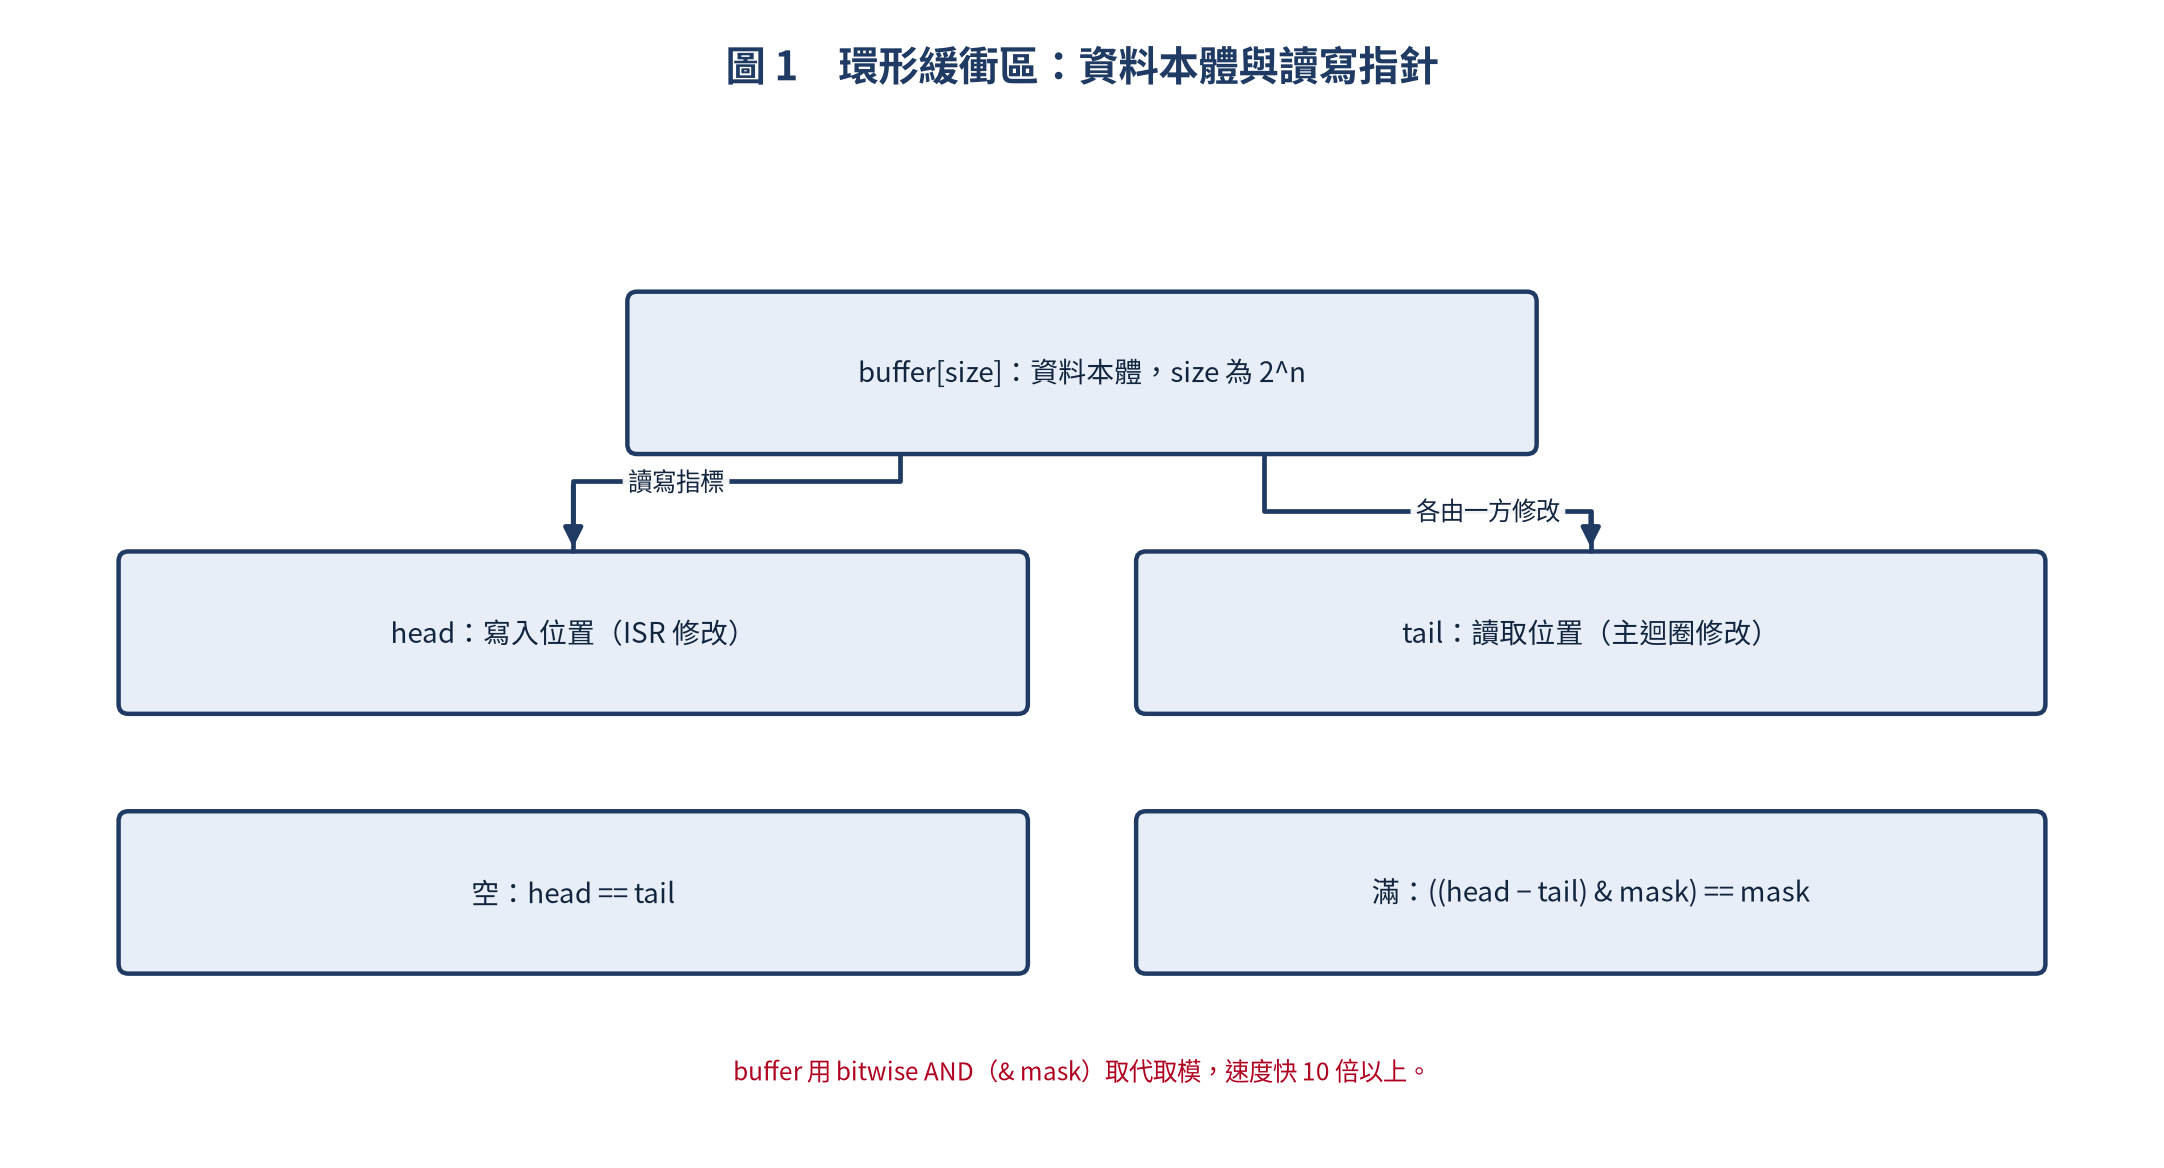
硬體 FIFO 拆開來看,其實就是五個零件:雙口 RAM(Dual-Port RAM)儲存資料本體、一條寫入指針、一條讀出指針、一組空滿旗標邏輯,非同步版本再多一個同步器。
真正的主角是指針。寫入指針指著「下一個要寫的位置」,讀出指針指著「下一個要讀的位置」,其他所有判斷(空、滿、還剩多少筆)都是從這兩條指針算出來的。所以說 FIFO 的難度從來不在儲存,而在指針的管理。
寫軟體 Ring Buffer 也是同一套路,只是把硬體換成一個 struct:buffer 指標、head、tail、size,再加一個 mask。那個 mask 是 size 減一,用途是把取模運算換成 bitwise AND,速度差 10 倍以上。
空滿判斷
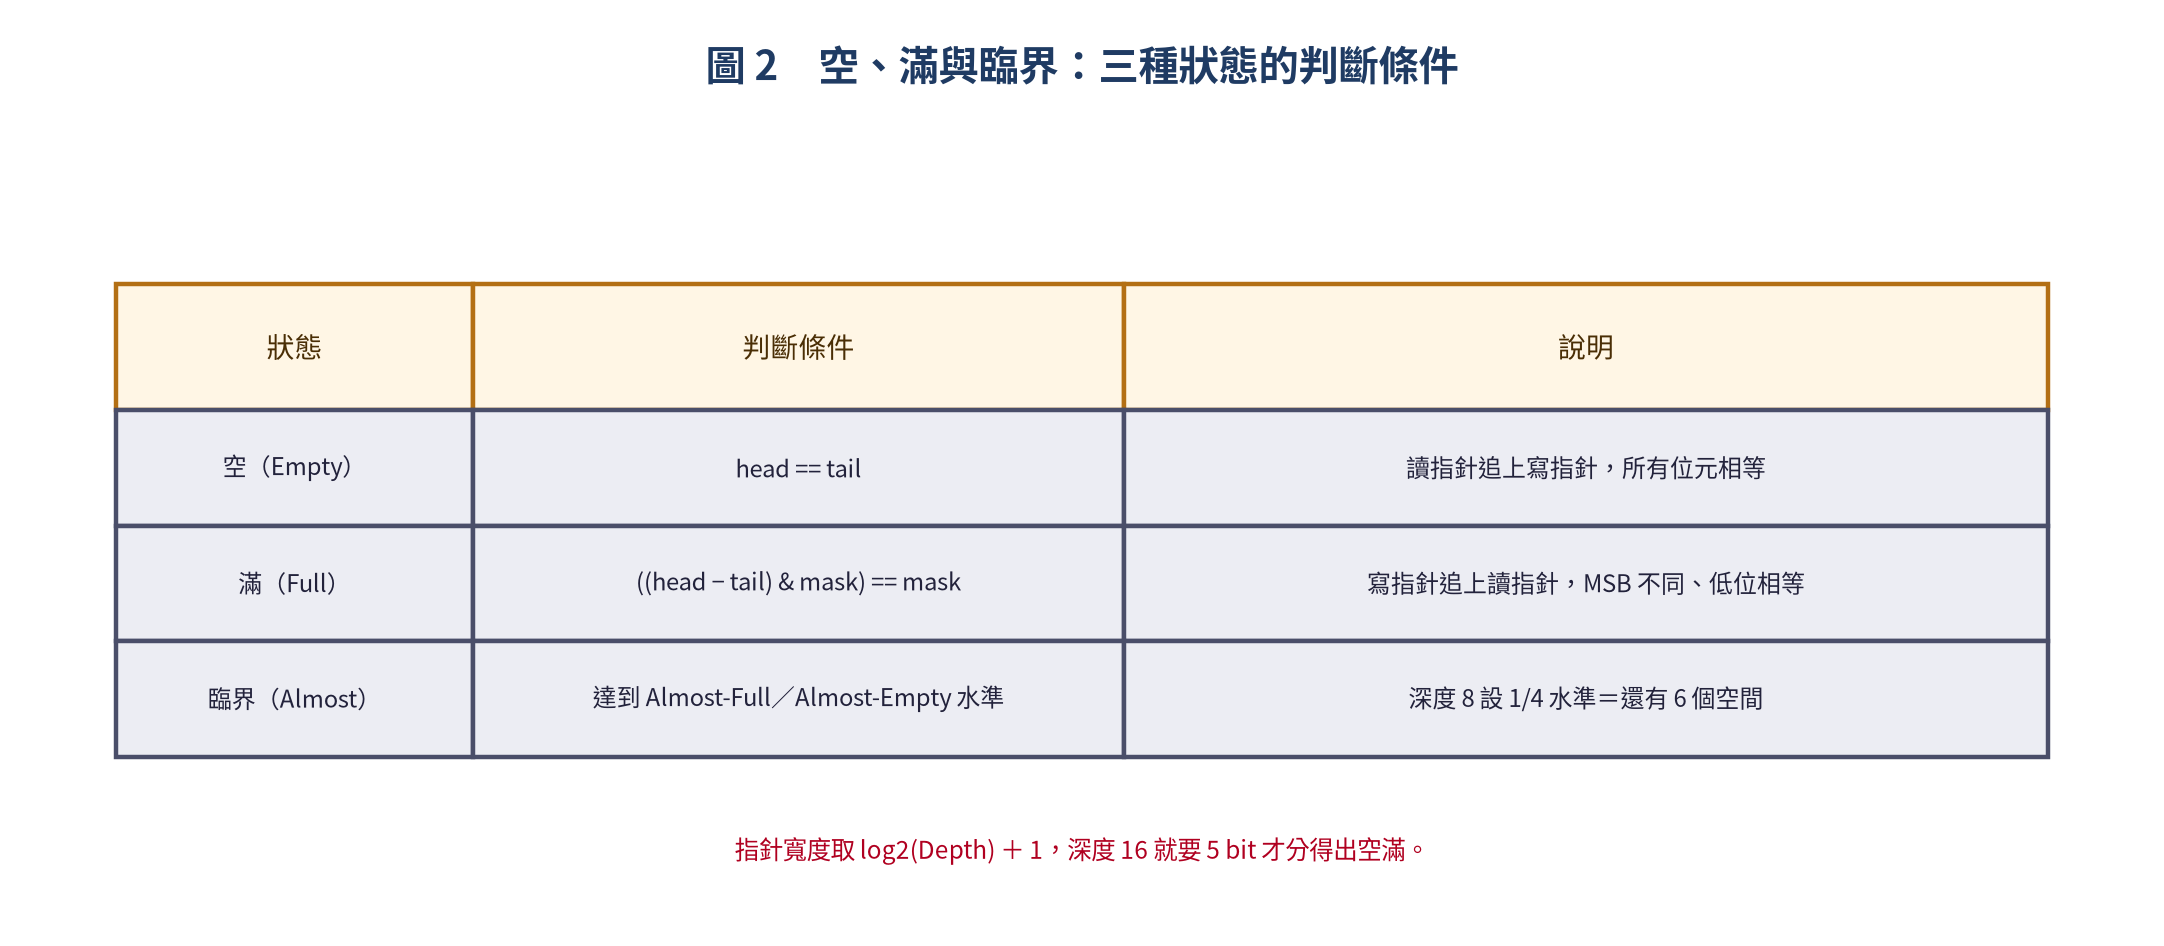
這裡是 FIFO 最核心、也最常被寫錯的一段:我到底要怎麼知道現在是空的還是滿的?
同步 FIFO(Same Clock Domain)
讀寫共用同一個時鐘的時候,事情很單純,直接比指針就好:
- Empty:Wr_Ptr == Rd_Ptr,讀指針追上了寫指針。
- Full:Wr_Ptr + 1 == Rd_Ptr,寫指針追上讀指針;或者反過來,用一個額外的 MSB 標誌位來區分。
為什麼要用「n+1 bit 指針」這種寫法?因為環形 FIFO 繞一圈之後,空和滿的兩個指針值長得一模一樣,光比數值根本分不出來。多留一個 bit,就有空間做手腳了:
- 指針寬度 = log₂(Depth) + 1(例如深度 16 就需要 5 bit)。
- Empty:所有位元相等(含 MSB),也就是 Wr_Ptr == Rd_Ptr。
- Full:MSB 不同,但剩下的低位相等。
非同步 FIFO(Different Clock Domains)
一旦兩邊時鐘不同(Async FIFO),情況立刻變麻煩:指針不能直接比。因為指針值跨越時域時會撞上亞穩態(Metastability),讀進來的可能是個不上不下的中間值。
所以非同步 FIFO 的順序不是「比指針」,而是「先把指針安全地送過去,再比」。
格雷碼與跨時域同步
跨時域 FIFO 的標準流程有四步:
- 把指針轉成格雷碼(Gray Code)。
- 用二級觸發器同步器(2-stage Flip-Flop Synchronizer)把格雷碼送過時域。
- 在目標時域把格雷碼轉回二進制。
- 比較轉回來的指針,判斷空或是滿。
為什麼非用格雷碼不可?因為格雷碼的特性是相鄰兩個數值只差 1 個 bit。跨時域取樣時最多只會錯一個 LSB,例如 010 被取成 110、或維持 010,兩個都是合法值。要是用二進制,從 011(3) 跳到 100(4) 是 3 個 bit 同時變化,取樣時可能讀到 000 到 111 之間任何一個鬼值。
轉換本身很短,就兩行:
// 二進制 → 格雷碼
gray = binary ^ (binary >> 1);

// 格雷碼 → 二進制(反轉)
binary = gray;
for (int i = 1; i < N; i++)
    binary ^= gray >> i;
FIFO 深度計算
深度是最容易被低估的一個參數。開太小會丟資料(Overflow),開太大則是浪費資源又增加延遲,兩邊都要付代價。
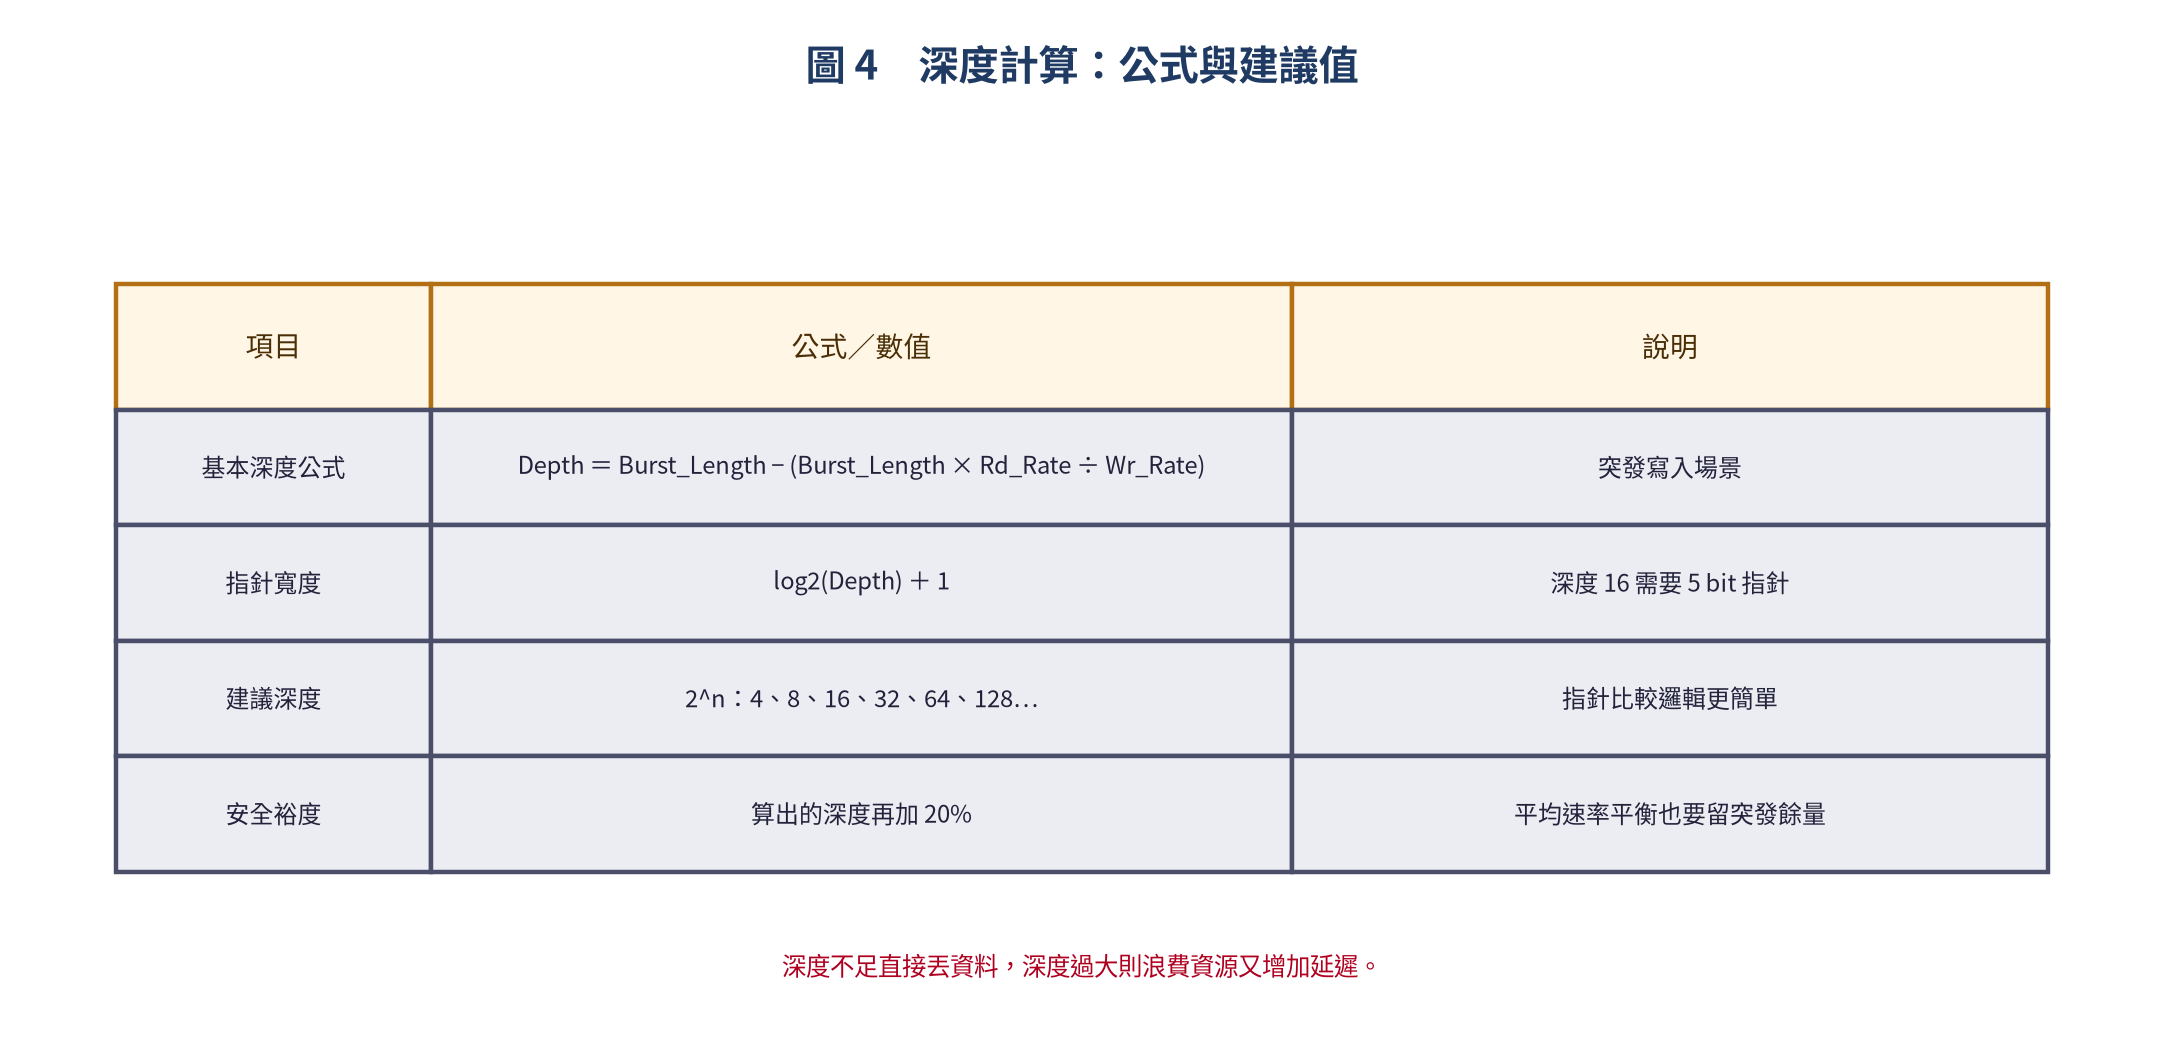
突發寫入場景的基本公式是:
Depth = Burst_Length − (Burst_Length × Rd_Rate / Wr_Rate)
其中 Rd_Rate 和 Wr_Rate 是讀寫速率(資料/秒)。直覺是這樣:突發期間寫進去的量,扣掉這段時間內被讀走的量,剩下的就是 FIFO 至少要裝得下的量。
實例計算
把幾個常見場景代進公式,大概長這樣:
| 場景 | 寫入速率 | 讀取速率 | 突發長度 | 所需深度 |
|---|---|---|---|---|
| UART RX | 115200 bps | CPU polling | 1 byte | 1(硬體已有 16) |
| ADC → SPI | 1 MSps(10MHz) | 40MHz SPI | 100 筆 | 60 |
| Ethernet MAC | 1 Gbps | 125 MHz | 1518 bytes | 512~1024 |
| ISP 影像管線 | 60 fps | 處理器 DMA | 1 frame | ≥ 1 frame |
順帶補一句實務經驗:非同步 FIFO 的深度通常取 2ⁿ(4、8、16、32、64、128…),因為指針的比較邏輯會簡單很多。深度越大安全邊際越高,但延遲也跟著變大,沒有白吃的午餐。
軟體 FIFO:Ring Buffer(環形緩衝區)
在 ESP32 和 STM32 的日常裡,最常打交道的其實是軟體 Ring Buffer。它就是前面那套指針邏輯的 C 版本:
typedef struct {
    uint8_t *buffer;
    volatile uint32_t head;   // 寫入位置(ISR 修改)
    volatile uint32_t tail;   // 讀取位置(主迴圈修改)
    uint32_t size;            // 緩衝區大小(2^n)
    uint32_t mask;            // size - 1(用 & 代替 %)
} RingBuffer;

bool RingBuf_Init(RingBuffer *rb, uint8_t *buf, uint32_t size) {
    // size 必須是 2^n
    if (size & (size - 1)) return false;
    rb->buffer = buf;
    rb->head = 0;
    rb->tail = 0;
    rb->size = size;
    rb->mask = size - 1;
    return true;
}

bool RingBuf_IsEmpty(RingBuffer *rb) {
    return rb->head == rb->tail;
}

bool RingBuf_IsFull(RingBuffer *rb) {
    return ((rb->head - rb->tail) & rb->mask) == rb->mask;
}

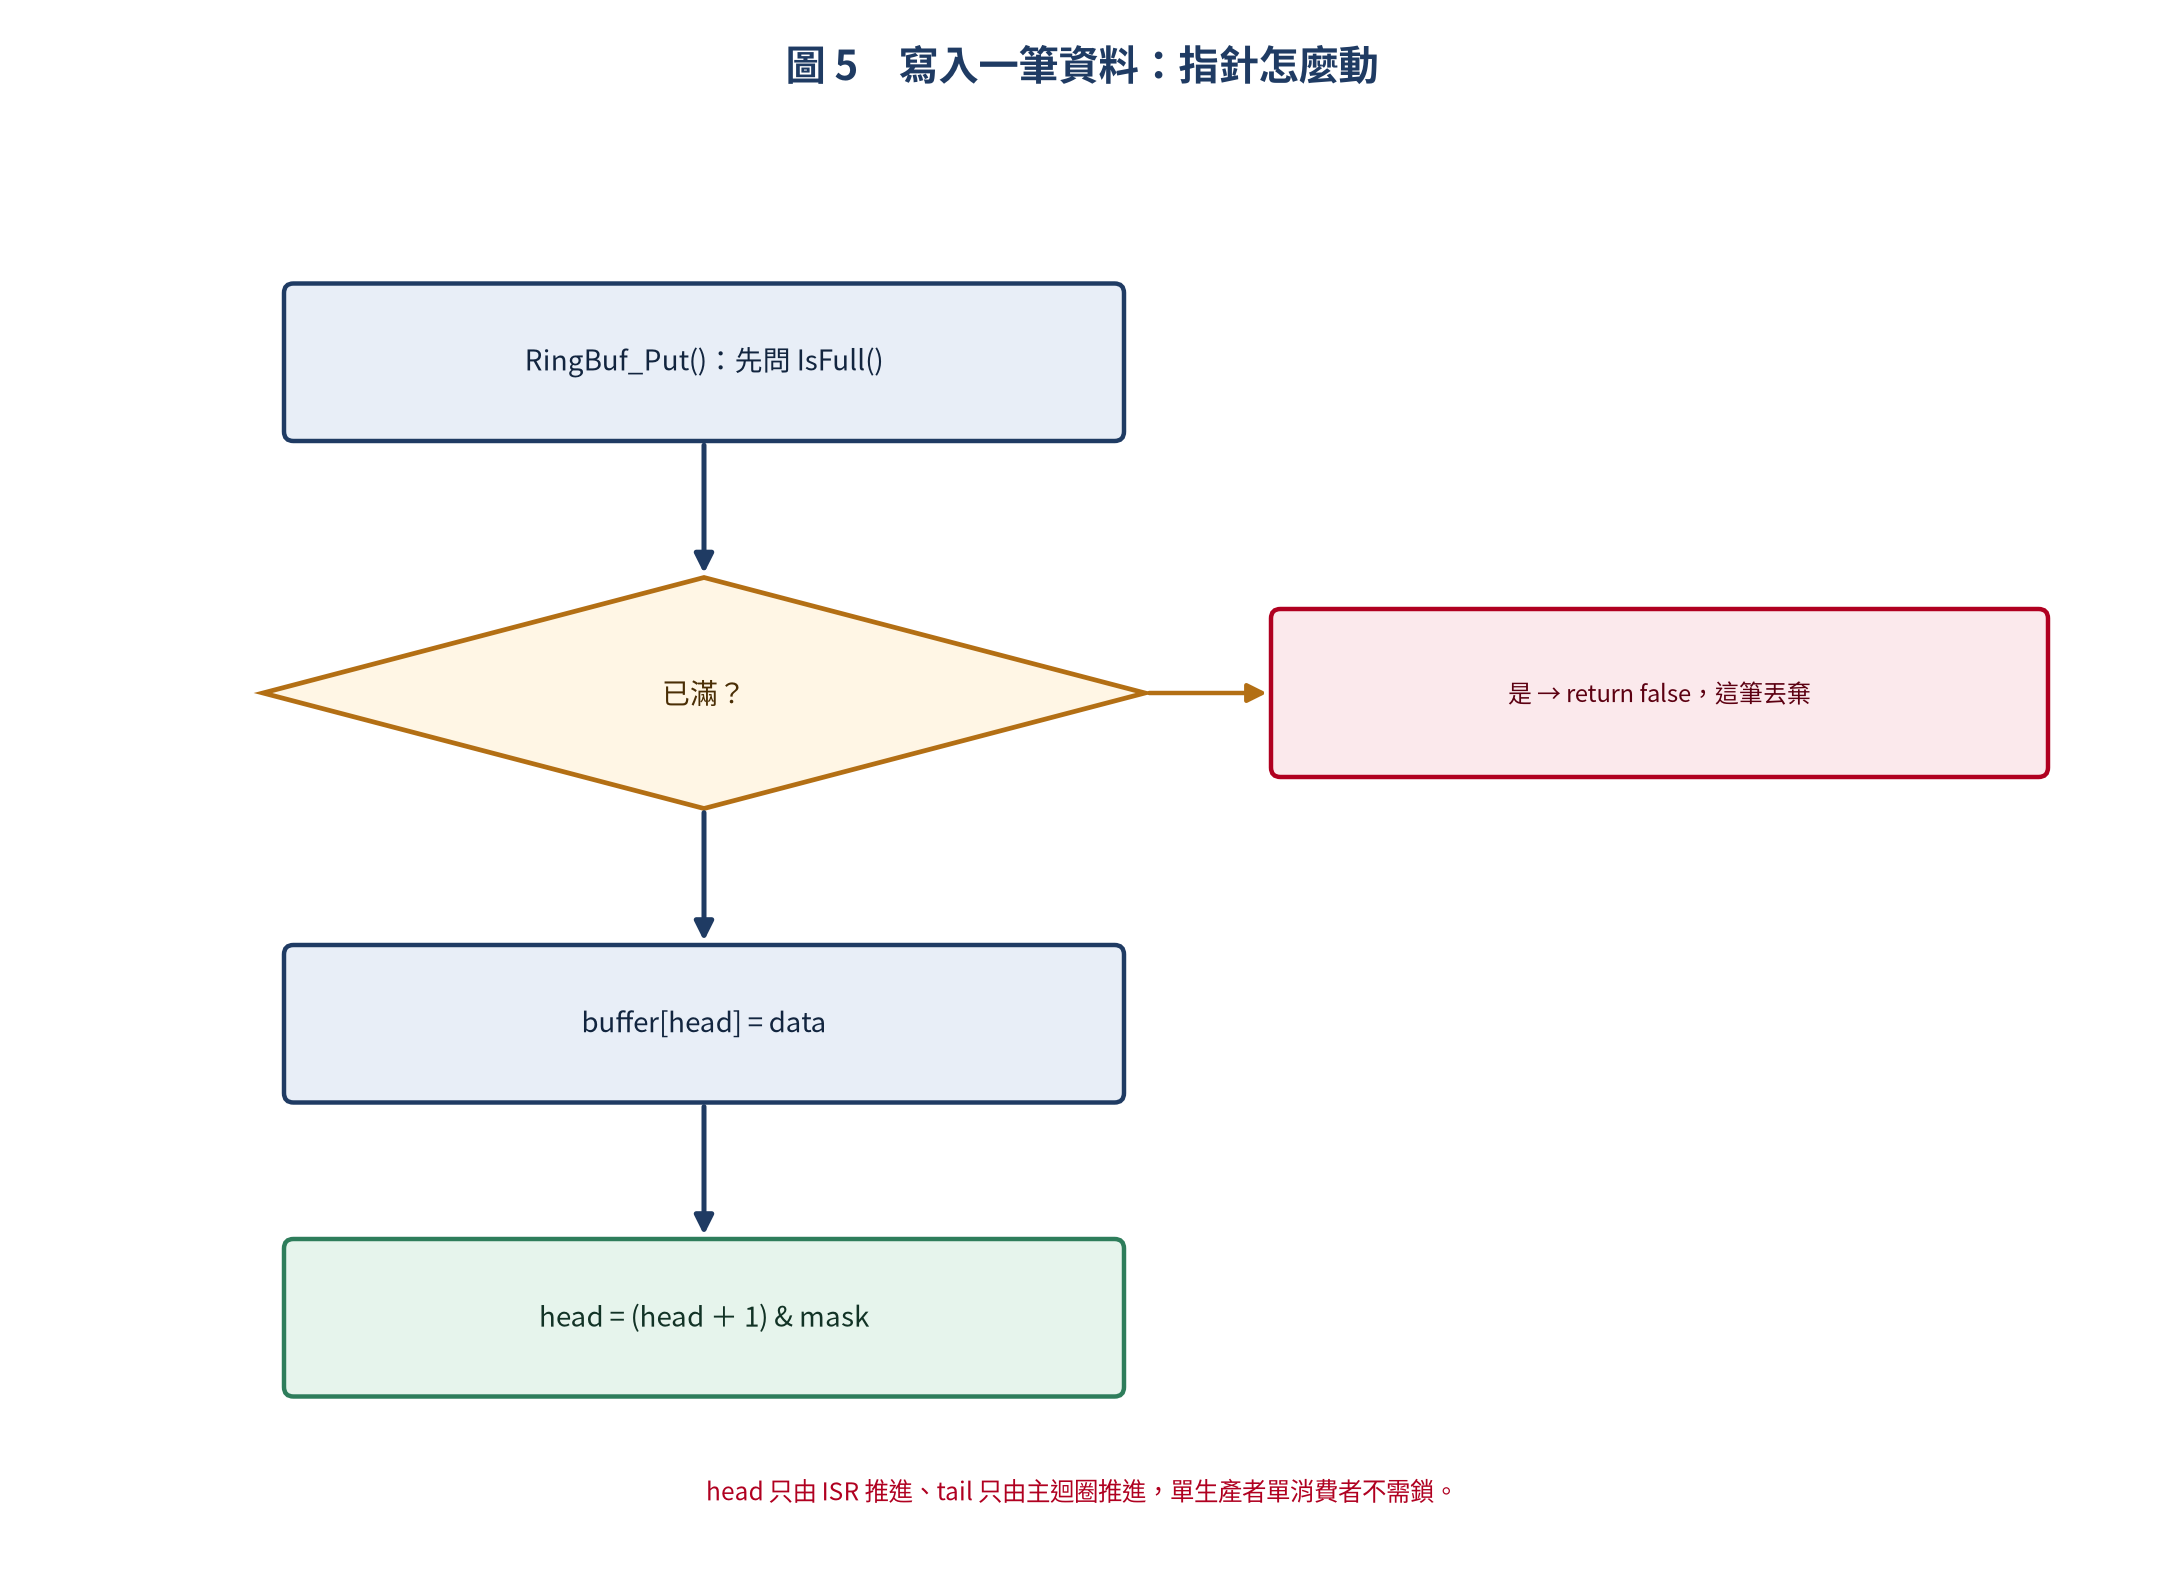
bool RingBuf_Put(RingBuffer *rb, uint8_t data) {
    if (RingBuf_IsFull(rb)) return false;  // 已滿,丟棄
    rb->buffer[rb->head] = data;
    rb->head = (rb->head + 1) & rb->mask;
    return true;
}

bool RingBuf_Get(RingBuffer *rb, uint8_t *data) {
    if (RingBuf_IsEmpty(rb)) return false; // 空的
    *data = rb->buffer[rb->tail];
    rb->tail = (rb->tail + 1) & rb->mask;
    return true;
}
寫入的流程完全照著指針走 —— 先問滿不滿,再寫進去,最後推進指針:
實作要點
- 大小取 2ⁿ:這樣就能用 bitwise AND 取代除法取模,速度快 10 倍以上。
- head / tail 一定要 volatile:ISR 改 head、主迴圈改 tail,不加 volatile,編譯器會把它最佳化掉。
- SPSC 天生安全:單生產者(ISR)搭單消費者(主迴圈),head 和 tail 各只有一方會寫,所以不需要鎖。
- 丟棄策略要先想清楚:上面的程式碼是「滿了就丟掉新資料」,實際專案也可能改成「覆蓋最舊的資料」,這是兩種完全不同的行為。
STM32 硬體 FIFO
STM32 這幾年的 MCU 內建了不只一種硬體 FIFO,常見的有這幾種:
- USART FIFO:STM32H7/G4 有 16 byte 的 TX/RX FIFO,中斷觸發水準可以設 1/4、1/2、3/4 或 Full。
- SPI FIFO:F4/H7 系列有 4~32 byte。
- I2S FIFO:音訊串流常用 16 word。
- DMA FIFO:拿來做資料寬度匹配,例如 8→16→32 bit。
- DFSDM FIFO:外接 Σ-Δ ADC 的數位濾波器專用。
要啟用其實不難,HAL_UARTEx_ReceiveToIT() 或 LL_SPI_EnableFIFO() 這類 API 叫一下就有了,換來的是中斷頻率大幅下降。
常見陷阱
深度不足導致 Overflow
這是第一名。很多人只看平均速率,覺得寫入跟讀取差不多就沒事,結果遇到突發就直接爆掉。
資料丟失的過程其實很固定:
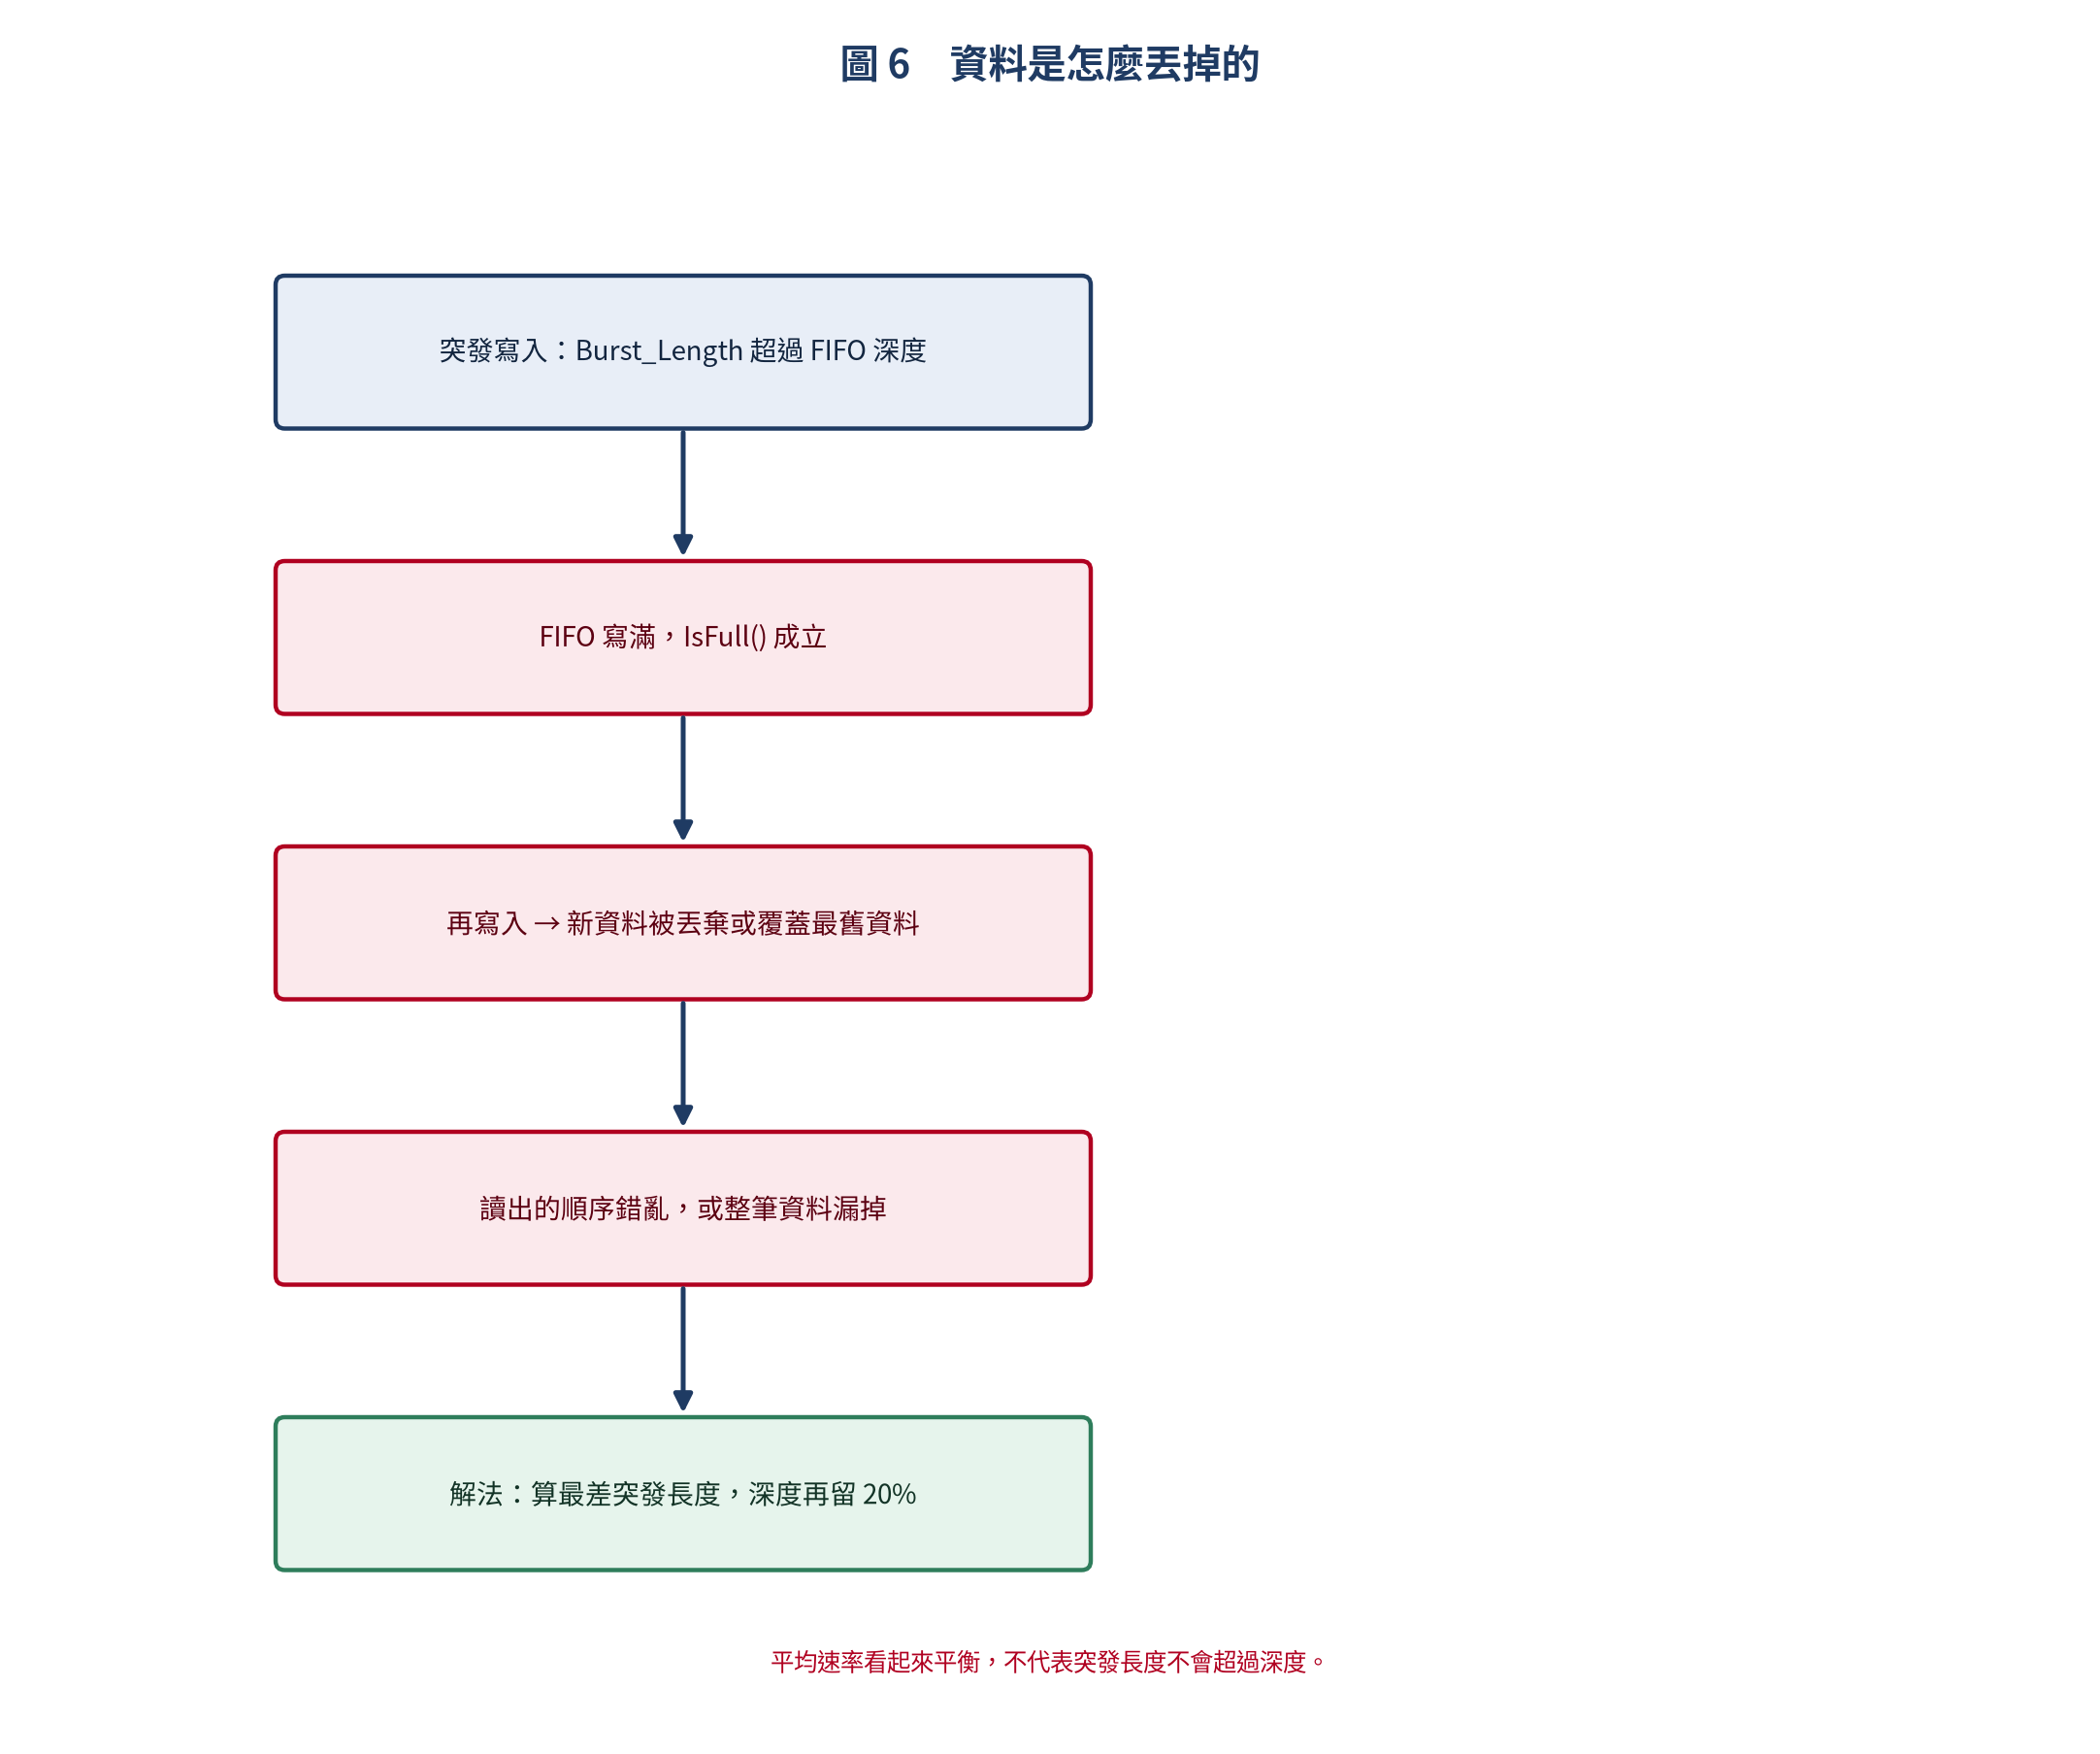
解法:老老實實分析最差情況的突發長度(Burst Length),代公式算出需要的深度,然後再往上加 20% 的安全裕度。
空滿判斷邏輯錯誤
Ring Buffer 的 Full 條件通常是 head + 1 == tail(故意浪費一個 slot),或者 head == tail 但另外帶一個 Full flag。問題是很多人把 Empty 和 Full 的比較邏輯混在一起寫,buffer 的狀態就開始錯亂了。
解法:空(Empty)= head == tail;滿(Full)= (head + 1) & mask == tail,不然就乾脆多養一個獨立的 count 變數。
跨時域亞穩態
另一個常見誤會是「裝了二級同步器就穩了」。當資料匯流排寬度大於 1 bit 時,二級同步器只能降低亞穩態發生的機率,沒辦法保證每個 bit 同步的時間一致。
解法:跨時域之前一定要先編碼成格雷碼,不要直接把多位元二進制值丟過去。
非同步 FIFO 的亞穩態問題
亞穩態(Metastability)是非同步 FIFO 最難搞的地方。當寫入時鐘域的資料被讀出時鐘域取樣時,如果資料剛好卡在取樣邊緣附近(違反 Setup/Hold Time),觸發器的輸出就會停在一個中間電壓 —— 既不是 0 也不是 1。
亞穩態的後果有三種:
- 輸出可能在 0 和 1 之間來回震盪。
- 不同 bit 的亞穩態恢復時間不一致,多 bit 匯流排就會讀到錯的值。
- 亞穩態會往後傳,污染後續邏輯,嚴重時整個系統就當了。
標準解法是二級同步器(2-Stage Flip-Flop Synchronizer),寫成 Verilog 只有幾行:
// Verilog 雙級同步器
module sync_2ff #(parameter WIDTH = 1) (
    input  wire             clk,
    input  wire [WIDTH-1:0] async_in,
    output wire [WIDTH-1:0] sync_out
);
    reg [WIDTH-1:0] sync_ff1, sync_ff2;

    always @(posedge clk) begin
        sync_ff1 <= async_in;   // 第一級:取樣亞穩態
        sync_ff2 <= sync_ff1;   // 第二級:亞穩態已恢復
    end

    assign sync_out = sync_ff2;
endmodule
二級同步器可以把亞穩態的 MTBF(Mean Time Between Failures)從微秒級一路推到數百年。如果時鐘頻率真的很高(> 500 MHz),那就再多一級,考慮三級同步器。
FIFO 在 STM32 中的應用
以 STM32F4 系列為例,USART 的硬體 FIFO 大概這樣配置:
// STM32 USART FIFO 配置(部分系列)
USART_CR2_FIFOEN  // 啟用 FIFO
USART_CR1_TCIE    // 傳輸完成中斷
USART_CR3_TXFTIE  // FIFO 觸發水準中斷

// 設定 FIFO 觸發水準(以 STM32G4 為例)
LL_USART_SetTxFIFOThreshold(USART1, LL_USART_FIFO_THRESHOLD_1_4);
LL_USART_SetRxFIFOThreshold(USART1, LL_USART_FIFO_THRESHOLD_1_4);
LL_USART_EnableFIFO(USART1);
開了硬體 FIFO 之後,CPU 不用每個 byte 都進中斷。舉個例子:TX FIFO 深度 8、觸發水準設 1/4,也就是 FIFO 還有 6 個空間才觸發中斷,中斷頻率直接降為原來的 1/8。
如果再搭上 DMA,威力更強:DMA 在後面默默把 FIFO 填滿,CPU 只要等一次「傳輸完成」的中斷就好,中間完全不用管事。
常用 FIFO 參數速查表
下面這張表是我自己在設計時最常回頭查的一組參數,留給同樣在跟 PCB、FPGA 打交道的你:
| 應用場景 | 寫入時鐘 (Write Clock) | 讀取時鐘 (Read Clock) | 資料寬度 (Data Width) | 建議深度 (Depth) | FIFO 類型 |
|---|---|---|---|---|---|
| UART RX | 16x baud rate | system clock | 8 bit | 16 | Async (Gray code) |
| SPI slave | SCK (max 40 MHz) | system clock | 8-32 bit | 8-16 | Async |
| ADC data stream | ADC clock (10 MHz) | DMA clock | 12-24 bit | 64-256 | Async |
| Ethernet MAC | GMII/RGMII | AHB bus | 32 bit | 512-4096 | Async |
| CPU instruction queue | CPU clock | CPU clock | 32-64 bit | 4-8 | Sync |
| Video line buffer | pixel clock | pixel clock | 24-48 bit | 1920+ | Sync |
| Audio I2S stream | BCLK | system clock | 16-32 bit | 16-64 | Async |
這張表幾乎涵蓋了嵌入式最常見的場景。從低速的 UART(Universal Asynchronous Receiver/Transmitter)一路到高速的 Ethernet MAC(Media Access Controller),深度和類型的選擇其實都取決於實際的 clock domain crossing 需求。
兩個提醒:Video line buffer 的深度至少要超過一行像素數(例如 1920),不然畫面會撕裂(tearing);Audio FIFO 則要顧好 sample rate 和 system clock 的比例,不然 audio underflow 或 overflow 就是爆音的來源。
FIFO 設計檢查表
在 FPGA 或 ASIC 裡設計 FIFO,我會照這份清單一項一項劃掉:
- 深度是不是 2ⁿ?(方便指針環繞)
- 指針寬度 = log₂(Depth) + 1,真的分得出空和滿嗎?
- 空滿邏輯:Empty 是所有位元相等;Full 是 MSB 不同、低位相等,對嗎?
- 格雷碼真的用在跨時域指針傳輸上了嗎?
- 同步器是二級(或三級)的嗎?
- Almost-Empty / Almost-Full 旗標有照應用需求設好嗎?
- 重置邏輯:重置後指針歸零、Empty 信號有效嗎?
- 同步器重置:兩級同步器的 FF 都有正確初始化嗎?
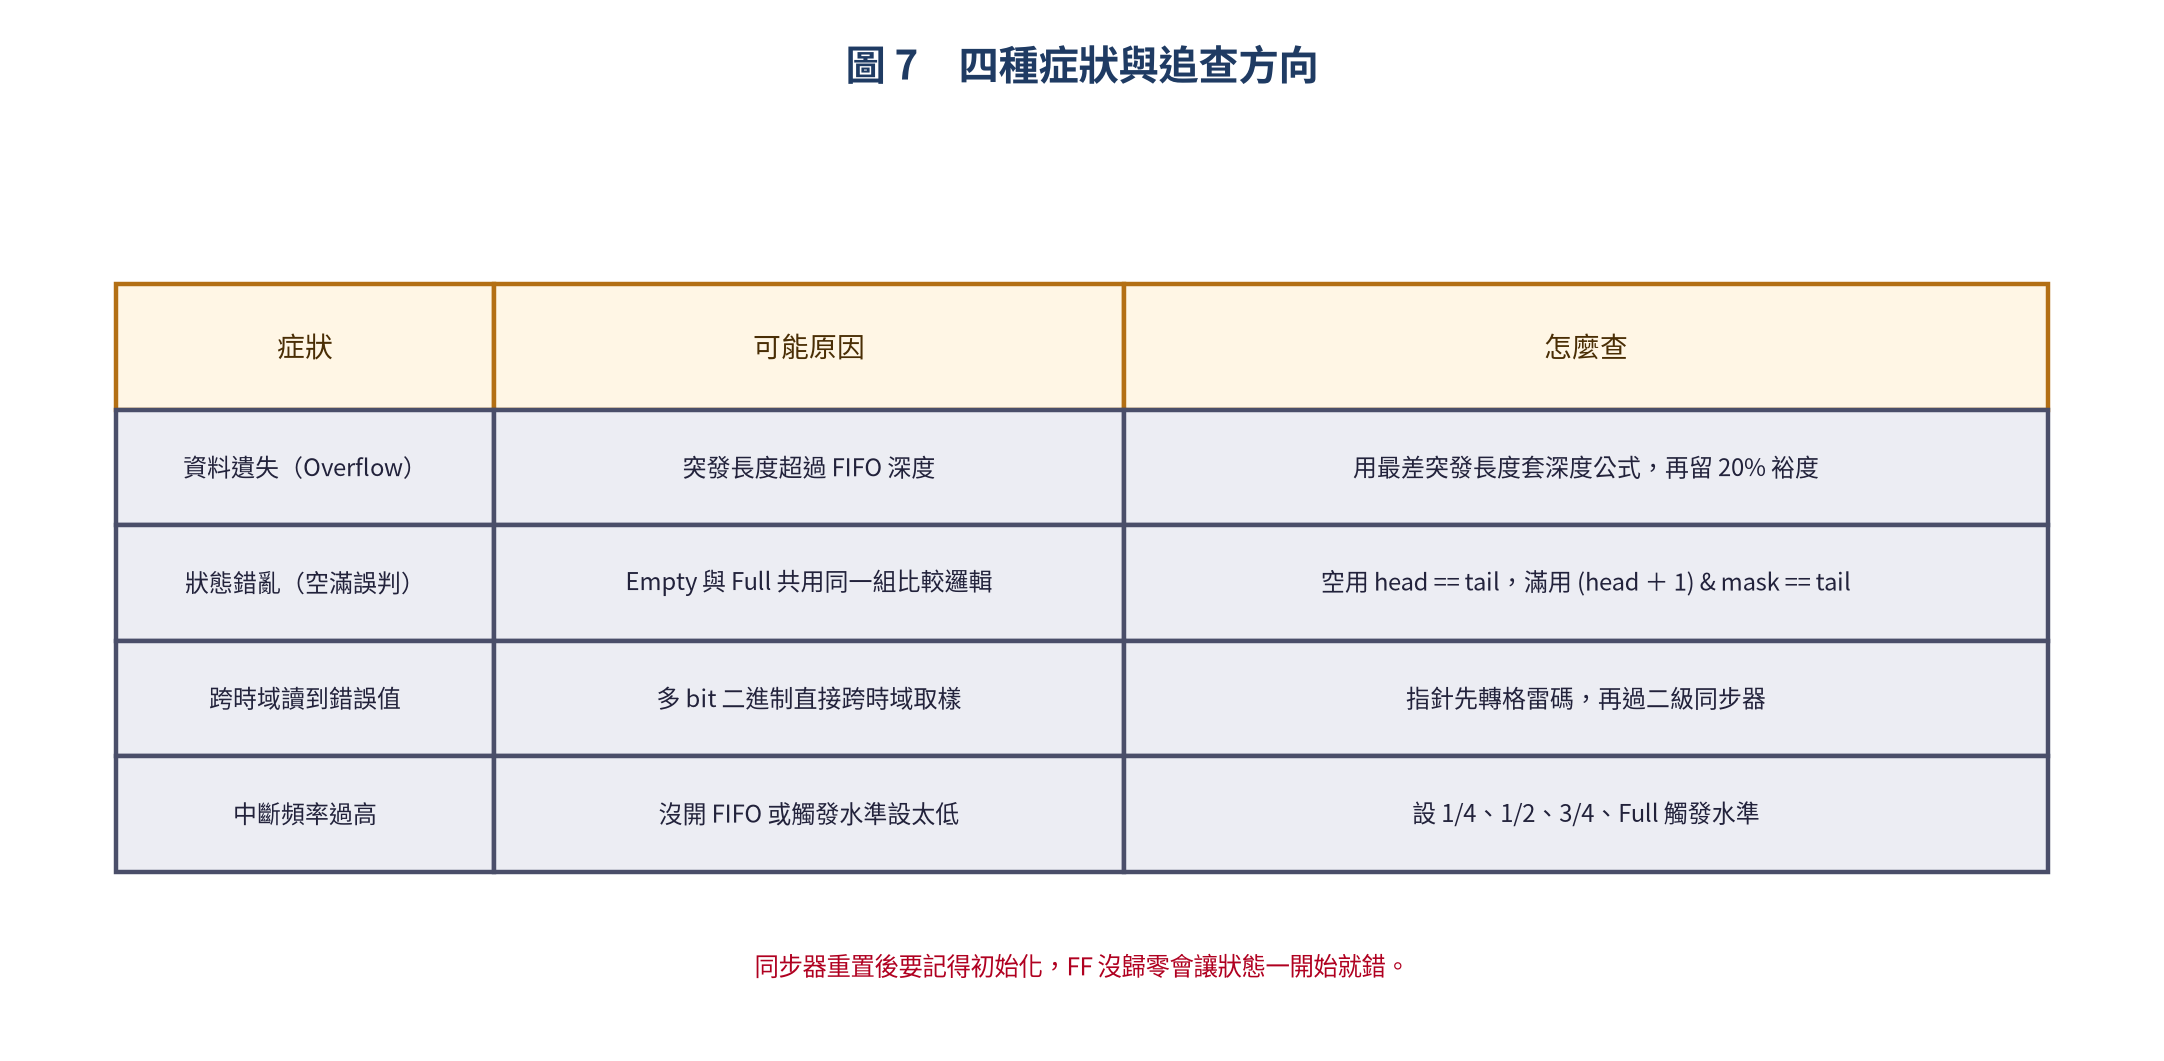
這份清單基本上就是 FIFO 的踩坑地圖。每次 tape-out 前花十分鐘跑一遍,可以省下好幾天的除錯。如果是量產產品,建議再加上可測試性設計(DFT),讓 FIFO 的狀態能透過 JTAG 邊界掃描驗證。
總結
FIFO 是嵌入式設計的基本功。不管是硬體 FIFO(STM32 的 USART/SPI FIFO、FPGA 的 Async FIFO)還是軟體 Ring Buffer,核心永遠是同一句話:雙口儲存 + 指針管理 + 空滿判斷。
三個最容易忘的重點:跨時域記得用格雷碼,深度計算要看最差突發而不是平均值,Ring Buffer 大小取 2ⁿ 讓取模變快。這幾件事抓穩,FIFO 設計就不太會出事了。
延伸閱讀:PID 演算法 · SPI 通訊實戰 · RS485 通訊教學

文章評論