前言
我還記得第一次把 MEMS 麥克風接上 MCU 的那個下午。資料線接了、電源也給了,程式跑起來卻只拿到一整片雜訊。後來才發現問題出在時脈 —— 我把 I2S 當成 SPI 在用,少想了一件事:這個協定是為「連續不斷的音訊」設計的,不是為「偶爾傳幾個位元組」設計的。
I2S 通訊協定(Inter-IC Sound,也寫作 I²S)是飛利浦在 1986 年制定的數位音訊序列匯流排標準。不同於 SPI 或 I2C 的通用性,I2S 是專門為數位音訊設計的,用於在音訊編解碼晶片(Audio Codec)、MEMS 麥克風、DSP 和 MCU 之間傳輸 PCM 音訊資料。ESP32 內建了兩組 I2S 控制器,STM32 也有多組 SPI/I2S 可配置的周邊,這使得 I2S 成為嵌入式音訊專案的首選介面。
如果你還沒碰過序列匯流排,先看 SPI 通訊實戰會比較有感覺,I2S 的時序概念跟它最接近。這篇我打算從時序、模式、硬體設計一路講到實際程式碼,把 I2S 一次搞懂。
一、I2S 通訊協定基本概念
1.1 訊號線
I2S 使用三條訊號線(加上可選的 MCLK):
- SCK(Serial Clock / Bit Clock):位元時脈,每個 SCK 週期傳送一個位元
- WS(Word Select / Frame Sync):聲道選擇,0=左聲道,1=右聲道
- SD(Serial Data):序列資料線,可配置為輸入(SDI)或輸出(SDO)
- MCLK(Master Clock,可選):主時脈,通常為 256×FS 或 512×FS
三條線的分工很乾淨:SCK 負責「什麼時候看」,WS 負責「現在講左耳還是右耳」,SD 才是真正的資料。我在心裡的記法是 SCK 是節拍器、WS 是左右手、SD 才是球。
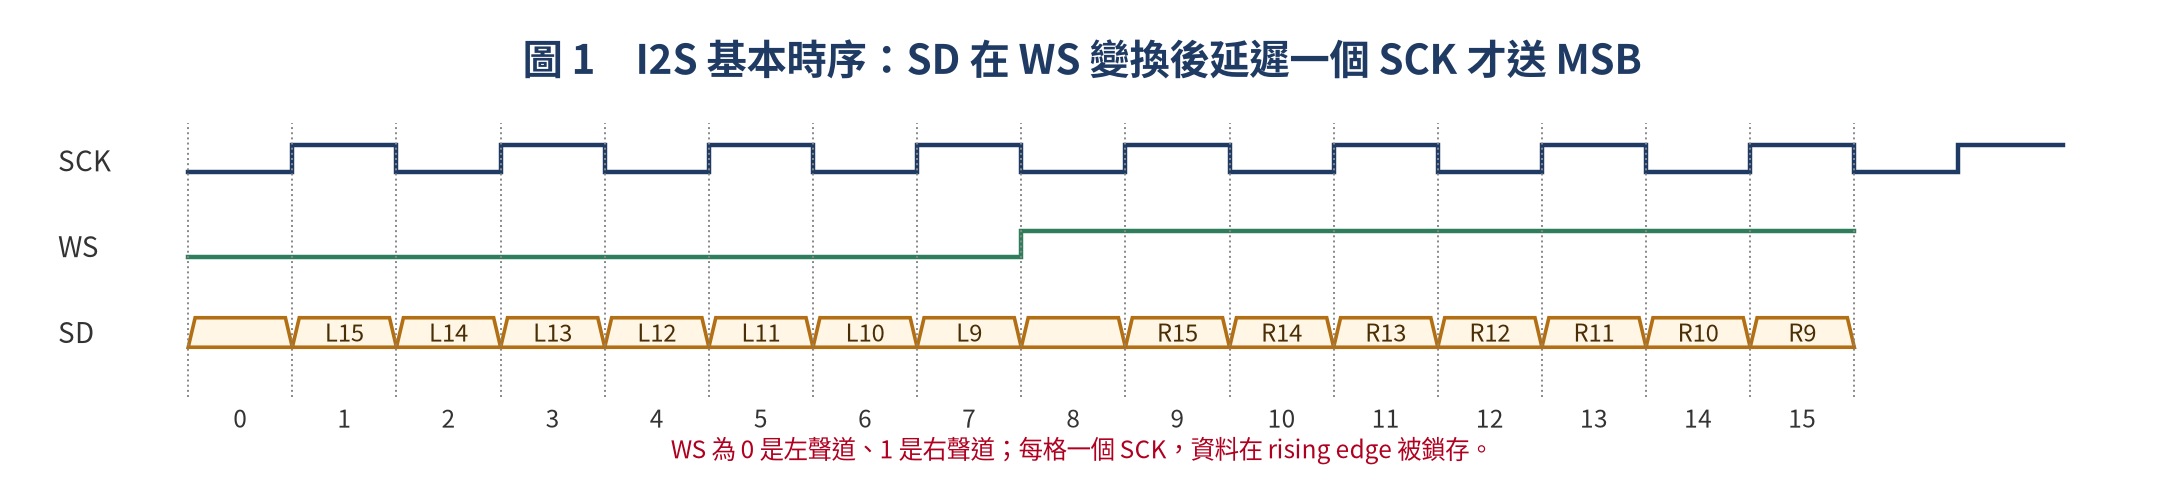
看圖就知道為什麼它比 SPI 適合音訊:SCK 從頭到尾沒有停過,WS 每半個幀翻一次,SD 則是在 WS 變換後先空一拍,才把 MSB 推出來。這一拍就是 I2S 最重要的身分證。
1.2 時序特性
I2S 的核心特性是 MSB 先行(MSB First)且在 WS 變換後延遲一個 SCK 週期開始傳送(標準 Philips 模式)。這與 SPI 的 CPOL/CPHA 概念類似,但專門為連續的立體聲 PCM 資料做了優化。
- WS 變換表示聲道切換(左→右→左→右...)
- SD 資料在 SCK 的 rising edge 鎖存
- 發送端在 SCK 的 falling edge 更新資料
為什麼要特地延遲一拍?因為發送端要留時間把下一個聲道的第一個位元推上線。這個設計有個副作用值得記著:同一個幀裡,資料的位數可以比實際有效位數多(例如 16-bit 資料塞進 32-bit 幀),多出來的位置補 0 就好,接收端只要知道對齊方式就不會誤判。
1.3 常見模式比較
雖然大家都叫 I2S,但「資料從哪一拍開始」這件事其實有三種派別,這張表是我最常回頭查的一張:
| 模式 | MSB 起始點 | 相容性 |
|---|---|---|
| I2S Philips(標準) | WS 變換後延遲 1 SCK | 最廣泛支援 |
| Left-Justified | WS 變換後立即輸出 MSB | 某些老 Codec 使用 |
| Right-Justified | WS 變換後延遲到 LSB 對齊幀尾 | 日本廠商常見 |
| TDM(Time Division Multiplexed) | 多聲道分時共用一條 SD 線 | 多聲道系統(8ch+) |
把它畫成波形就更清楚:標準模式空一拍、左對齊不空拍,差別只在 MSB 的位置。
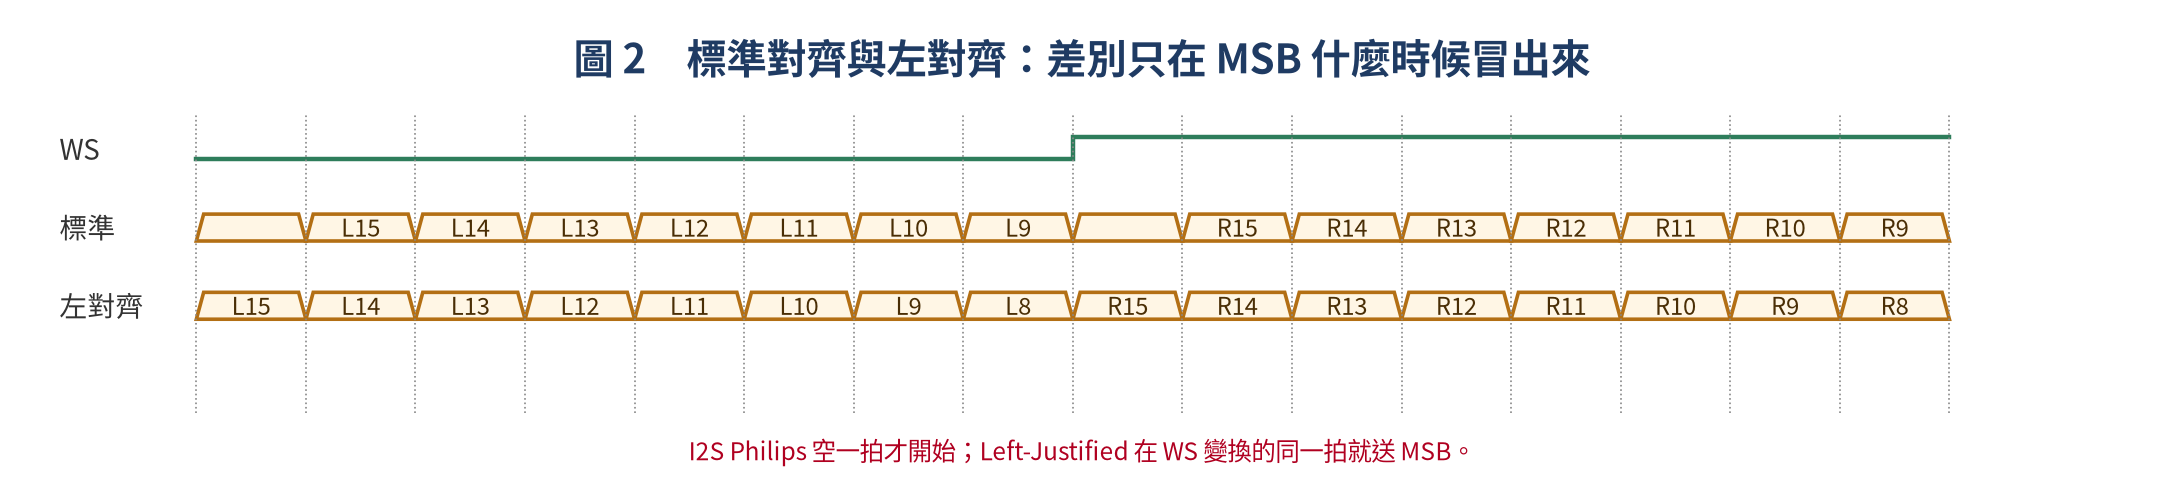
這也是我踩過的第一個坑:Codec 的 datasheet 寫「Left-Justified」時,程式如果還是照 I2S Philips 設定,結果通常不是完全沒聲音,而是音量忽大忽小、聲音像被砍掉一半 —— 因為 MSB 被當成第二個位元,整個數值位移了。遇到這種症狀,先懷疑對齊模式。
二、取樣率與 SCK 計算
I2S 的 SCK 頻率由取樣率和資料寬度決定:
SCK = FS × Bits × Channels例如 CD 音質(44.1 kHz、16-bit、立體聲):
SCK = 44100 × 16 × 2 = 1.4112 MHz如果 Codec 要求 32-bit 幀(即使實際只用 16-bit data 也補 0):
SCK = 44100 × 32 × 2 = 2.8224 MHz (= 64 × FS)算完公式,接著把常見的取樣率一次列出來對照。MCLK 的倍率我也一起放進來,因為有些 Codec 是「沒有 MCLK 就完全不動」的那種:
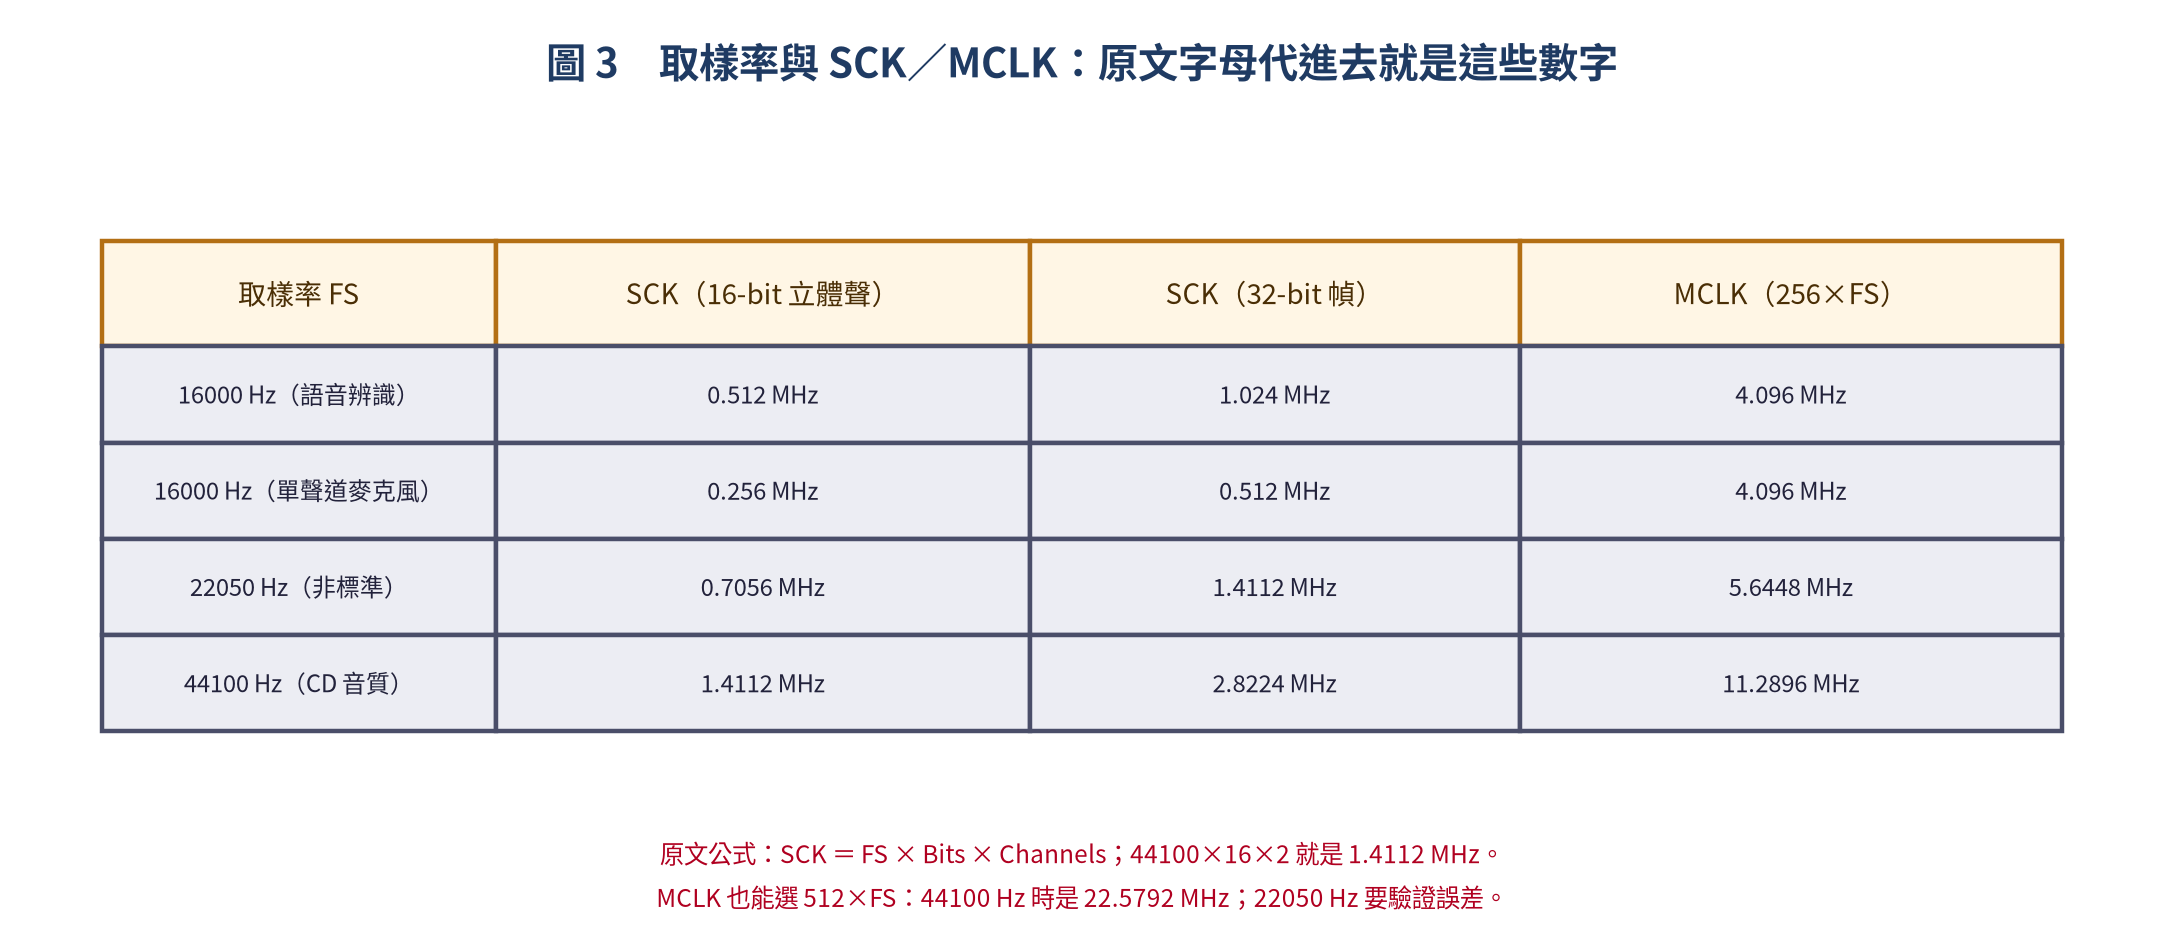
實務上注意:ESP32 的 I2S clock 來自 APLL(Audio PLL),頻率解析度有限。使用非標準取樣率(如 22050 Hz)時務必驗證實際 SCK 與目標誤差。
「誤差」這件事在音訊裡很現實:SCK 差 1% 對 UART 可能沒事,但對連續播放來說就是每 100 秒漏掉 1 秒的資料,聽起來會是週期性的喀噠聲。所以正式產品我一定會拿儀器量一次實際頻率。
三、I2S 硬體設計
3.1 系統架構
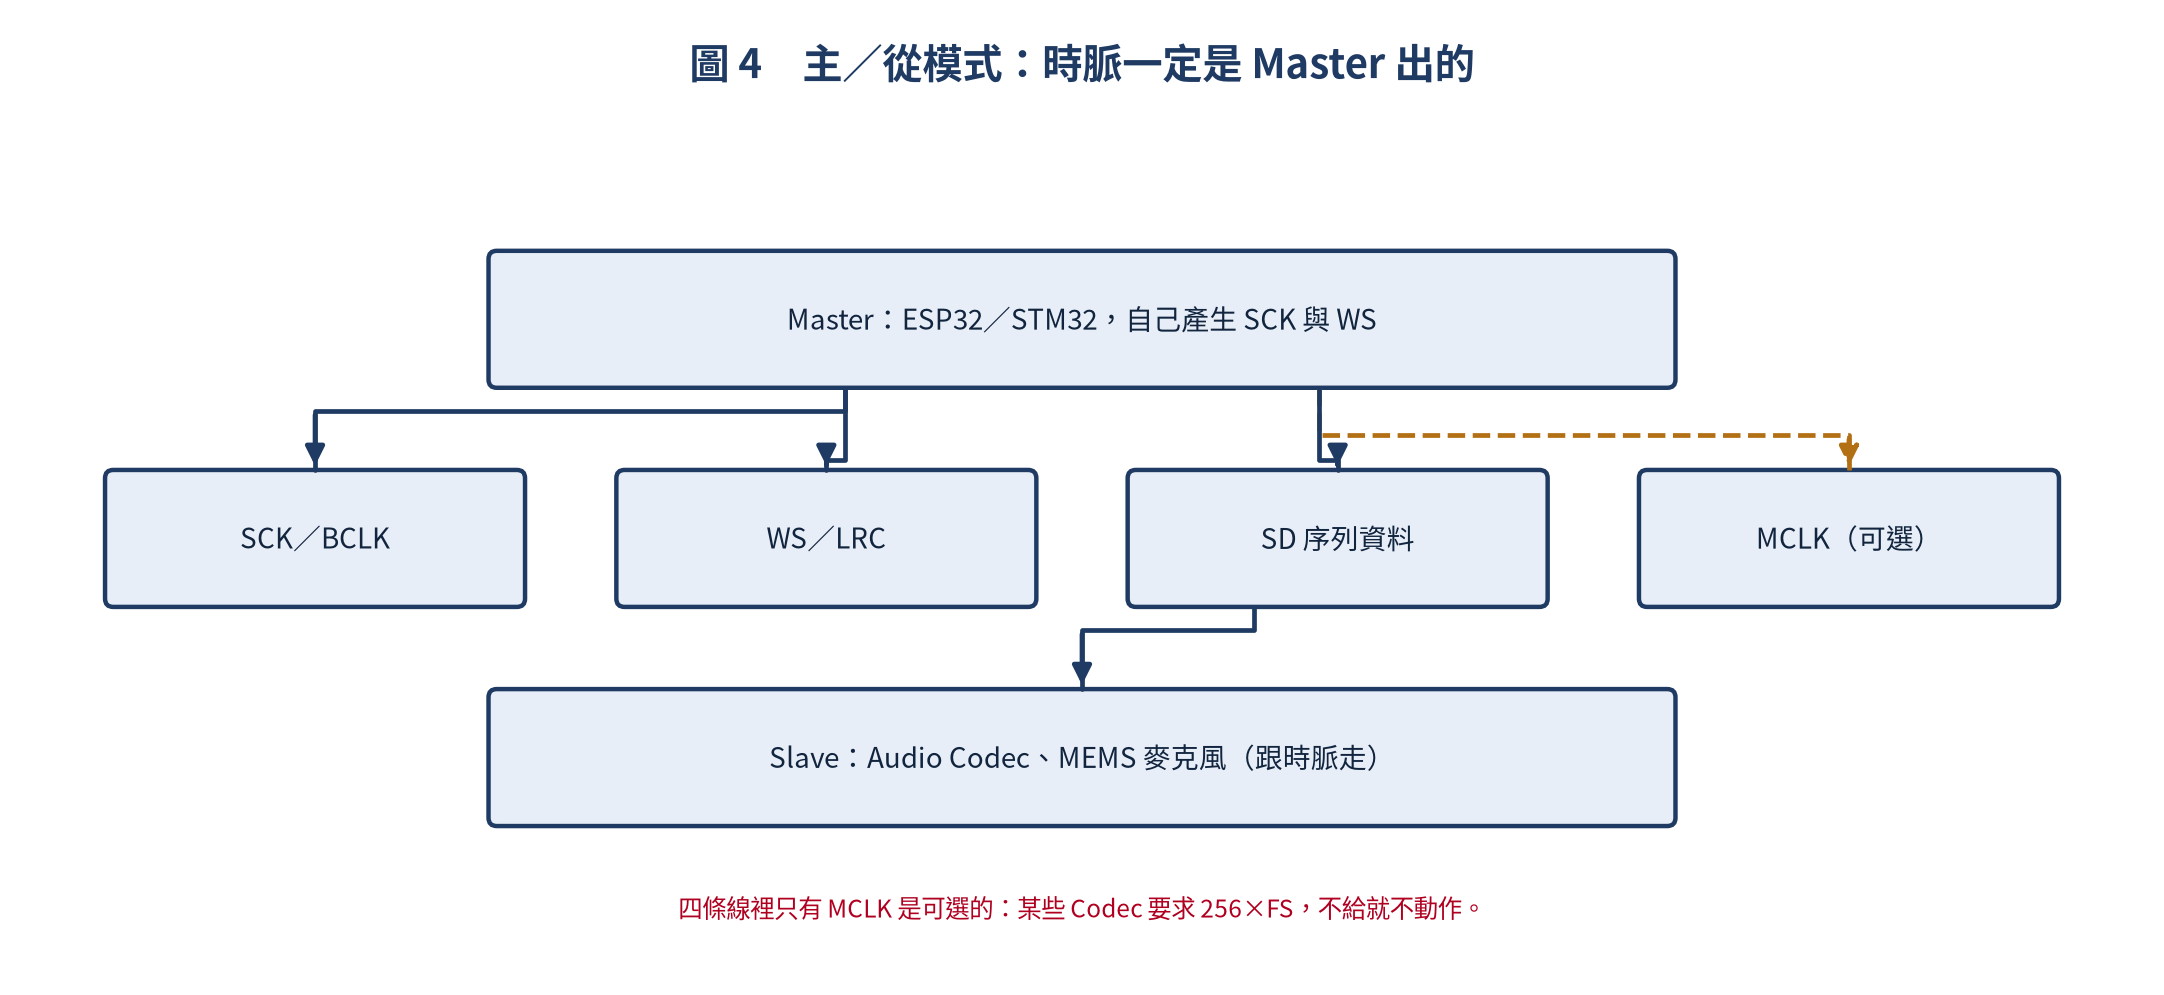
架構只有一句話:ESP32/STM32 作為 Master 產生 SCK 和 WS,Audio Codec 和 MEMS 麥克風作為 Slave。Master 出時脈、Slave 跟時脈,這件事沒得商量 —— 你在很多音訊模組上看到「只能當 Slave」的說明,就是這個意思。
四條線裡唯一可選的是 MCLK。要不要接,取決於另一頭是誰:單純的 DAC(像 MAX98357)常常自己搞定時脈,但 WM8960 這類 Codec 就會明確要求 MCLK。
3.2 常見 I2S 元件
玩過的元件大概就是這幾顆,先看表再決定要買哪一塊:
| 元件 | 類型 | 說明 |
|---|---|---|
| MAX98357 / I2S 放大器 | DAC | 3W 單聲道 D 類功放,I2S 輸入直驅喇叭 |
| WM8960 | Codec | 雙聲道 DAC+ADC,常見於 ESP32-Audio-Kit |
| INMP441 | MEMS Mic | 全向 MEMS 麥克風,I2S 輸出 |
| CS4344 | DAC | 低價立體聲 DAC,24-bit/192kHz |
如果你要的是「把數位訊號變成聽得到的聲音」,這幾顆 I2S DAC 跟 DAC 原理講的是同一件事,只是 I2S DAC 把比較器與輸出級都包進去了。
3.3 接線注意事項
- MCLK 問題:某些 Codec(如 WM8960)需要 MCLK = 256×FS。ESP32 可輸出 MCLK,STM32 某些系列無獨立 MCLK 輸出
- 電壓位準:3.3V 為共識;5V Codec 需電平轉換
- SCK 頻率上限:ESP32 I2S 最高約 40 MHz(實際受 APLL 限制);STM32 SPI/I2S 最高約 37.5 MHz(@150 MHz HCLK)
- BCK 極性:I2S 標準要求 SCK idle = low,但某些 Codec 支援 idle = high
接線出錯的機率遠高於程式寫錯。我自己的順序是:先接三條必要的(SCK、WS、SD)、先讓它出聲,最後才處理 MCLK 與極性。一次把全部接上去,出事時你會有太多可疑對象。
四、ESP32 I2S 實作(Arduino 框架)
先看整條路徑長什麼樣,心裡有個地圖再寫程式:
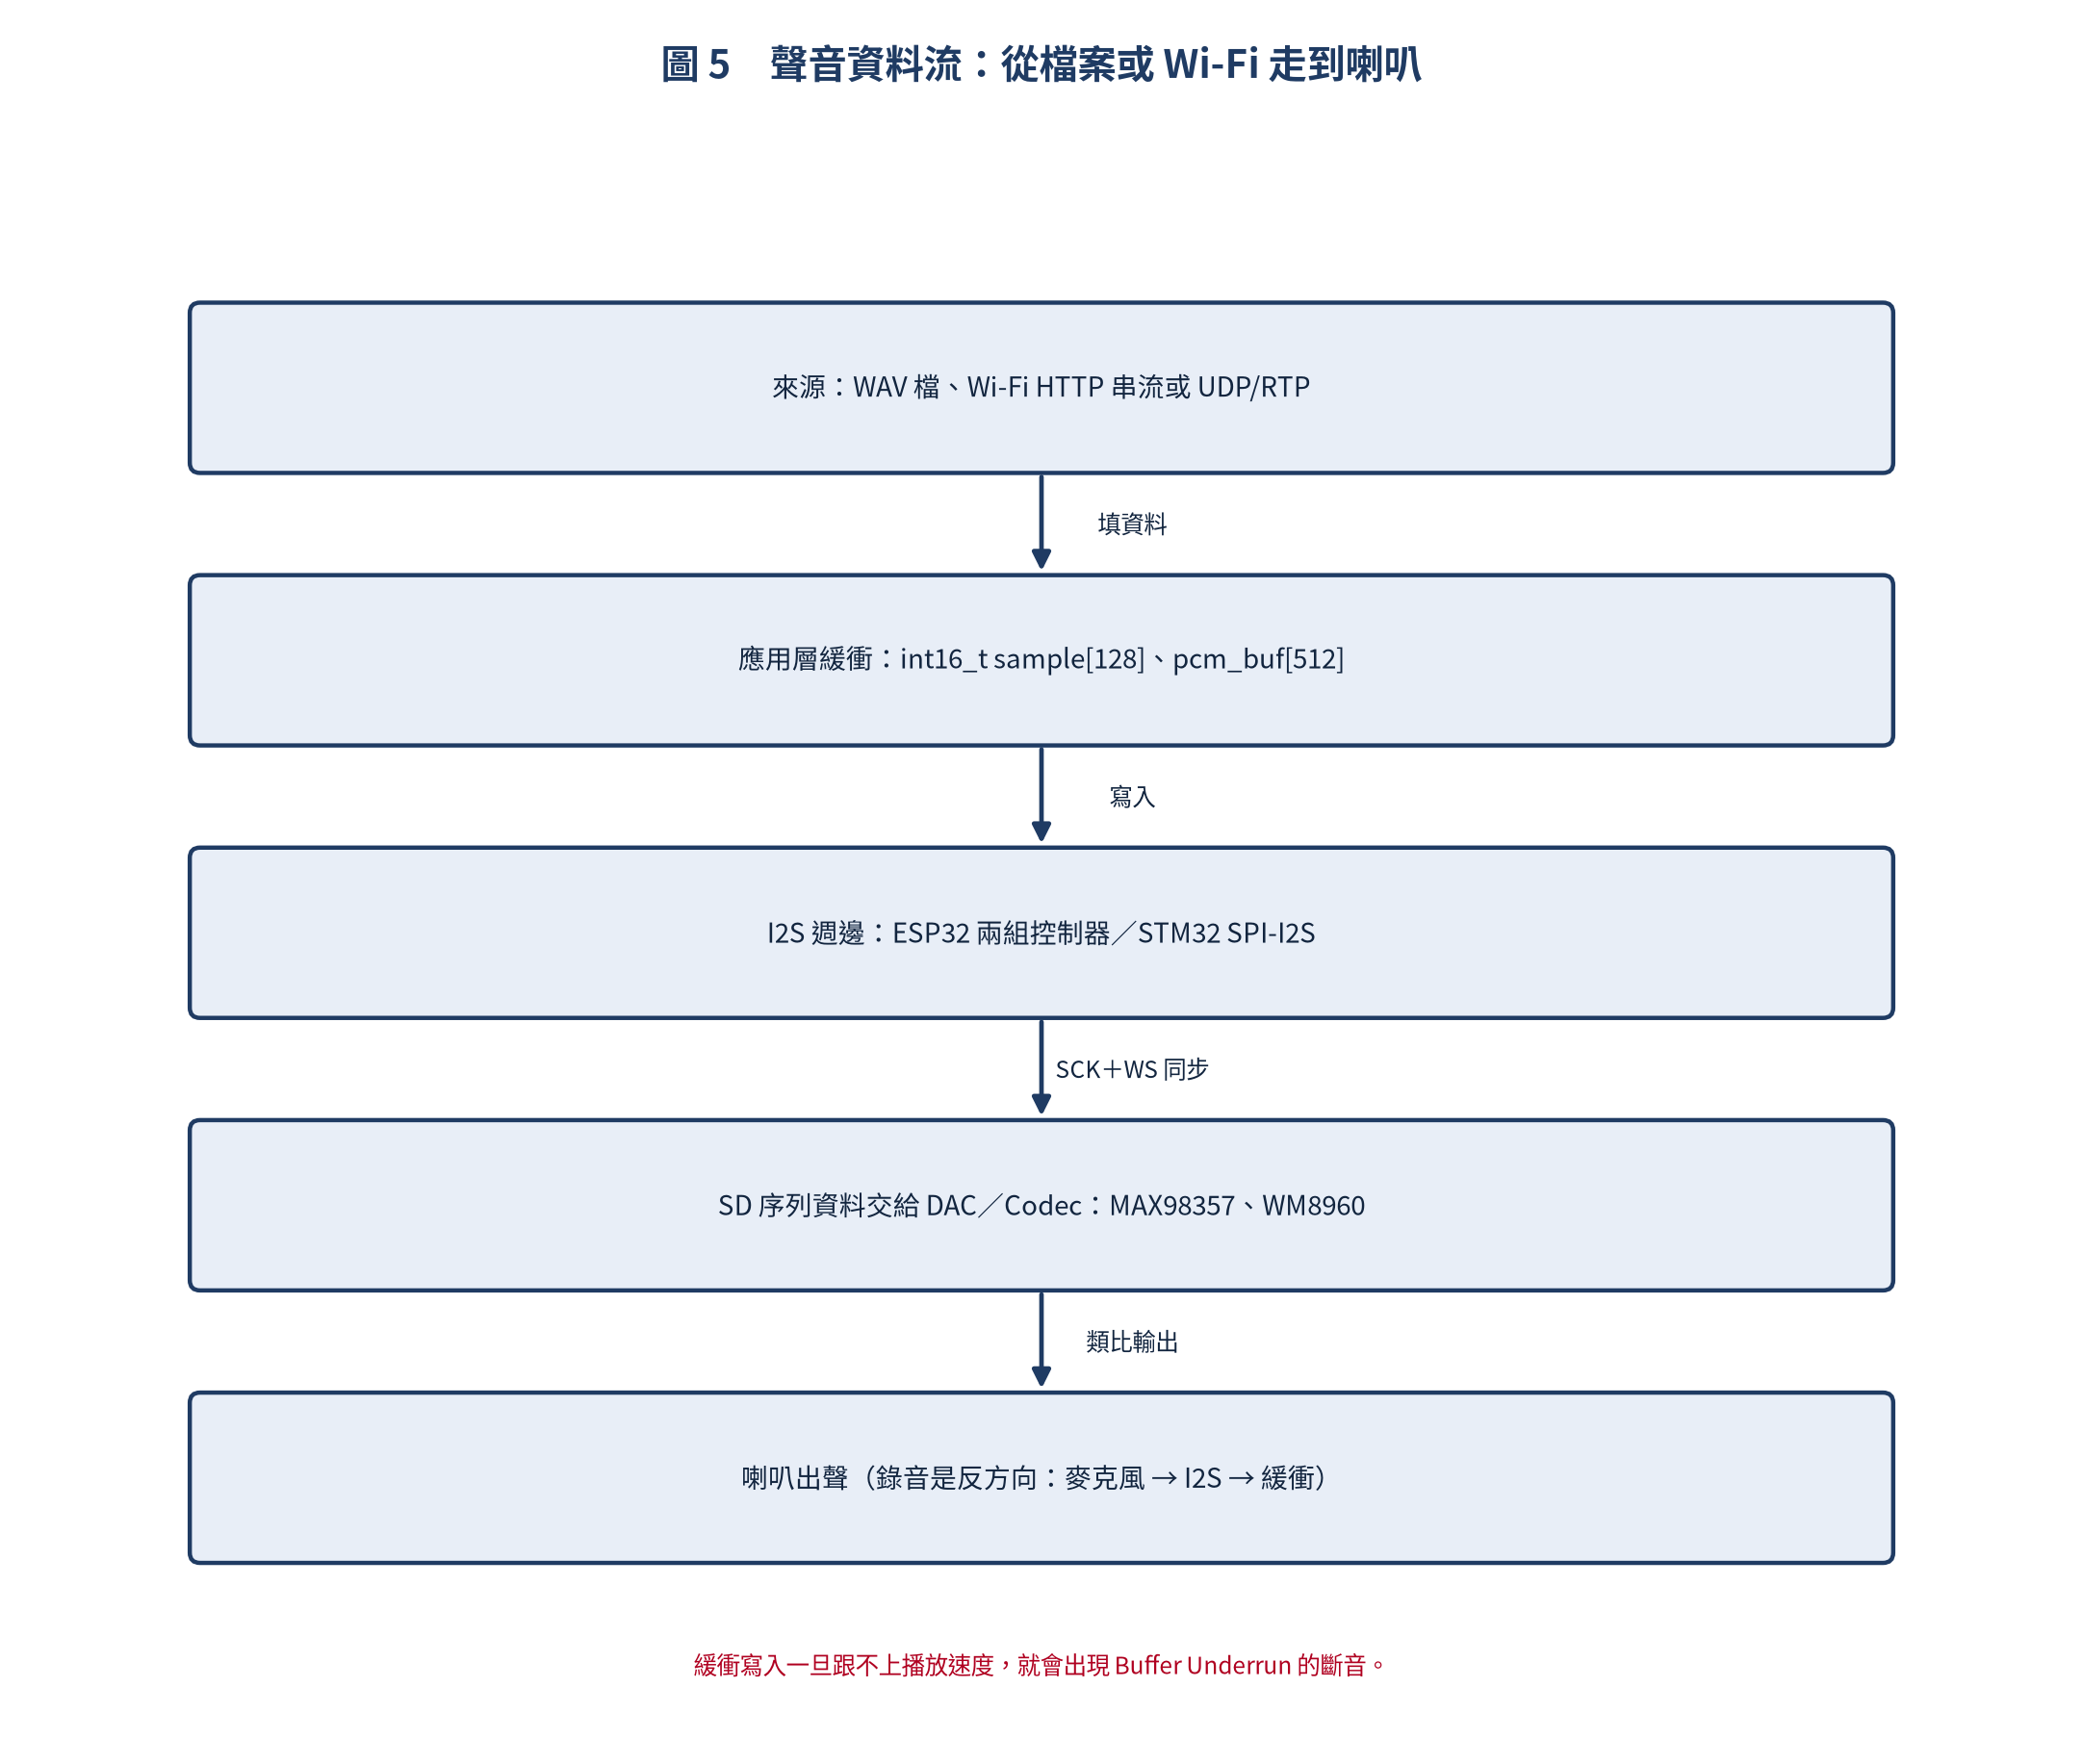
Arduino 框架的好處是它把 I2S 的初始化壓成兩行,壞處是你會不知道底下發生了什麼。這節兩個方向(播放與錄音)我都給範例。
4.1 I2S 音訊輸出(播放 WAV)
#include <I2S.h>

#define I2S_BCK  26
#define I2S_WS   25
#define I2S_DOUT 22  // 資料輸出
#define I2S_DIN  21  // 資料輸入(麥克風用)

void setup()
{
    Serial.begin(115200);

    // 配置 I2S
    I2S.setPins(I2S_BCK, I2S_WS, I2S_DOUT, I2S_DIN);

    if (!I2S.begin(I2S_PHILIPS_MODE, 44100, 16))
    {
        Serial.println("I2S init failed!");
        while (1);
    }
    Serial.println("I2S OK - 44.1kHz 16-bit");
}

void loop()
{
    // 產生 440 Hz 正弦波測試音
    static float phase = 0;
    int16_t sample[128];
    const float freq = 440.0;
    const float fs   = 44100.0;

    for (int i = 0; i < 128; i++)
    {
        float val = sin(2 * PI * freq * phase / fs);
        sample[i] = (int16_t)(val * 16000);  // 振幅 ±16000
        phase++;
    }

    // 寫入 I2S(立體聲:左右聲道相同)
    size_t written = I2S.write((uint8_t *)sample, sizeof(sample));
    if (written != sizeof(sample))
        Serial.printf("Underrun! Wrote %d / %d\n", written, sizeof(sample));
}
這段有兩個細節值得停下來看:
I2S.begin(I2S_PHILIPS_MODE, 44100, 16)—— 模式、取樣率、位元深度,三個參數就決定後面所有的時序sample[i] = (int16_t)(val * 16000)—— 振幅刻意留了 headroom(16-bit 的滿刻度是 32767),這是我吃過爆音之後學到的習慣
另外那個 written != sizeof(sample) 的檢查不要刪。它就是在抓 Buffer Underrun —— 播放速度比填資料快的時候,你會先在這裡看到訊息,而不是等到耳朵聽到斷音。
4.2 I2S 音訊輸入(MEMS 麥克風錄音)
#include <I2S.h>

#define I2S_BCK  26
#define I2S_WS   25
#define I2S_DIN  34     // INMP441 資料輸出腳

const int sample_rate = 16000;  // 語音辨識常用 16 kHz
const int bits = 16;
const int buffer_size = 512;

int16_t samples[buffer_size];

void setup()
{
    Serial.begin(115200);
    I2S.setPins(I2S_BCK, I2S_WS, -1, I2S_DIN);  // 僅輸入

    if (!I2S.begin(I2S_PHILIPS_MODE, sample_rate, bits))
    {
        Serial.println("I2S init failed!");
        while (1);
    }
}

void loop()
{
    size_t bytes_read = I2S.readBytes((char *)samples, buffer_size * 2);
    int samples_read = bytes_read / 2;

    // 計算 RMS 音量
    float sum_sq = 0;
    for (int i = 0; i < samples_read; i++)
        sum_sq += (float)samples[i] * samples[i];

    float rms = sqrt(sum_sq / samples_read);
    Serial.printf("RMS: %.2f\tPeak: %d\n", rms, samples[0]);

    delay(100);
}
錄音跟播放最大的差別有兩個:一是 I2S.setPins() 把輸出腳位設成 -1(告訴它我只要輸入);二是取樣率換成 16000 Hz,因為語音辨識常用 16 kHz,資料量直接少一半。
輸出用 RMS 而不是瞬時值,是因為音量的感知本來就是平均值。你如果直接印 samples[0],看到的數字會像樂透開獎一樣亂跳。
4.3 使用 I2S 讀取 INMP441 並透過 Wi-Fi 串流
#include <WiFi.h>
#include <I2S.h>

const char *ssid = "SSID";
const char *pass = "PASSWORD";
WiFiServer server(8080);

void setup()
{
    Serial.begin(115200);
    WiFi.begin(ssid, pass);

    I2S.setPins(26, 25, -1, 34);
    I2S.begin(I2S_PHILIPS_MODE, 16000, 16);

    server.begin();
    Serial.printf("Server started: %s:8080\n", WiFi.localIP().toString().c_str());
}

void loop()
{
    WiFiClient client = server.available();
    if (!client) return;

    // 持續串流 PCM 資料到客戶端
    uint8_t buf[512];
    while (client.connected())
    {
        size_t n = I2S.readBytes((char *)buf, 512);
        if (n > 0) client.write(buf, n);
    }
    client.stop();
}
這段就是把麥克風變成一個 TCP 音訊伺服器:server.available() 等到有人連進來,接著就是無止境地 readBytes() 再 write()。寫起來很短,但它同時點出了 I2S 的實務限制 —— I2S 只負責把資料搬進來,怎麼送出去是另一件事,而 Wi-Fi 的抖動會直接反映在你的緩衝策略上。
五、ESP32 I2S 實作(ESP-IDF 框架)
5.1 基本 I2S 初始化
ESP-IDF 的設定看起來很長,但結構其實很一致:通道參數、時脈參數、slot 參數、GPIO,一層一層填進去。
#include "driver/i2s_std.h"
#include "driver/gpio.h"

#define I2S_PORT  I2S_NUM_0

i2s_chan_handle_t tx_handle;

void i2s_init(void)
{
    i2s_chan_config_t chan_cfg = I2S_CHANNEL_DEFAULT_CONFIG(
        I2S_PORT, I2S_ROLE_MASTER);

    i2s_std_config_t std_cfg = {
        .clk_cfg = {
            .sample_rate_hz  = 44100,
            .clk_src         = I2S_CLK_SRC_DEFAULT,
            .mclk_multiple   = I2S_MCLK_MULTIPLE_256,
        },
        .slot_cfg = {
            .data_bit_width  = I2S_DATA_BIT_WIDTH_16BIT,
            .slot_bit_width  = I2S_SLOT_BIT_WIDTH_16BIT,
            .slot_mode       = I2S_SLOT_MODE_STEREO,
            .slot_mask       = I2S_STD_SLOT_BOTH,
            .ws_width        = I2S_DATA_BIT_WIDTH_16BIT,
            .ws_pol          = false,
            .bit_shift       = true,    // I2S Philips: delay 1 SCK
        },
        .gpio_cfg = {
            .mclk = GPIO_NUM_NC,
            .bclk = GPIO_NUM_26,
            .ws   = GPIO_NUM_25,
            .dout = GPIO_NUM_22,
            .din  = GPIO_NUM_21,
            .invert_flags = {
                .mclk_inv = false,
                .bclk_inv = false,
                .ws_inv   = false,
            },
        },
    };

    i2s_new_channel(&chan_cfg, &tx_handle, NULL);
    i2s_channel_init_std_mode(tx_handle, &std_cfg);
    i2s_channel_enable(tx_handle);
}

void play_sine(void)
{
    int16_t buf[256];
    static float phase = 0;

    for (int i = 0; i < 256; i += 2)
    {
        float val = sin(phase);
        int16_t s = (int16_t)(val * 16000);
        buf[i]   = s;   // 左聲道
        buf[i+1] = s;   // 右聲道
        phase += 2 * 3.14159 * 440.0 / 44100.0;
    }

    size_t written;
    i2s_channel_write(tx_handle, buf, 256 * 2, &written, portMAX_DELAY);
}
有兩行是我每次都會特別確認的:
.bit_shift = true—— 這就是「延遲一個 SCK」的開關,對應 I2S Philips 模式(註解原文就是這樣寫的).mclk_multiple = I2S_MCLK_MULTIPLE_256—— MCLK 的倍率,要跟 Codec 的需求一致
跟 Arduino 版比起來,IDF 版多給你的是控制權:i2s_new_channel()、i2s_channel_init_std_mode()、i2s_channel_enable() 是三個獨立步驟,所以你也可以先建好通道、之後再決定要不要啟用。彈性變大,出錯時的檢查點也變多。
六、STM32 I2S 實作(HAL Library)
STM32 的 SPI 周邊可以配置為 I2S 模式(SPI_I2S)。以 STM32F407 為例,SPI2 可映射到 I2S2。這個「同一個周邊、兩種身分」的設計是 STM32 的特色,也是我第一次看 CubeMX 時最困惑的地方。
6.1 CubeMX 配置
- 設定 SPI2 / I2S2 為 Full-Duplex Master
- Standard = I2S Philips
- Data format = 16-bit
- Audio frequency = 44.1 kHz
- CK/Pin = PB13(SCK), WS = PB12, SD = PB15, MCK = PC6
這五項裡最容易漏掉的是最後一項的 MCK。CubeMX 預設不一定把 MCK 腳位打開,等你發現 Codec 沒反應才回頭找,就會多花半個小時。
6.2 I2S 初始化程式碼
#include "stm32f4xx_hal.h"

SPI_HandleTypeDef hspi2;

void MX_I2S2_Init(void)
{
    hspi2.Instance = SPI2;
    hspi2.Init.Mode = SPI_MODE_MASTER;
    hspi2.Init.Direction = SPI_DIRECTION_2LINES;
    hspi2.Init.DataSize = SPI_DATASIZE_16BIT;
    hspi2.Init.CLKPolarity = SPI_POLARITY_LOW;
    hspi2.Init.CLKPhase = SPI_PHASE_1EDGE;
    hspi2.Init.NSS = SPI_NSS_SOFT;
    hspi2.Init.BaudRatePrescaler = SPI_BAUDRATEPRESCALER_4;
    hspi2.Init.FirstBit = SPI_FIRSTBIT_MSB;
    hspi2.Init.TIMode = SPI_TIMODE_DISABLE;
    hspi2.Init.CRCCalculation = SPI_CRCCALCULATION_DISABLE;
    hspi2.Init.CRCPolynomial = 10;
    HAL_SPI_Init(&hspi2);
}

void HAL_SPI_MspInit(SPI_HandleTypeDef *hspi)
{
    GPIO_InitTypeDef gpio = {0};

    __HAL_RCC_SPI2_CLK_ENABLE();
    __HAL_RCC_GPIOB_CLK_ENABLE();

    // PB13 = SCK, PB12 = WS, PB15 = SD
    gpio.Mode = GPIO_MODE_AF_PP;
    gpio.Pull = GPIO_NOPULL;
    gpio.Speed = GPIO_SPEED_FREQ_MEDIUM;
    gpio.Alternate = GPIO_AF5_SPI2;

    gpio.Pin = GPIO_PIN_13 | GPIO_PIN_12 | GPIO_PIN_15;
    HAL_GPIO_Init(GPIOB, &gpio);
}

void i2s_send_sample(uint16_t left, uint16_t right)
{
    uint16_t frame[2] = {right, left};  // I2S: WS=0=左, WS=1=右
    HAL_SPI_Transmit(&hspi2, (uint8_t *)frame, 2, HAL_MAX_DELAY);
}

void play_tone(void)
{
    for (int i = 0; i < 44100; i++)
    {
        float t = (float)i / 44100.0;
        int16_t s = (int16_t)(sin(2 * 3.14159 * 440 * t) * 16000);
        i2s_send_sample(s, s);  // 左右聲道相同
    }
}這段裡我特別想指出一行:uint16_t frame[2] = {right, left};。順序是右聲道先放。原因是 WS 在一個幀開始時是 0(左聲道),但 I2S 標準又要求資料延遲一拍,所以第一個被送出去的其實是屬於 WS=1 的那個半幀。這個「看起來寫反了」的地方,就是很多人第一次用 STM32 接 Codec 時左右聲道顛倒的元凶。
另外 HAL_SPI_MspInit() 裡的 Alternate = GPIO_AF5_SPI2 也值得記:GPIO 的 AF 號碼對不上,波形就完全不會出現,而且不會有任何錯誤訊息。除錯時如果連 SCK 都量不到,先回來查這個。
七、實戰專案:Wi-Fi 網路音訊播放器
結合 ESP32 的 Wi-Fi 和 I2S,可以實作一個簡單的網路音訊播放器:
// 伺服器端(發送 PCM 資料)
# ESP32 作為 HTTP 音訊串流伺服器
// 見 4.3 的 Wi-Fi 串流範例

// 客戶端(收聽端)
# 任何支援 HTTP 的裝置:
curl http://esp32-ip:8080 --output - | aplay -r16000 -fS16_LE -c1
這個架構很適合當成第一個音訊專案,因為它把兩端都拆得很乾淨:ESP32 只負責「把 PCM 資料丟出來」,收聽端只要支援 HTTP 就聽得到。不過它有個天生的缺點 —— TCP 為了可靠度會重傳,重傳就意味著延遲。
如果要實現低延遲(<200ms)串流,改用 UDP/RTP 而非 TCP:
#include <WiFiUdp.h>

WiFiUDP udp;
const int port = 1234;
uint8_t pcm_buf[512];

void udp_stream_task(void *param)
{
    while (1)
    {
        // 從 I2S 讀取音訊
        size_t n = I2S.readBytes((char *)pcm_buf, 512);

        // 透過 UDP 發送
        udp.beginPacket(dest_ip, dest_port);
        udp.write(pcm_buf, n);
        udp.endPacket();
    }
}
把 TCP 換成 UDP 之後,丟包就變成你要自己面對的問題。這也是我在音訊專案裡對緩衝特別有感覺的原因:FIFO 緩衝的深度算得不夠,換什麼協定都還是會斷音。
八、常見問題與除錯
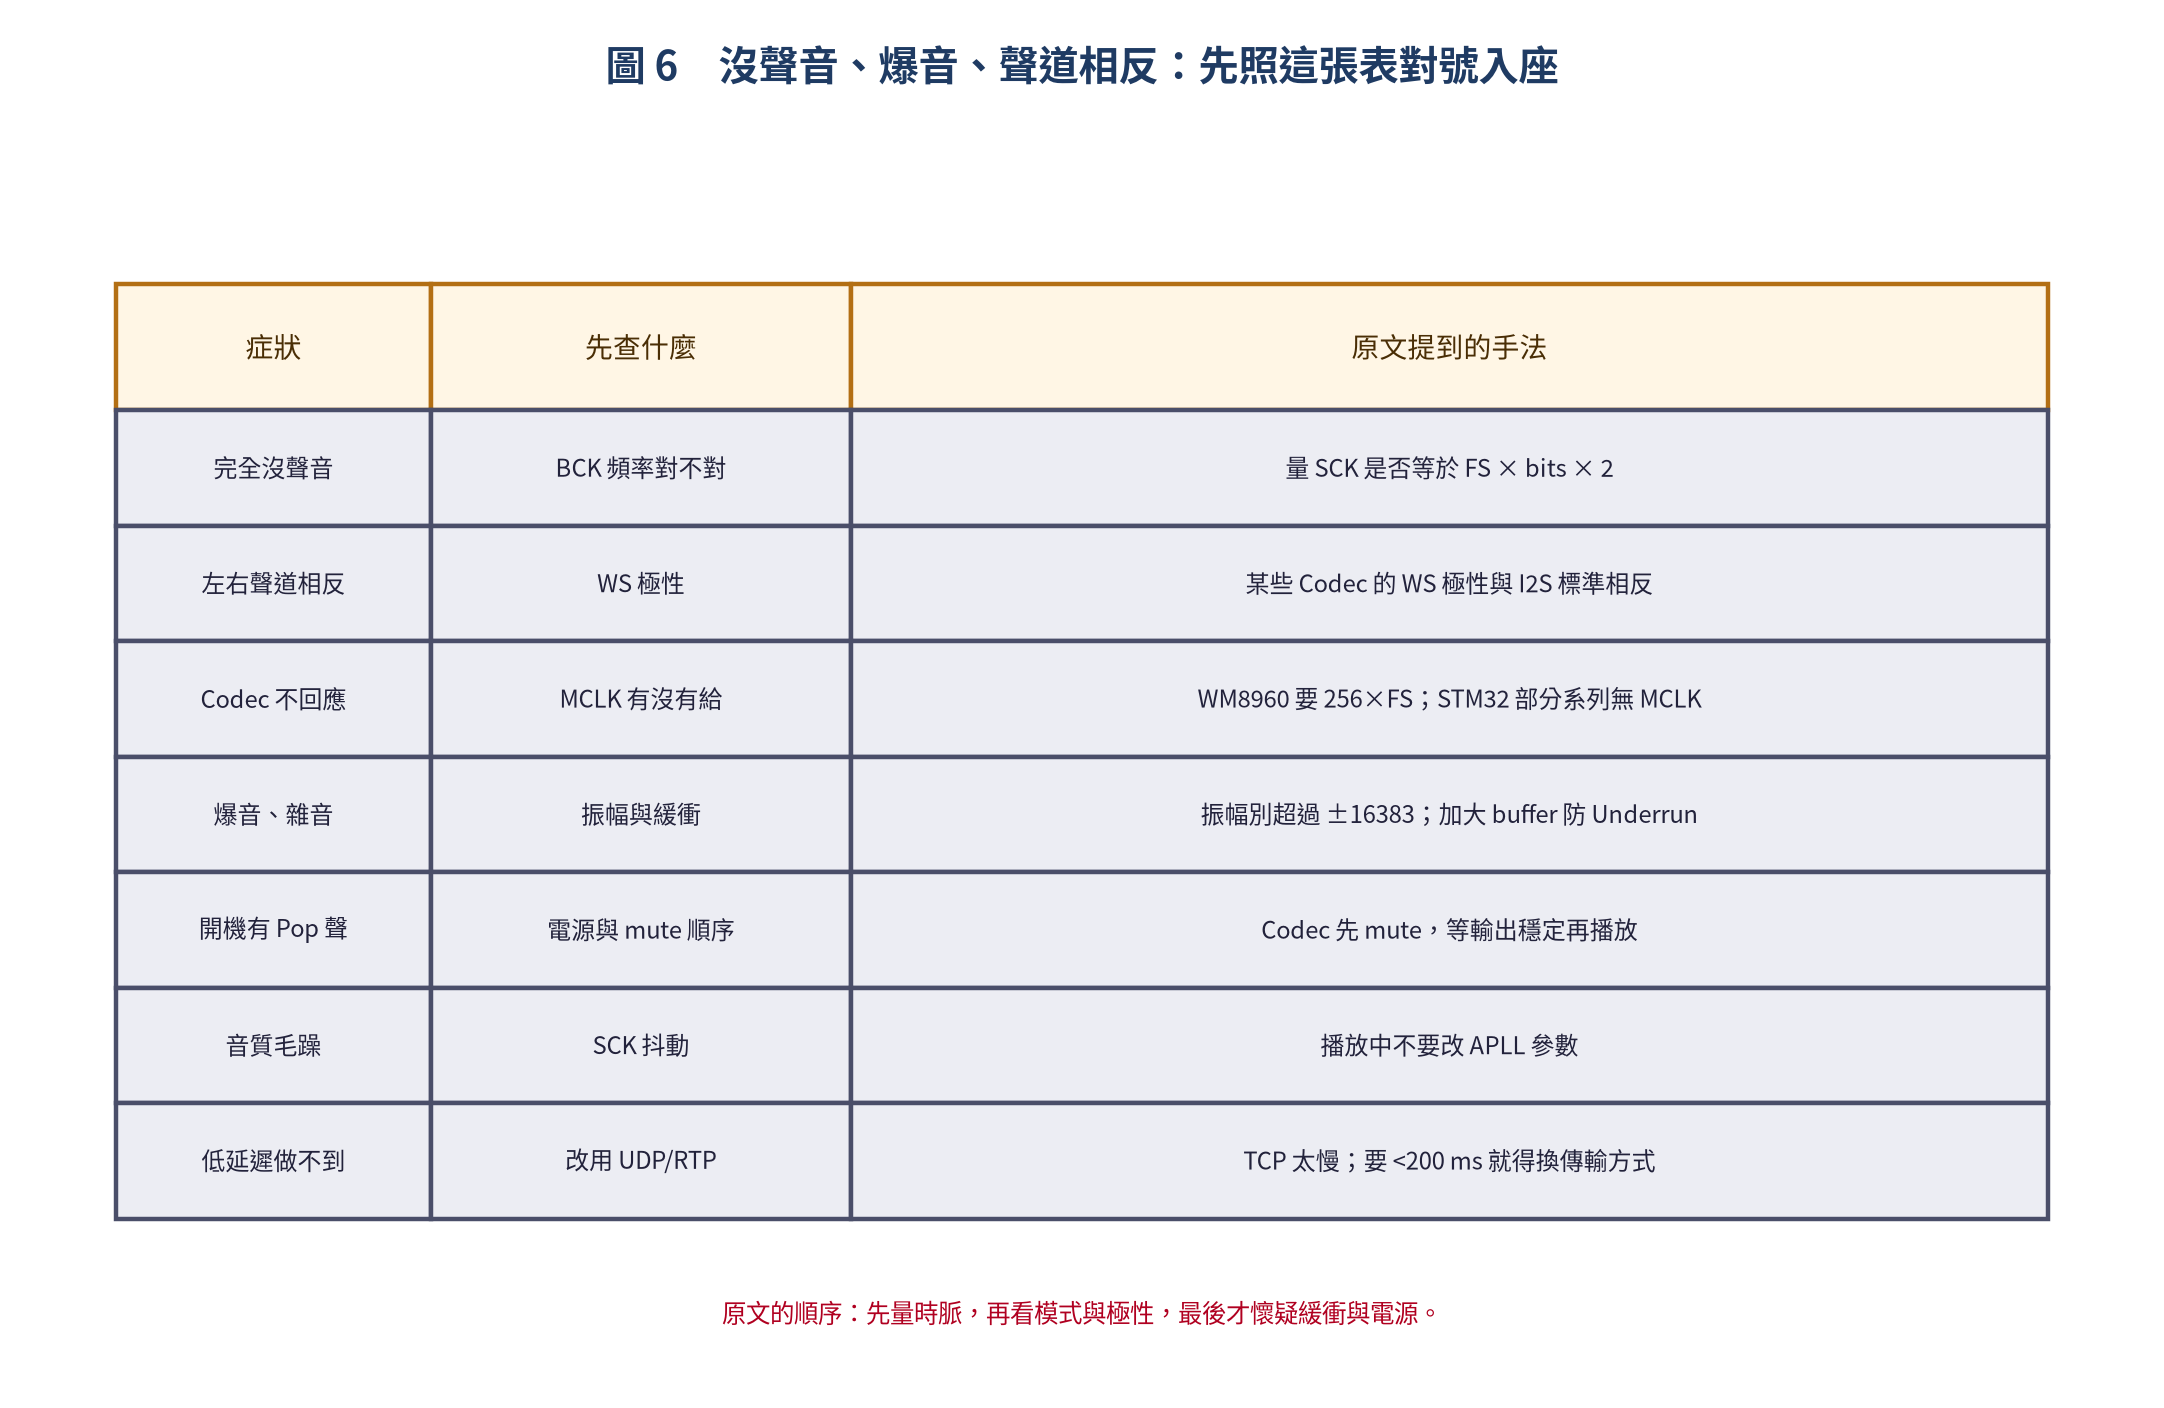
I2S 的除錯其實很線性:先確認時脈有沒有動、再看對齊與極性、最後才懷疑緩衝與電源。我把症狀整理成一張表,出事時直接對號入座:
8.1 沒有聲音?
- BCK 頻率錯誤:用邏輯分析儀或示波器量測 SCK 頻率是否等於 FS × bits × 2
- WS 極性:某些 Codec 的 WS 極性與 I2S 標準相反(如左聲道=1),程式需設定 WS polarity
- MCLK 缺失:Codec 需要 MCLK 但未提供,某些 Codec 可配置為不使用 MCLK
- I2S 模式不符:Codec 是 Left-Justified 但程式設成 I2S Philips
這四項的排查成本差很多:量 SCK 只要一支示波器,10 秒就有答案;懷疑模式則是回頭翻 datasheet。所以我永遠從第一項開始。
8.2 爆音或雜音
- 音量太大:正規化振幅不要超過 ±16383(16-bit),保留 headroom
- Pop Noise:Codec 電源開啟時先 mute,等輸出穩定後再播放
- Buffer Underrun:I2S 寫入速度趕不上播放速度,加大 buffer 或改善 Wi-Fi 延遲
- 時脈抖動:I2S 對 SCK 抖動敏感,避免在 I2S 正在播放時改變 APLL 參數
第三項的診斷方式很簡單:如果你的爆音是「週期性」的,幾乎就是 Underrun;如果是「隨機的雜訊」,那比較像是時脈或電源的問題。
8.3 I2S DMA 配置(STM32)
聲音要連續,就不能靠 CPU 一直輪詢、一直手動搬資料 —— 那正是 DMA 傳輸要解決的問題:
// I2S + DMA 循環模式播放
#define BUF_SIZE 512
uint16_t audio_buf[BUF_SIZE];

// 初始化 DMA
__HAL_LINKDMA(&hspi2, hdmatx, hdma_tx);

// DMA 傳輸完成回呼
void HAL_SPI_TxCpltCallback(SPI_HandleTypeDef *hspi)
{
    if (hspi->Instance == SPI2)
    {
        // 填寫下一段音訊資料到 audio_buf
        fill_next_buffer(audio_buf, BUF_SIZE);
    }
}

// 啟動 DMA 循環播放
HAL_SPI_Transmit_DMA(&hspi2, (uint8_t *)audio_buf, BUF_SIZE);
整個循環的邏輯我畫成流程圖:
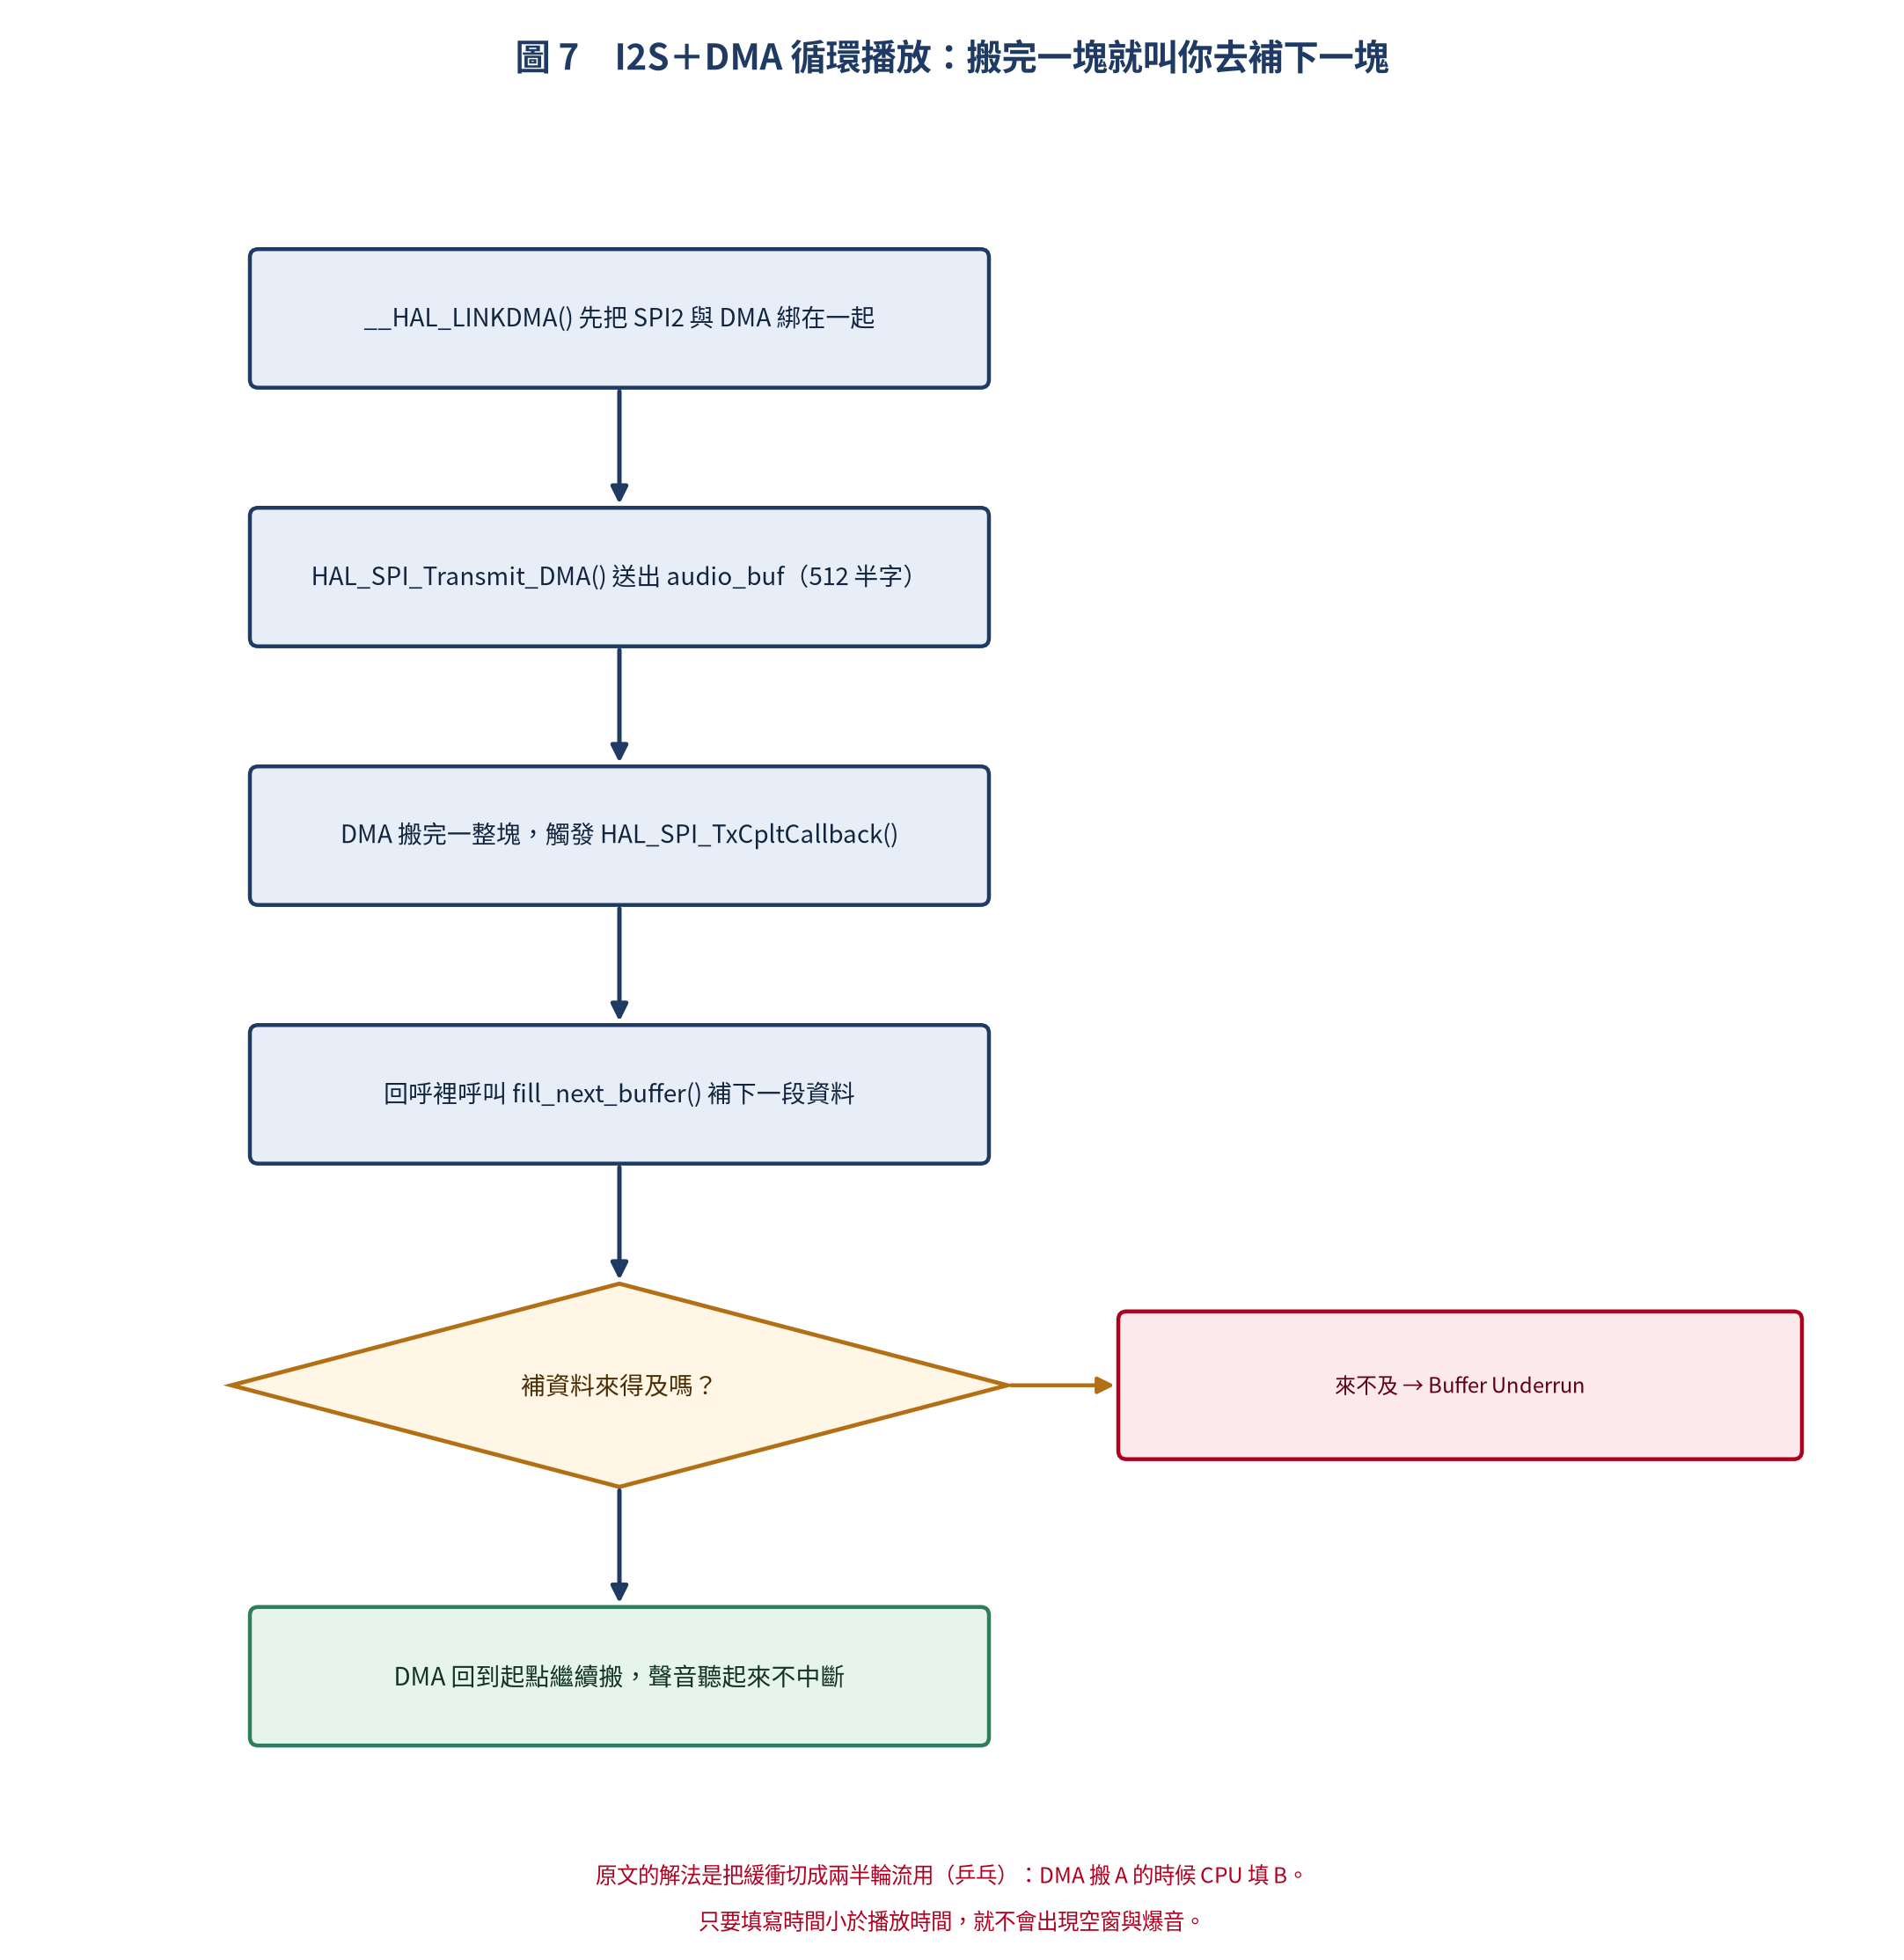
這裡有個很容易被忽略的重點:DMA 幫你省掉的是「搬資料」,不是「準備資料」。真正決定聲音連不連續的,是你在回呼裡補得夠不夠快。緩衝越大越安全,但延遲也越高 —— 這就是音訊工程裡永遠的兩難。
九、總結
I2S 通訊協定是嵌入式音訊開發的必備技能。從簡單的 MEMS 麥克風錄音到高品質音訊串流,I2S 提供了專為音訊設計的可靠傳輸協定。重點回顧:
- 時序核心:MSB First + WS 延遲 1 SCK(I2S Philips)
- SCK 計算:FS × bits × channels;64×FS 是最常見配置
- 硬體考慮:MCLK 需求、電壓位準、BCK 上限
- 程式實作:ESP32 Arduino/ESP-IDF 與 STM32 HAL 都有完善支援
- 除錯方法:量測 SCK 頻率、檢查 WS 極性、觀察 DMA 狀態
無論是做語音辨識、藍牙音箱、還是音訊分析,I2S 都是你不可或缺的工具。
回顧整篇,我最想留下來的一句話是:I2S 的難點從來不在「傳什麼」,而在「什麼時候傳」。把時脈、聲道、對齊這三件事分別確認過一遍,剩下的就只是照公式填參數而已。

文章評論